OpenClaw入门:多渠道AI代理网关与自动化工作流详解
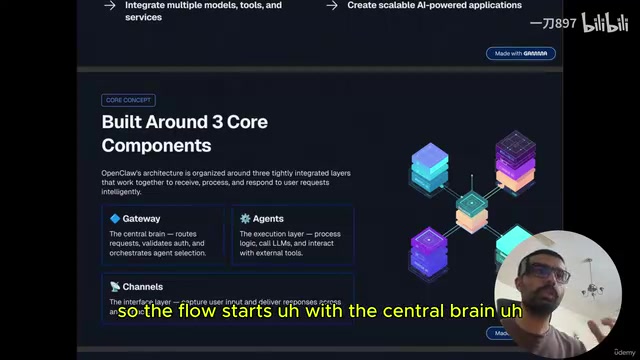
OpenClaw是可自托管的AI代理网关,通过网关、代理、渠道三层架构统一编排多平台AI工作流。
OpenClaw是一个开源、可自托管的AI代理网关与编排平台,核心价值在于将WhatsApp、Telegram、Discord、Slack等碎片化的消息渠道与多种AI模型(包括本地的Ollama和云端的OpenAI、Anthropic、Gemini等)整合进一套统一的可编排系统。其架构由三大组件构成:网关负责智能路由、认证与负载均衡,是整个系统的调度中枢;代理是执行具体任务的可复用单元,支持RAG、MCP、任务自动化等多种类型;渠道则是多平台的用户接入层。在此基础上,工具机制让代理能够操作外部服务(如Gmail、Google Drive、数据库),而内置的长短期记忆机制则保障了跨会话的上下文连贯性,使AI助手具备真正可用的持续智能。
OpenClaw正在成为AI代理领域备受关注的开源项目。它是一个可自托管的网关,能够把WhatsApp、Discord、Slack、Telegram等多个消息平台连接起来,充当AI助手的"中枢神经系统"。这篇教程性质的内容拆解了OpenClaw的核心架构与工作原理,帮助开发者理解如何用它来编排多个AI代理、构建可扩展的自动化工作流。
OpenClaw是什么
简单来说,OpenClaw是一个AI代理网关与编排平台。它是面向AI代理的多渠道网关,可以在任何操作系统上运行——无论是macOS、Linux还是Windows,OpenClaw都能跑起来。
它给开发者和用户的能力是:创建一个可以从各种消息平台访问的个人AI助手。可以把它理解成"API网关 + AI自动化的大脑"这两者的结合体。
OpenClaw能做的事情包括:构建和管理AI代理、集成多种模型(既支持Ollama这类开源本地模型,也可以通过API接入Anthropic、OpenAI、Google Gemini等大语言模型),并在此基础上创建可扩展的AI应用。这种模型无关的设计,让它能够灵活适配不同的成本和隐私需求。
Ollama 是一个用于在本地设备上运行开源大语言模型的工具,支持Llama、Mistral、Gemma等主流开源模型,用户无需将数据发送到云端即可完成推理。它极大降低了本地部署LLM的门槛,只需几条命令即可在笔记本电脑上运行一个完整的语言模型。OpenClaw集成Ollama,意味着整个AI代理系统可以在完全离线、数据不出本地的环境中运行,对隐私敏感的个人用户或企业场景具有重要价值。与此相对,OpenAI、Anthropic(Claude)、Google Gemini等则是通过云端API提供服务,推理能力更强但数据会经过第三方服务器,需要在能力与隐私之间做出权衡。
三大核心组件:网关、代理与渠道
OpenClaw围绕三个核心组件构建:网关(Gateway)、代理(Agents)和渠道(Channels)。
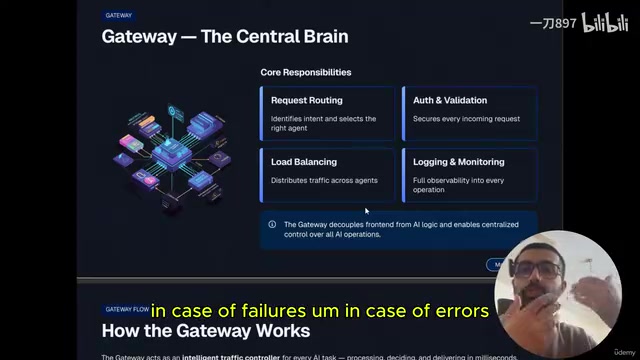
网关是整个系统的中枢大脑,也是OpenClaw最关键的特性。所有流程都从这个中央大脑开始,它负责路由用户请求、进行验证与身份认证,并根据用户请求智能地决定把请求交给哪个代理处理。网关按不同的层次组织,每一层都有各自的职责。
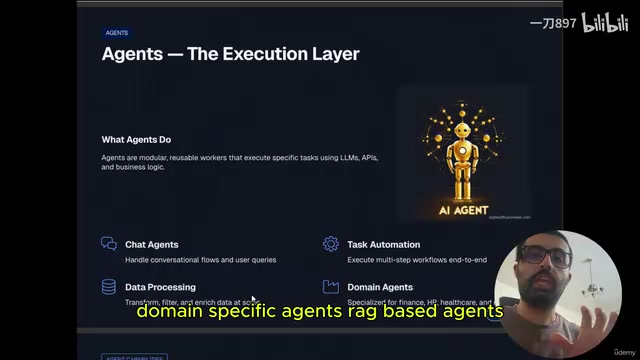
代理是可复用的执行单元,它们利用大语言模型、API调用和你编写的业务逻辑来执行特定任务。代理的类型很丰富:聊天代理、任务自动化代理、数据处理代理、特定领域代理、基于RAG的代理,以及自定义MCP代理等。这些代理是搭建自动化流程的"积木",你可以据此决定哪些手动流程值得自动化。
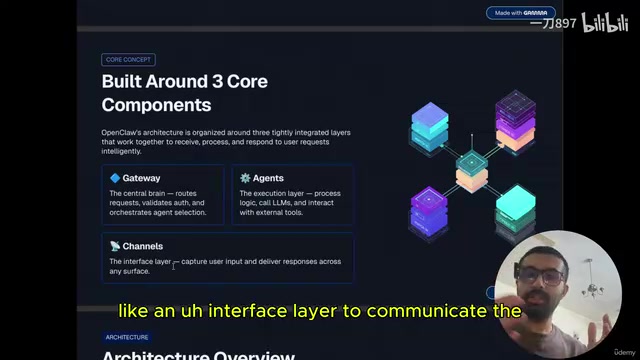
渠道是接口层,是捕获用户输入并转发给网关的入口点。它通过统一的界面呈现整个处理过程。渠道可以是Telegram、WhatsApp、Discord、Slack等,它们通过WebSocket、HTTP请求、REST API等方式与系统连接。
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种将信息检索与大语言模型生成能力相结合的技术架构。其核心思路是:在模型生成回答之前,先从外部知识库(如文档、数据库)中检索与问题相关的内容片段,再将这些片段作为上下文一并传入模型,从而让模型的回答基于最新、最准确的私有数据,而非仅依赖训练时固化的参数知识。这对于企业场景尤为重要——公司内部文档、产品手册、客户数据等信息无法预先训练进模型,RAG提供了一种低成本的"外挂知识库"方案。OpenClaw中的RAG代理正是利用这一机制,让AI助手能够回答基于本地或私有数据源的专业问题,而无需对模型本身进行微调。
网关如何运作
网关本质上是一个AI编排器,把不同请求路由到代理、CLI、Web控制、IO节点等不同的节点。每个节点各司其职。
网关的核心职责包括:
- 请求路由:识别意图并选择正确的代理
- 认证与验证:确保请求合法
- 负载均衡:在多个代理之间分配流量
- 日志与监控:记录请求,便于在出现故障或错误时进行分析
网关的工作流程可以拆成六步:接收(receive)、识别(identify)、选择(select)、转发(forward)、收集(collect)、返回(return)。它就像一个智能的交通调度员。
举个例子:当你从WhatsApp或Telegram发送一句"我想给一家营销公司发10封邮件",网关会先接收这条来自渠道的请求,然后理解其中的意图和上下文,接着选择合适的代理(比如邮件营销代理),把请求转发过去,最后收集执行结果并返回给用户。
工具与记忆:让代理更强大
除了三大核心组件,OpenClaw还依赖**工具(Tools)**来扩展大语言模型的能力。你可能听说过函数调用、工具调用、MCP等概念。工具其实并不复杂——它就是你连接到AI代理上的各种外部能力,比如接入Google Drive、Gmail、本地MCP服务器、本地数据库、邮件系统等第三方资源。工具让大语言模型得以突破"只能对话"的限制,真正去操作现实世界的服务。
另一个关键点是记忆机制。OpenClaw支持长期记忆和短期记忆,让代理能够记住上下文和对话内容。这意味着当你第二天打开OpenClaw实例时,它依然能记得前一天的上下文,从而实现真正连贯的智能工作流。
MCP(Model Context Protocol) 是由Anthropic于2024年底提出的开放协议,旨在标准化大语言模型与外部工具、数据源之间的连接方式。可以把它理解为AI世界的"USB接口"——有了统一的协议标准,开发者无需为每个工具单独编写集成代码,AI代理就能以一致的方式调用文件系统、数据库、API服务等各类资源。OpenClaw中提到的"自定义MCP代理"正是基于这一协议构建,使代理能够以即插即用的形式接入符合MCP规范的工具服务器。与传统函数调用相比,MCP提供了更强的工具发现能力和更规范的上下文传递机制,是当前AI代理生态中快速普及的互操作性标准。
为什么值得关注
OpenClaw的价值在于把碎片化的AI能力整合成一套可编排的系统。它的三个组件——网关、代理、渠道——分工明确:网关做智能路由与治理,代理做具体任务执行,渠道负责多平台接入。
借助它,开发者可以:创建AI自动化工作流、把手动流程自动化、集成基于提示工程和微调的自定义代理、接入业界最先进的大语言模型作为代理的"大脑",并利用记忆能力保持上下文连贯。
对于想要构建个人AI助手或企业级自动化系统的开发者而言,OpenClaw提供了一个清晰的架构范式。后续实践中,可以尝试在自己的实例上安装OpenClaw,并通过Telegram、Slack、Discord等渠道来体验这些AI代理工作流的实际效果。
相关推荐
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。
全盲创业者靠Claude做出无障碍产品,卖出1700美元
一位全盲创业者用 Claude 为盲人客户打造无障碍产品并卖出 1700 美元。他的经历揭示了 Vibe Coding 的真相:AI 能写代码,但真正的好体验离不开领域知识,也展现了 AI 赋能残障人群自主构建工具的独特价值。
Datamimic:给AI编程助手一个可控的测试数据世界
Datamimic 是一款开源工具,主张不要让AI编程助手自行编造测试数据。本文解析AI生成测试数据的可靠性隐患,以及可控测试数据世界对开发质量的价值。