Pinku:iPhone和Mac上离线运行的私密AI聊天工具

Pinku基于苹果MLX框架在iPhone和Mac上本地运行开源大模型,以无服务器架构实现真正私密的离线AI聊天。
Pinku是一款在Product Hunt获得#20排名的隐私优先AI聊天工具,核心卖点是完全离线运行。它利用苹果MLX框架在iPhone、iPad和Mac上本地推理Llama、Qwen、Gemma等开源模型,下载一次后即使飞行模式也能对话。产品无账户、无服务器,聊天数据永不离开设备,隐私由架构而非政策保证。代价是模型规模受限于设备算力,回答质量不及云端旗舰模型,且缺乏跨设备同步。免费起步模式瞄准对数据敏感的专业用户、断网环境工作者和技术爱好者,代表了端侧AI从云端拉回本地的重要趋势。
当AI聊天不再需要云端
大多数AI聊天工具的工作原理很简单:你的问题被发送到某个远程服务器,由服务器上的大模型生成回答,再把结果传回你的屏幕。这个过程中,你的对话内容经过了网络传输,也留在了别人的服务器上。对于处理敏感信息、商业机密或者纯粹在意隐私的用户来说,这条链路本身就值得警惕。
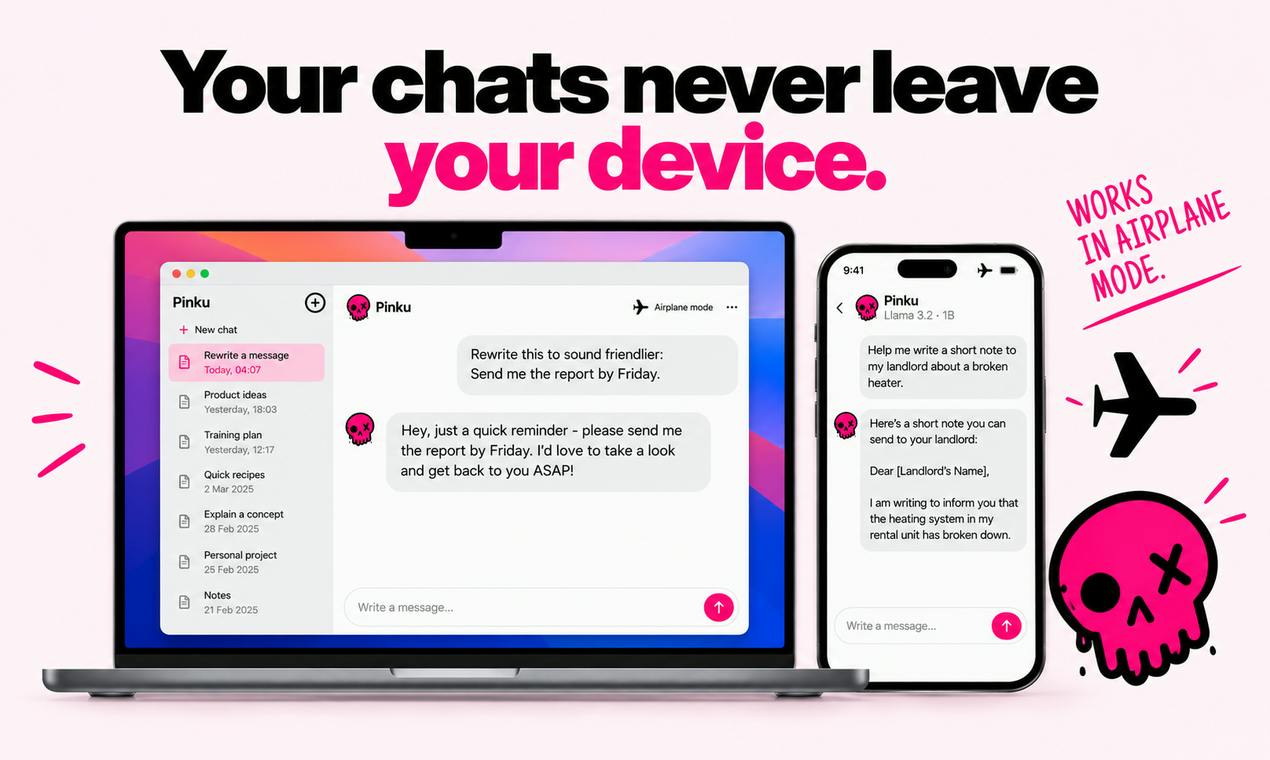
Pinku 选择了一条完全不同的路径。这款在 Product Hunt 上获得 #20 排名的产品,核心主张只有一句话:私密AI聊天,在你的 iPhone 和 Mac 上离线运行。
本地推理怎么做到“飞机模式也能聊”
Pinku 的技术底座是苹果的 MLX 框架——苹果为自家芯片(M系列及A系列)提供的机器学习数组计算框架。借助 MLX,Pinku 可以在 iPhone、iPad 和 Mac 上直接运行开源模型,包括 Llama、Qwen 和 Gemma 系列。
使用流程并不复杂:下载一次模型,之后就可以完全离线对话。原文明确提到,即使开启飞行模式,聊天功能依然可用。这意味着推理过程全部发生在设备本地,不依赖任何网络连接。
这背后的取舍也很清楚。本地运行意味着模型规模受限于设备的内存和算力,不可能像云端那样动辄调用千亿参数的巨型模型。Pinku 支持的 Llama、Qwen、Gemma 都属于相对轻量的开源模型家族,在端侧设备上能跑起来,但回答质量和复杂推理能力与云端旗舰模型之间会有差距。这是所有端侧AI方案共同面对的现实。
MLX 的独特之处在于其统一内存架构(Unified Memory Architecture)。苹果 M 系列和 A 系列芯片的 CPU 与 GPU 共享同一块物理内存,数据无需在两者之间复制传输,这大幅降低了推理延迟和功耗。MLX 专为这一架构设计,采用惰性计算图(lazy computation)和函数式数组操作,能自动优化内存使用。此外,MLX 支持模型量化——将模型权重从 16 位浮点压缩到 4 位或 8 位整数,在几乎不损失精度的前提下将模型体积缩小数倍,这是让 7B 参数模型能在 iPhone 上运行的关键技术。
文中提到的 Llama、Qwen、Gemma 是三个不同的开源模型家族。Llama 由 Meta 发布,是目前生态最活跃的开源模型系列之一;Qwen(通义千问广告)来自阿里,在多语言和中文任务上表现突出;Gemma 则是 Google 基于 Gemini 技术推出的轻量级开源模型。这些模型通常以 7B(70 亿)到 70B(700 亿)参数规模发布,但端侧部署通常选用 1B-8B 的小尺寸版本,并经过 4-bit 量化压缩,才能在手机内存(通常 8-12GB)限制内运行。
隐私不是功能,是架构
Pinku 的隐私承诺不是靠一纸政策条款,而是由架构本身保证的。原素材写明:没有账户体系,没有服务器,聊天记录永远不会离开你的设备。
这个设计和市面上大多数AI产品形成鲜明对比。云端AI服务即便声称不用于训练、定期删除,数据终究要经过服务商的管道。Pinku 的做法是从物理上消除了这条管道——没有服务器可传,数据自然无从泄露。
代价是同步和跨设备体验的缺失。由于没有账户,你在 iPhone 上的对话不会自动出现在 Mac 上(除非产品另有本地同步机制,原文未提及)。对于把隐私放在第一位的用户,这个交换是值得的;对于习惯多设备无缝切换的用户,则需要适应。
“无服务器”架构与传统的端到端加密有本质区别。端到端加密虽然能防止传输过程中被窃听,但数据到达服务端后仍需解密处理,服务商理论上仍可访问明文。Pinku 的方案是彻底消除服务端——推理完全在本地完成,没有任何数据离开设备。这属于“数据最小化”原则的极端实践:不收集、不传输、不存储。从合规角度看,这种架构天然满足 GDPR 的“数据保护by design”要求,也规避了跨境数据传输的法律风险。
免费起步,瞄准的是谁
Pinku 采用免费起步(Free to start)的模式,说明产品设计了某种付费升级路径,但原文没有披露具体的定价和功能分层。
从定位来看,Pinku 瞄准的是三类人:一是对数据敏感的专业用户,比如律师、记者、医生,他们的对话内容不适合上传到第三方服务器;二是在网络不稳定或完全断网环境下工作的人;三是单纯想体验本地大模型的技术爱好者。Mac 和 iPhone 的苹果生态用户是它的天然受众,因为 MLX 框架本身就是为苹果芯片优化的。
Product Hunt 上 66 票、3 条评论、排名 #20 的成绩,说明它引起了一定关注,但还远未到爆款的程度。这也符合端侧AI工具当前的普遍处境:概念吸引人,实际体验受限于硬件性能,受众相对小众。
端侧AI的一小步,隐私计算的一大步
Pinku 本身不是一个颠覆性的产品,但它代表了一个值得关注的方向:把AI能力从云端拉回本地。随着苹果芯片的神经网络引擎逐年增强,以及开源模型在量化压缩上的持续进步,端侧能跑的模型会越来越强。今天 Pinku 能离线跑 Llama 和 Qwen,明天端侧模型的回答质量可能就逼近云端的中端模型。
对于普通用户,Pinku 现在更像是一个隐私优先的备用选项;对于整个行业,它是一块探路石——证明了不依赖服务器、不收集账户信息的AI聊天,在消费级硬件上是可以成立的。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。