强化学习训练LLM:用"永不放弃"策略攻克难题
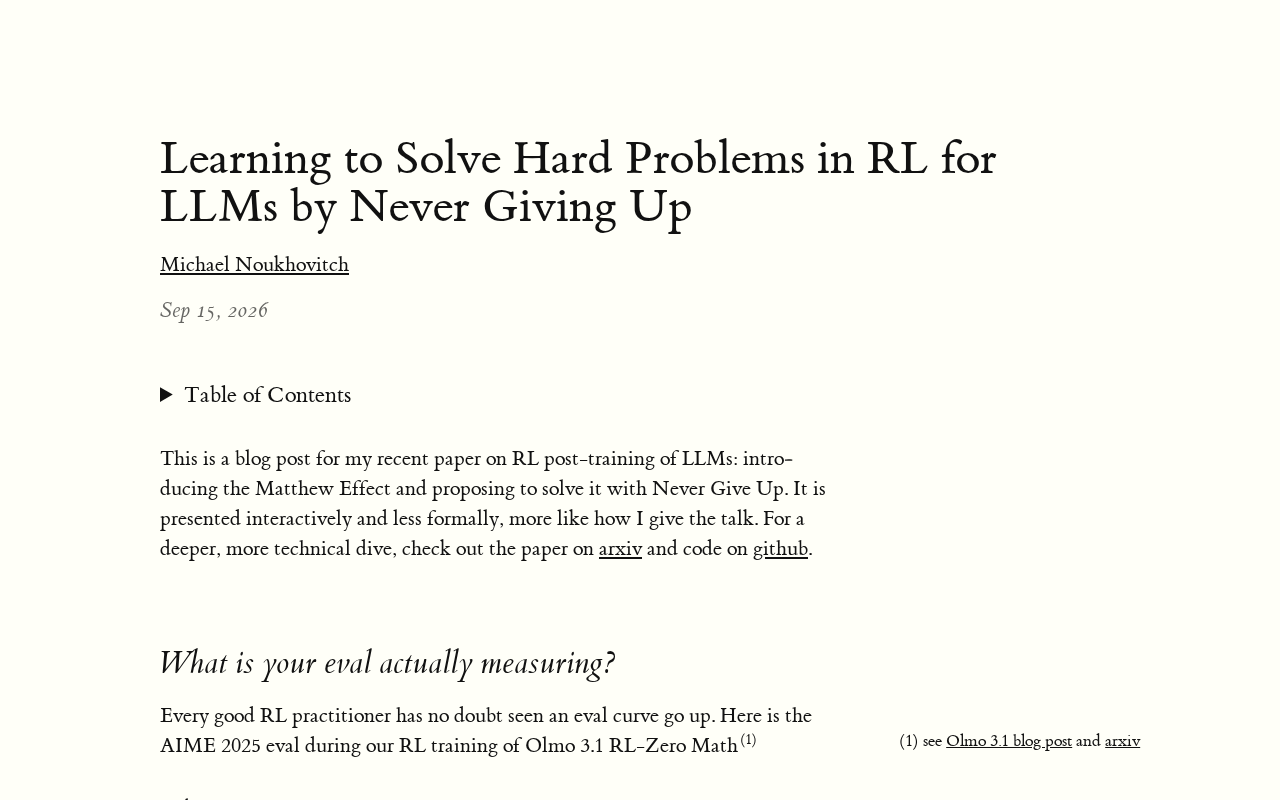
研究提出让LLM在RL训练中"永不放弃"难题,通过持续探索与放大稀疏正例突破推理能力天花板。
大语言模型的强化学习训练存在一个系统性缺陷:高难度问题因模型几乎无法产生正确答案而缺乏奖励信号,梯度更新趋近于零,导致训练过程自然偏向中等难度任务,最难的问题被持续忽视。本文介绍的研究提出"永不放弃"训练策略,主张通过增加对难题的采样预算、放大偶发性稀疏正例的学习价值,以及课程式难度推进等机制,让模型持续在高难度问题上积累有效梯度信号。这一思路借鉴了DeepMind提出的NGU探索算法,本质上是在RL的探索-利用平衡中向探索端积极倾斜。随着复杂推理成为AI能力竞争的核心战场,该方向对解决数学证明、多步逻辑推理等硬任务具有重要意义,但具体技术细节与实验效果仍需参阅原始论文。
引言:LLM强化学习中的"畏难"困境
在大语言模型(LLM)的强化学习(RL)训练过程中,一个长期存在的挑战是模型面对高难度问题时的表现。当模型在训练早期反复失败于某类困难任务时,标准的RL算法往往会"绕开"这些问题,转而在容易获得奖励的简单任务上不断强化。这种现象导致模型在真正需要深度推理的难题上停滞不前。
这篇在Hacker News上被讨论的研究(标题为《Learning to solve hard problems in RL for LLMs by never giving up》)提出了一个直观而有价值的方向:让模型学会"永不放弃",持续攻克那些最初无法解决的难题。
为什么难题在RL训练中容易被"抛弃"
强化学习的核心是通过奖励信号引导模型行为。对于LLM而言,如果一个问题过于困难,模型在采样过程中几乎无法产生正确答案,也就无法获得正向奖励。缺乏奖励信号意味着梯度更新对这类问题几乎没有贡献。
结果是,训练过程会自然地偏向那些模型"能够解决"的中等难度问题——这些问题既能提供有效的学习信号,又不至于让模型完全无从下手。而最难的那部分问题,恰恰是我们最希望模型能够攻克的,却在训练中被系统性地忽视。
这一困境类似于人类学习中的"舒适区"陷阱:如果只做能做对的题目,能力提升会遇到天花板。
从算法层面看,这一现象与GRPO、PPO等LLM常用RL算法的梯度估计方式密切相关。这些算法依赖蒙特卡洛采样来估计策略梯度:若某道难题在数百次采样中全部失败(pass@k ≈ 0),奖励方差为零,梯度信号几乎消失,参数更新量趋近于零。这与"死亡神经元"问题有一定类比——网络在某个区域彻底失去梯度流动后,该区域的学习能力就此僵死。训练批次的构成也会加剧这一问题:如果一个批次中包含大量难题,整体梯度估计的方差大幅上升,优化器倾向于缩小更新步长,进一步削弱对难题的学习。这也解释了为什么仅靠增大模型规模或延长训练时长,并不能自动解决"硬题盲区"问题——根本原因在于信号本身的缺失,而非计算资源不足。
"永不放弃"的核心思路
该研究标题中的"never giving up"(永不放弃)指向了一种训练理念:即便模型在困难问题上初期成功率极低,也要通过某种机制持续投入探索,而非放弃。
这一思路可能借鉴了强化学习经典探索算法中的相关思想(如DeepMind早年提出的"Never Give Up"探索方法),核心在于:
保持对难题的持续探索
通过增加对困难样本的采样预算、延长探索时间,或引入内在激励机制,让模型有更多机会在难题上"偶然"产生正确答案,从而获得可用于学习的奖励信号。
DeepMind于2020年提出的"Never Give Up"(NGU)算法是这一思路的重要先驱,值得专门说明。NGU的核心机制是将外部奖励与两种内在奖励叠加:一是基于情节内(episodic)新奇度的短期奖励,利用嵌入空间中的k近邻距离衡量当前状态是否在本轮轨迹中首次访问;二是基于生命周期(life-long)新奇度的长期奖励,使用随机网络蒸馏(RND)估计某状态在整个训练历史中的访问频率。这两种奖励叠加后,能够驱使智能体对"历史上很少被访问的状态"保持持续好奇心,从而走出局部最优的探索陷阱。将这一机制迁移至LLM的RL训练时,面临的挑战在于语言空间的离散性与高维性——如何定义"LLM解题轨迹"的新奇度,是论文核心需要回答的工程问题。
利用稀疏正例进行放大学习
即使成功率极低,一旦模型偶尔解决了某个难题,这个稀有的成功样本就具有极高的学习价值。合理的机制可以放大这类稀疏正例的作用,帮助模型逐步稳定地掌握难题解法。
课程式的难度推进
将难题分解或按难度梯度组织训练,让模型在逐步积累能力后再挑战最难的部分,避免一开始就陷入完全无信号的困境。
对LLM推理能力提升的意义
随着推理模型(reasoning models)成为AI发展的重要方向,如何让模型突破自身能力边界、解决真正困难的问题,变得愈发关键。传统方法在简单和中等任务上已经取得不错效果,但在复杂数学证明、多步逻辑推理、代码调试等高难度场景中仍有明显短板。
"永不放弃"式的训练策略,本质上是在解决RL训练中的探索-利用平衡问题。它提醒我们,一个真正强大的推理模型,不应该只在自己擅长的领域打转,而应该具备攻坚克难的持续学习能力。
探索-利用平衡(Exploration-Exploitation Tradeoff)是强化学习的基础性张力:智能体既需要"利用"已知有效策略获取奖励,又需要"探索"未知区域以发现更优解。在LLM的RL后训练场景中,这一张力尤为突出——模型容量有限,训练计算预算固定,过度探索难题会导致整体训练效率下降,而过度利用简单题则会造成能力天花板。目前业界的主流权衡方式包括:按难度对题目进行分层采样(优先级经验回放的变体)、动态调整不同难度题目在批次中的比例、以及在探索阶段临时提高采样温度以增加输出多样性。"永不放弃"策略本质上是在这一权衡中向"探索"端做出更积极的倾斜,其代价与收益的实证数据,是评估该方法实用价值的关键。
结语与思考
需要说明的是,由于当前可获取的原始素材有限(Hacker News上仅有标题和少量讨论热度,尚无详细评论),本文对具体技术细节的分析主要基于标题所揭示的方向以及领域内的常见做法。
这一研究方向的价值在于,它直面了LLM强化学习中一个被普遍观察到却难以解决的问题。对于关注前沿AI训练方法的研究者和工程师而言,"如何让模型不放弃难题"是一个值得深入跟踪的课题。建议感兴趣的读者查阅原始论文以获取完整的实验设计与效果验证。
相关推荐
Claude Code与Codex企业级实战:AI工程化编程如何搞定复杂项目
从氛围编程到AI工程化编程,本文解析Claude Code与Codex企业级项目实战:三种开发模式递进、国产大模型选型、SuperPower插件流程,以及Open Router聚合平台背后的AI行业盈利逻辑。
开源桌面端CC-HAHA上手:让AI自动操作你的电脑
开源桌面客户端 CC-HAHA 新增 computer use 电脑操控功能,让 AI 通过虚拟鼠标自动操作电脑。本文详解三步配置流程、实际效果演示,并分析不同模型在操作电脑能力上的差异与局限。
Claude Code桌面版实操:中文汉化+免登录+接入DeepSeek全攻略
手把手教你安装 Claude Code 桌面版,实现免账号使用、中文汉化,并通过 CC Switch 接入国产模型 DeepSeek,还包含自定义 Skill 导入的完整实操步骤,帮你低成本跑通 Claude Code 工作流。