Qwen Intelligence发布:三大SOTA移动智能体登场
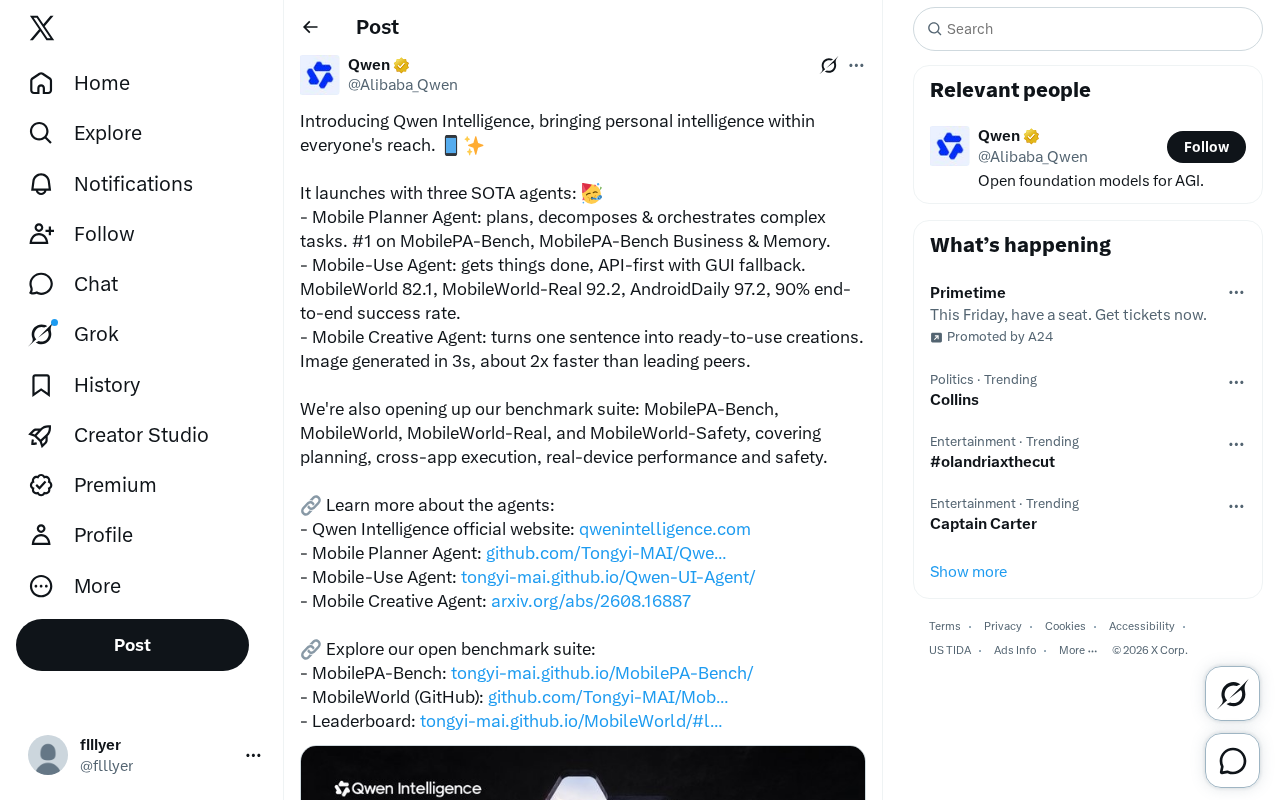
阿里通义发布Qwen Intelligence,三款专职移动智能体覆盖规划、执行与创作,并同步开源移动端评测基准。
阿里通义千问团队推出Qwen Intelligence,一次性发布三款面向移动场景的专职智能体:Mobile Planner Agent负责复杂任务的规划与编排,在多项规划基准上排名第一;Mobile-Use Agent采用"API优先、GUI兜底"策略执行跨应用任务,端到端成功率达90%;Mobile Creative Agent主打创作速度,单图生成约3秒、比同类快约2倍。与此同时,团队开源了涵盖规划、跨应用执行、真机性能与安全性的MobilePA-Bench、MobileWorld等评测基准套件。这一发布既是产品落地,也是对移动Agent评测话语权的布局,反映出大模型能力从对话问答向移动设备实际任务执行延伸的整体趋势。所有数据均来自官方发布,第三方独立验证仍有待跟进。
阿里通义千问团队推出全新的 Qwen Intelligence,主打"让个人智能触手可及"的理念,一次性带来三款面向移动场景的SOTA(业界最佳)智能体,并同步开放了一整套移动端基准测试工具。这标志着大模型能力正从对话问答,进一步向移动设备上的实际任务执行渗透。
三款智能体各司其职
Qwen Intelligence 并非单一模型,而是围绕移动场景拆分出的三个协作型智能体,分别负责"规划"、"执行"与"创作"三个环节。这种分工设计反映了当下Agent技术的一个趋势:单个通用模型难以在所有环节都做到最优,通过任务分解与专职智能体协同,反而更容易逼近实际可用的水平。
Mobile Planner Agent:任务规划与编排
第一款 Mobile Planner Agent 负责复杂任务的规划、拆解与调度。当用户提出一个需要多步骤、跨应用完成的需求时,由它来将其分解为可执行的子任务并统筹编排。据官方数据,该智能体在 MobilePA-Bench、MobilePA-Bench Business 以及 Memory 三项榜单上均排名第一,说明其在任务规划与记忆能力上的表现处于领先位置。
Mobile-Use Agent:真正把事情做完
第二款 Mobile-Use Agent 是负责"动手执行"的角色,采用 API 优先、GUI 兜底的策略——能调用接口就调用接口,无法通过接口完成时再回退到图形界面操作。这种设计兼顾了执行效率与兼容性。
其公布的成绩相当亮眼:MobileWorld 82.1、MobileWorld-Real 92.2、AndroidDaily 97.2,端到端任务成功率达到 90%。其中 90% 的端到端成功率是一个值得关注的指标,因为在真实移动设备上完成跨应用操作,涉及界面变化、弹窗、权限等大量不确定因素,能保持高成功率并不容易。
API优先、GUI兜底的策略在移动Agent领域有其特定含义。API优先是指优先调用应用程序开放的结构化接口(如Android的Accessibility Service或应用自身的开放API),这类调用速度快、状态可预测、不受界面布局变化影响。GUI兜底则指当没有可用接口时,退回到像人类一样"看屏幕、点按钮"的图形界面操作方式,通常依赖屏幕截图识别加坐标点击来完成。两者的最大区别在于稳定性:API调用结果确定,GUI操作则容易受到系统弹窗、深色模式切换、厂商定制UI等因素干扰。这也是为什么端到端成功率能否在长尾应用上保持稳定,是评估此类智能体最关键的实测维度之一。
Mobile Creative Agent:一句话生成成品
第三款 Mobile Creative Agent 定位为创作工具,能将用户的一句话描述转化为可直接使用的成果。官方特别强调了速度优势:单张图像生成约 3 秒完成,比领先同类产品快约 2 倍。对于移动端这种对响应速度极度敏感的场景,生成速度往往直接决定用户体验。
将复杂任务拆分给多个专职智能体协同完成,这种"多Agent架构"(Multi-Agent System)近年来逐渐成为业界应对复杂场景的主流范式。其核心逻辑是:单一大模型在规划推理、工具调用和内容生成上往往需要在参数容量与推理速度之间做取舍,而将不同能力分配给专门优化的子模型,可以让每个环节单独迭代升级,也更便于定位和修复失败案例。代价是系统复杂度增加,智能体之间的信息传递和状态同步成为新的故障点。Qwen Intelligence将规划、执行、创作分设三个智能体,是这一架构思路在移动场景的具体实践。
同步开源的基准测试套件
除了三款智能体,Qwen 团队还开放了一整套移动端基准测试工具,覆盖能力评估的多个维度:
- MobilePA-Bench:聚焦规划能力的评测
- MobileWorld(GitHub 开源):跨应用执行能力
- MobileWorld-Real:真实设备上的性能表现
- MobileWorld-Safety:安全性评估
这套基准从规划、跨应用执行、真机性能到安全性形成了较完整的评测闭环。开放基准的意义在于,它让外界能够以统一标准横向比较不同移动智能体的能力,而不仅仅依赖厂商自报的数字。当然,这些基准由发布方自己提出,其权威性仍需社区在后续使用中检验。
值得注意的是,移动端基准测试的构建难度远高于纯文本或代码类评测。真实设备测试(如MobileWorld-Real)需要在物理或模拟设备上运行完整的应用交互流程,测试环境难以标准化——不同机型、Android版本、应用版本都可能影响结果。这也是为什么业界此前缺乏公认移动Agent基准的主要原因。由模型发布方主导制定基准是当前大模型领域的普遍现象,类似情况也出现在OpenAI的SimpleQA、Google的BIG-Bench等评测中。社区通常需要数月时间通过复现实验和对抗性测试,才能形成对某套基准客观性与覆盖完整性的共识判断。
移动智能体赛道的意义
从行业视角看,Qwen Intelligence 的发布延续了2026年大模型"从答问走向行动"的整体方向。相比在电脑端运行的Agent,移动智能体面临更碎片化的应用生态、更受限的接口权限和更复杂的交互方式,落地难度更高,但也更贴近普通用户的高频使用场景。
将规划、执行、创作三类能力分别做成专职智能体,再配套开源基准,这套组合拳既是产品发布,也是对整个移动Agent评测体系的一次话语权布局。对开发者和研究者而言,可以关注的重点在于:这些公布的基准分数能否在自己的场景中复现,以及 API 优先、GUI 兜底的执行策略在长尾应用上的实际稳定性。
需要说明的是,本文数据均来自官方发布信息,实际表现仍有待第三方独立测试与真实用户反馈验证。
相关推荐
临床AI治理难题:Concurrence如何用Unity Gateway管控万亿Token规模
临床AI几乎没有容错空间。本文解析 Concurrence 如何借助 Unity Gateway 在万亿Token规模下治理医疗AI,实现访问控制、合规审计与可观测性的统一,探讨医疗AI规模化落地的治理路径。
让轮询 Agent 真正 7×24 运行:从会话内定时到外部调度
轮询 Agent 只在笔记本会话开着时才运行?本文解析如何用 cron、systemd timer、Task Scheduler 等外部调度器让 Agent 真正 7×24 运行,并通过硬性超时、错误退避与心跳告警避免静默失败。
幂等键难题:如何处理API重试中的“僵尸进程”
发送邮件不是幂等操作,API 重试时如何避免重复发送?本文剖析基于幂等键的抢占声明机制,以及进程崩溃导致“死亡持有者”这一分布式系统经典难题的权衡与解决思路。