Qwen4架构预览已开源:125B参数、512专家,专为显存受限硬件设计

Qwen4仍在训练未发布,其架构已通过Qwen3.8 Flash Next预览开源。
文章核实了Qwen4的发布状态:官方仅在云西大会提及名称,Hugging Face上Qwen4仓库为零,网传“已发布”均属传闻。真正可用的是8月26日发布的Qwen3.8 Flash Next,官方称其为Qwen4架构的早期预览。其config.json显示125B总参数、每Token仅激活6B、512个专家、原生262K上下文,训练成本为上一代九分之一。四项改动——GDNA/QSA注意力、四分支残差、Ngram嵌入、Moong优化器——均指向显存受限硬件优化,其中Ngram表需单独47.7G文件,靠主机内存拖底,实测24G空闲内存即可运行,延迟稳定9.1毫秒。文章最后给出三条核实要点与判断真发布的三处同现标准。
发布状态:官方仅确认“正在训练”
关于“签问4”(即Qwen4)的发布状态,网络上的说法非常混乱。经过对官方信息的核实,目前能确认的只有一条:Qwen4仍在训练中,尚未发布。
据B站UP主在视频中梳理,官方在“云西大会”上发布了芯片、同传音频和视频模型,但Qwen4只出现了名字,没有公布具体发布日。官方稿件中提到了Max、Flash、Plus、27B等型号名称,但没有列出35B A3B等规格,因此这些只能算“半确认”。
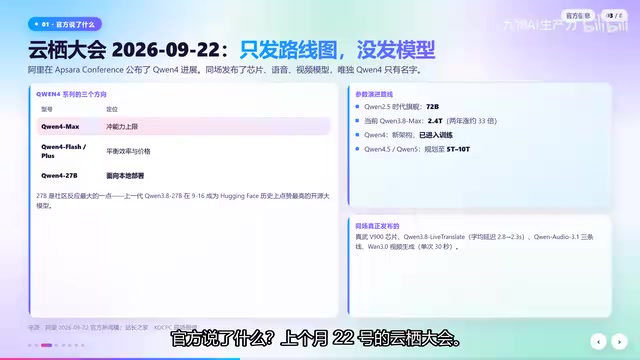
如何自己核实?UP主给出了一个简单方法:在Hugging Face搜索Qwen4官方仓库,目前结果为0个。这个“零结果”本身就是最直接的信号——没有权重,就没有真正发布。
架构预览:Qwen3.8 Flash Next透露了什么
虽然Qwen4本体还没来,但它的架构已经以“早期预览”的形式放出来了。8月26日发布的Qwen3.8 Flash Next,官方明确表示这是Qwen4所用架构的早期预览。对于关注本地部署的开发者来说,这份config.json值得细看。
核心规格:125B总参数,每Token仅激活6B
从config.json中可以直接读到几个关键指标:
- 主模型125B参数,但每个Token只激活6B
- 512个专家(MoE架构)
- 原生上下文262K
- 训练成本仅为上一代的九分之一
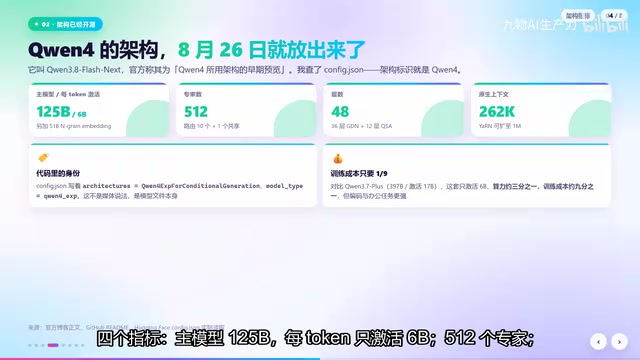
这组数字背后是一个明确的取向:为显存受限的硬件做设计。125B的体量放在以往需要多卡并行,但6B的激活量意味着推理时对显存的需求大幅降低。
MoE(混合专家)架构是理解这组参数的关键。传统稠密模型推理时每个Token都要过全部参数,而MoE把前馈层拆成多个“专家”子网络,由路由网络为每个Token只挑选少数几个专家参与计算。因此“总参数”衡量模型容量与知识储备,“激活参数”才决定单次推理的算力与显存开销。125B总参数配6B激活,意味着模型体量很大,但每个Token实际参与运算的权重只有约6B,显存占用和延迟接近一个6B级模型。代价是全部专家权重仍需加载进内存,这也是后文Ngram表与主机内存方案要解决的问题。512个专家的粒度较细,路由更灵活,但对负载均衡和通信调度的要求也更高。
四项架构改动,都指向“省显存”
官方说明架构改了四个方面,UP主逐一进行了解读:
注意力机制:四成注意力中,三成使用GDNA,剩下一成用QSA做精确检索。QSA按微块而非按Token选择内容,连索引开销一起省掉。
残差连接:单条残差扩展成四条分支,实测中有一条会自发变成长程通路。
嵌入层:最反常规的设计——用当前词加前几个词插表,增加了510亿参数却几乎不增加算力,而且可以放在主机内存,完全不占显存。
优化器:换成Moong,顺带发现Batch Size Warmup不再必要,反而省下18.8%的Step。
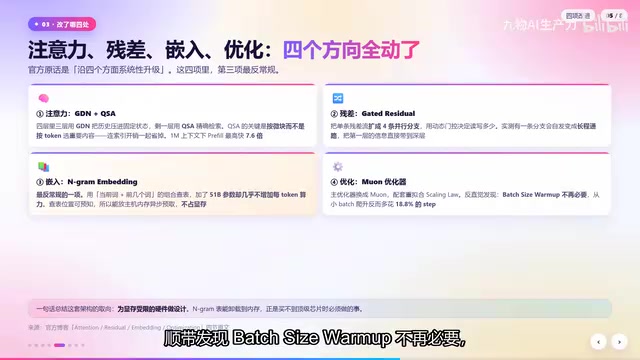
四项改动共同指向一个结论:这套架构在有限显存下追求更高的推理效率,而非单纯堆参数。
注意力机制是Transformer中计算与显存开销随上下文长度快速增长的部分,标准全注意力在262K上下文下需要为每个Token与全部历史Token计算关联,KV缓存也会急剧膨胀。文中提到的GDNA与QSA属于稀疏/选择性注意力思路:只让部分注意力头做全局计算,其余通过块级或检索式选择聚焦少数相关片段。QSA“按微块而非按Token选择”意味着以连续的小块为单位建立索引,索引本身的开销也随块数而非Token数增长,从而在大上下文下同时压低计算量和索引显存。这类设计与MoE的低激活量配合,才使262K原生上下文在消费级显存上具备可行性。
现在能跑吗?可以,但跑的是预览版
Qwen4没有权重,所以没有“Qwen4式”的入口。但目前可以体验的是Qwen3.8 Flash Next这个预览版,它已经驱动了Qwen Studio Chat、Qwen AI以及Qwen Work的Standard模式。
要权重的话,去Hugging Face搜“Qwen3.8 Flash Next”,下载量已达363万。
本地部署门槛:24G空闲内存就能跑
本地部署有一个绕不过去的门槛:那张Ngram表是单独的47.7G文件,比激活的10G还大。社区采用主机内存拖底,实测数据如下:
- 64G内存时,延迟只多6%,最划算
- 压到24G时,只占6G显存,延迟稳定在9.1毫秒
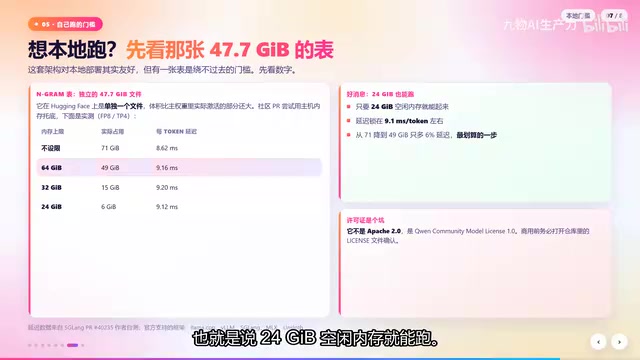
也就是说,24G空闲内存就能跑起来。不过许可证不是Apache 2.0,而是Qwen Community Model License,商用前需要打开确认条款。
Ngram嵌入表可以理解为一张巨大的“词序列到向量”查找表:模型不再只依赖神经网络现算每个词的表示,而是用当前词及前几个词组成的片段直接查表取回预训练好的向量。好处是查表几乎不消耗算力,且表可以常驻主机内存、按需换入,不占显存;代价是表本身体积极大(此处为47.7G),必须依赖足够的内存或高速存储。这也解释了实测中64G内存延迟仅增6%、压到24G仍能维持9.1毫秒的原因——瓶颈从显存转移到了内存带宽与换页效率。
三个核实要点与判断方法
结合UP主的总结,可以归纳出三条可操作的判断依据:
- Qwen4仍在训练,网上说“已发布”的都是传闻。
- 架构已开源:125B、6B激活、512专家,config.json中的架构标识就是Qwen4。
- 最反常规的是Ngram嵌入,它透露的是为显存受限硬件做设计。
判断真假只需查三处:Hugging Face有没有Qwen4仓库、Model Studio有没有Qwen4 Max、Qwen AI有没有相关博文。三处都出现,才算真发布。
想摸架构就跑Qwen3.8 Flash Next;想等真正的Qwen4,就盯住27B那一档——上一代27B刚成为Hugging Face点赞最高的开源模型,这一档的社区期待值最高。
相关推荐

Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。
Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。

谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。