Scriptly:AI语音跟随的iOS提词器,告别抢节奏

为什么传统提词器总是让人「抢节奏」
对于内容创作者、播客主播、教育工作者乃至企业培训师而言,提词器(Teleprompter)早已不是新鲜事物。提词器最早诞生于1950年代的电视新闻行业,最初通过机械滚轴驱动纸质脚本移动。进入数字时代后,提词器演变为显示器配合专用软件的组合。传统数字提词器通常采用三种控制方式:固定速度自动滚动、手动脚踏板控制、或由专职操作员根据演讲者节奏远程调节。
提词器技术演进:从机械到智能
提词器技术的演进反映了人机交互的范式变迁。1950年代的机械提词器采用单向玻璃反射原理,将纸质脚本投影到摄像机镜头前方——演讲者能看到文字,但镜头拍不到。这一光学原理(称为「半透半反镜」或 beam-splitter 方案)至今仍被专业电视台使用,因为它能让主持人直视镜头的同时阅读脚本,实现零视线偏移。具体而言,半透半反镜是提词器的核心光学元件,其工作原理基于薄膜干涉和菲涅尔反射。这块特殊玻璃通常镀有多层介质膜,使其反射率和透射率各约50%。在专业演播室中,一台高亮度显示器水平放置在镜头下方,文字向上投射到45度倾斜的半透半反镜上,演讲者看到的是反射的镜像文字(因此软件需预先做水平翻转),而摄像机透过玻璃拍摄时几乎看不到文字——因为镜头对焦在数米外的演讲者身上,近距离的微弱反射文字完全处于景深之外。这一原理至今未被数字技术取代,因为它解决的是一个物理问题:让视线方向和镜头光轴完全重合,从而消除演讲者的「阅读感」。
1980年代 CRT 显示器的普及催生了电子提词器,脚本可以数字化编辑和存储,彻底告别了逐行打印纸带的繁琐。2000年代平板电脑的兴起让提词器进入消费级市场,iPad 配合提词软件成为 YouTube 创作者的标配,硬件门槛从数万美元降至数百美元。然而直到深度学习语音识别技术成熟,提词器才真正从「被动显示设备」进化为「主动理解工具」。
Transformer 架构的普及使端侧语音模型的识别精度大幅提升,端到端神经网络替代了传统的声学模型+语言模型流水线,为实时跟随奠定了基础。值得一提的是,Transformer 架构由 Google 在2017年的论文《Attention Is All You Need》中提出,其核心创新是自注意力机制(Self-Attention),能并行处理序列中任意位置之间的依赖关系,彻底摆脱了循环神经网络(RNN)的顺序计算瓶颈。在语音识别领域,OpenAI 的 Whisper 模型是 Transformer 应用的代表作——它在68万小时的多语言音频上训练,将编码器-解码器架构直接应用于梅尔频谱图(Mel Spectrogram)到文本的映射,跳过了传统的声学模型-语言模型级联流水线。端侧部署时,通常采用 Whisper 的 tiny 或 base 变体(参数量从39M到74M不等),配合 INT8 量化技术将模型体积压缩至原来的1/4,使其能在移动设备的 Neural Engine 上以接近实时的速度运行。Scriptly 代表的语音跟随技术,本质上是将提词器从单向输出转变为双向交互系统。
但这些方式都面临一个共同痛点:滚动速度与说话节奏难以匹配。固定速度无法适应演讲者的自然停顿和语速变化;手动控制则要求演讲者分心操作设备;人工操作不仅增加成本,还需要操作员与演讲者之间的默契配合。要么滚动太快,让人不得不加速念稿导致语气僵硬;要么太慢,出现尴尬的停顿。这些痛点在个人创作者和小团队中尤为突出——他们往往没有专业团队支持,却需要高质量的视频内容输出。
Product Hunt 与产品验证
近日在 Product Hunt 上以119票、排名第3登场的 Scriptly,正是为了解决这一核心问题而生。Product Hunt 是全球最具影响力的科技产品发现平台之一,采用每日排行榜机制,产品按获得的「upvote」数量排名。能够获得高排名意味着产品在早期用户群体中获得了显著认可,这对初创产品具有获得科技媒体关注、收集高质量用户反馈、验证产品市场契合度等多重价值。
Product Hunt 的排名机制深刻体现了硅谷「精益创业」(Lean Startup)方法论的实践逻辑。每日零点(太平洋时间)排行榜重置,所有产品从零开始竞争当日排名,这避免了老产品长期占据榜首的马太效应。投票采用加权机制:早期采用者、活跃用户、认证制造者(Maker)的投票权重更高,以防止刷票;排名算法类似 Hacker News,综合考虑票数、时间衰减系数和互动质量(评论深度、提问频率)。对初创公司而言,Product Hunt 首发是关键里程碑:登上前三可获得 TechCrunch、The Verge 等科技媒体的自然流量,也能收集来自全球早期采用者的高质量反馈,为后续融资提供可量化的社交证明(social proof)。更重要的是,它强制创始人用一句话说清产品价值——Scriptly 的「由你的声音控制的提词器」就是典型的 Product Hunt 风格标语:简洁、差异化、直击痛点。
Scriptly 的定位十分清晰——一款由你的声音控制的 iOS 语音提词器。它主打「写作、组织、录制」一体化体验,让创作者能够毫不费力地完成从脚本准备到视频录制的全流程。目前该应用已在 TestFlight 上开放公开测试版供用户下载体验。
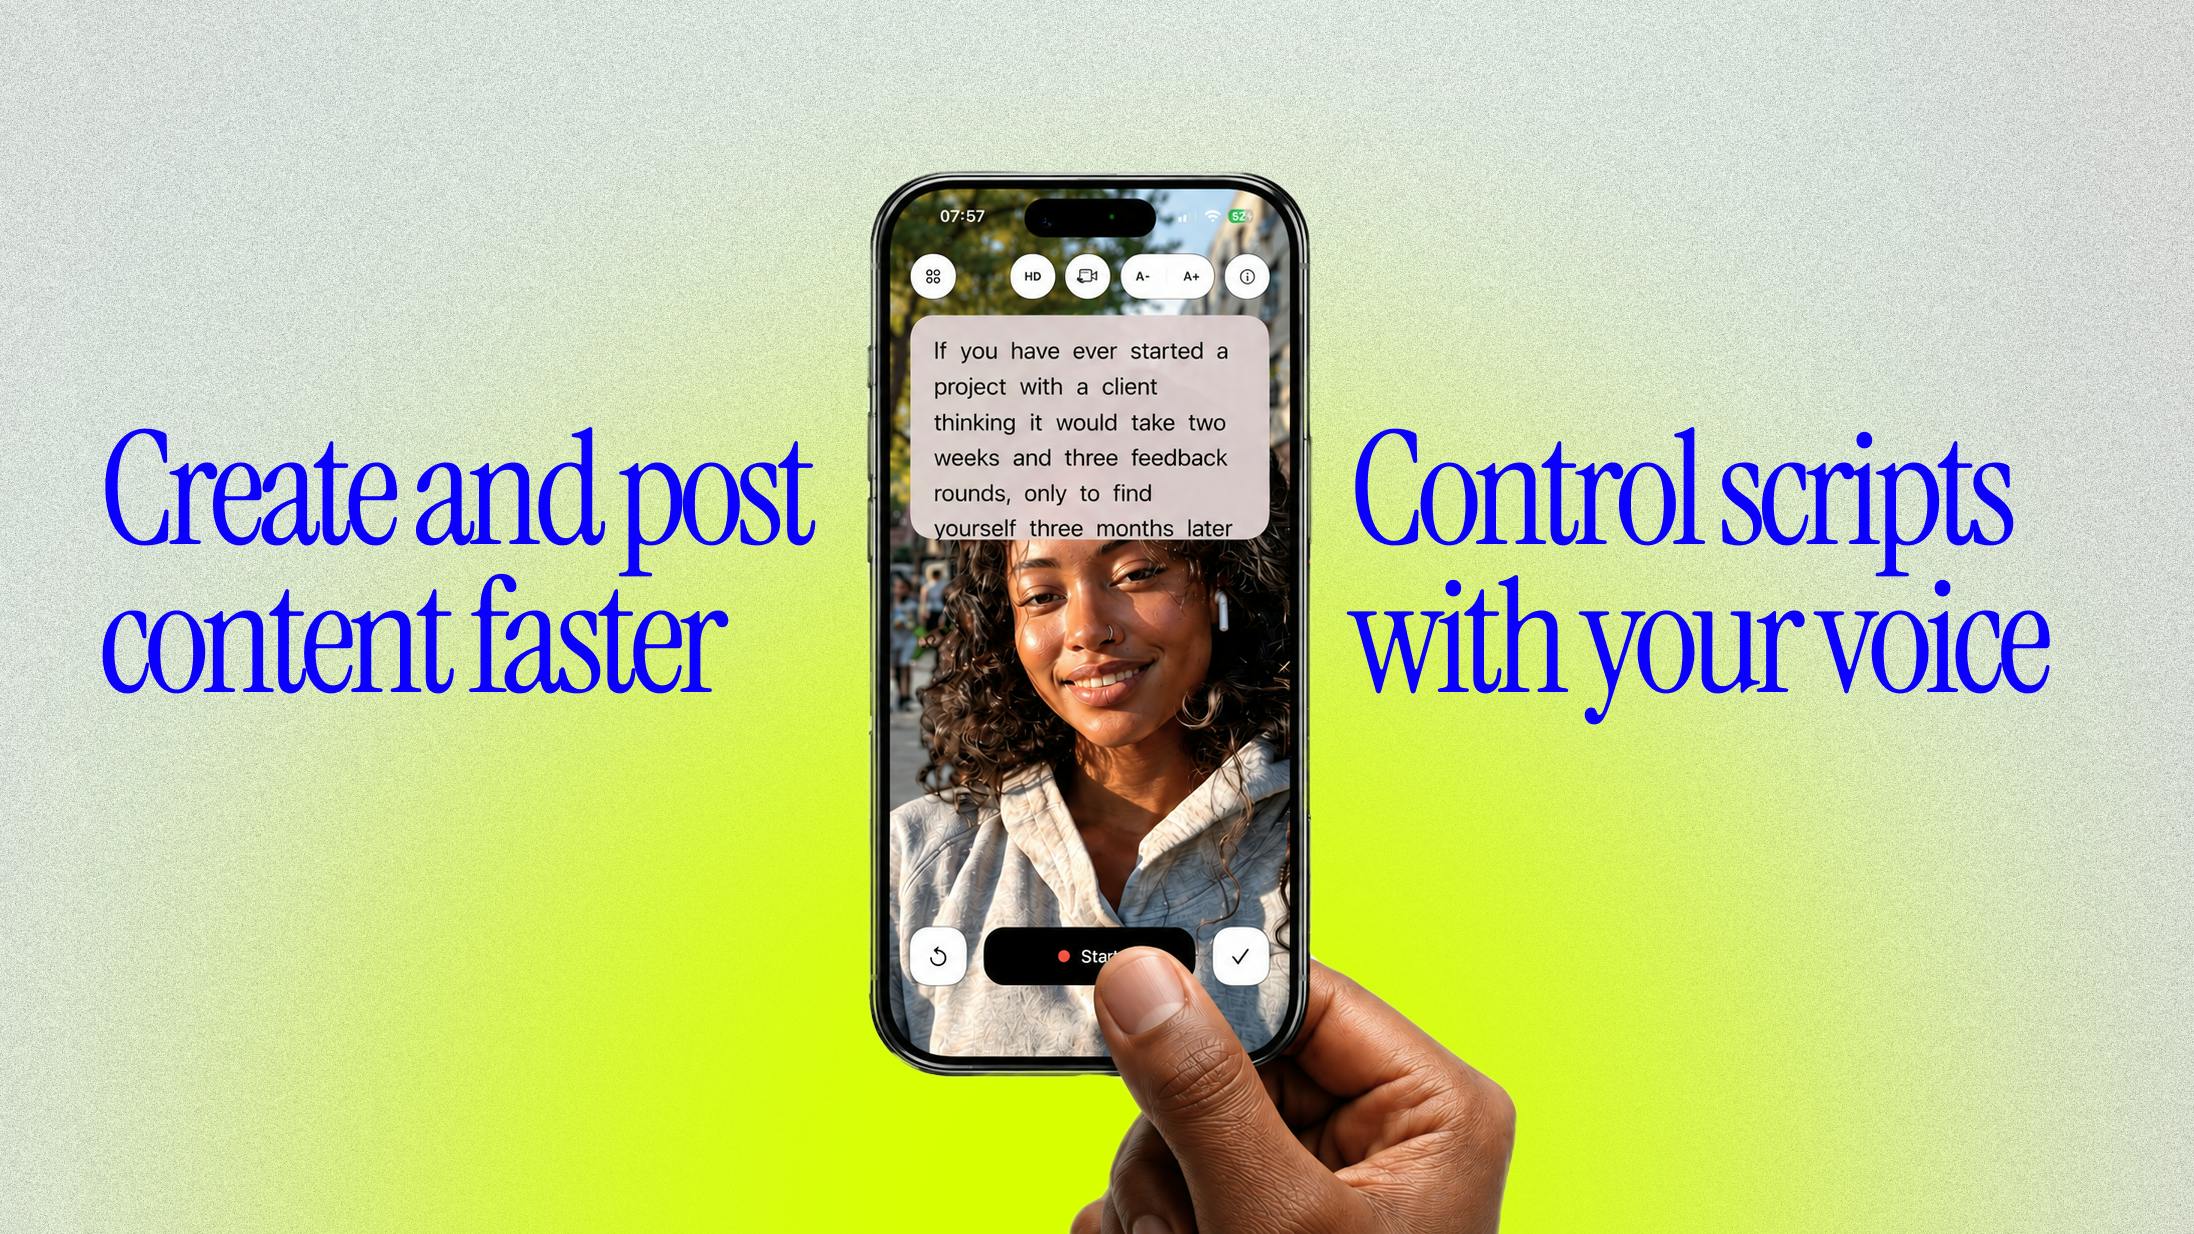
Scriptly 核心功能:AI 实时语音跟随滚动
Scriptly 最具突破性的功能是实时语音跟随滚动(real-time voice-following scrolling)。与传统提词器依赖固定速度或手动控制不同,Scriptly 会实时监听你的语音,并智能地让脚本文本跟随你的朗读进度自动滚动。
这意味着什么?当你放慢语速、停顿思考,或临时插入一句即兴发挥时,提词器不会「跑丢」,而是耐心地等待你回到脚本。这种交互逻辑从根本上改变了创作者与提词器之间的关系——不再是人去追赶屏幕,而是屏幕来适配人。
语音识别背后的 AI 技术
该应用被同时归类于「生产力工具」和「人工智能」两大分类,这并非偶然。要实现精准的语音跟随,背后需要可靠的实时语音识别与文本对齐技术,这是一个由三层技术栈叠加而成的工程问题。
第一层是连续语音识别(Continuous Speech Recognition):需要将音频流实时转换为文字,延迟通常要控制在200毫秒以内,否则滚动会产生明显的滞后感,破坏沉浸体验。现代端侧语音识别依赖端到端神经网络(如 Whisper 的轻量化变体),将声学特征提取、语言模型解码合并为单一网络,大幅降低推理延迟。
第二层是文本对齐算法(Text Alignment):系统需要将识别出的口语文字与预设脚本进行模糊匹配,容忍用户的口误、停顿和即兴发挥。经典实现采用动态规划(如 Smith-Waterman 局部对齐算法),新一代方案则引入基于注意力机制的神经网络,能更好地处理长距离依赖和语义跳跃。Smith-Waterman 算法最初由 Temple F. Smith 和 Michael S. Waterman 于1981年提出,用于生物信息学中的蛋白质和 DNA 序列局部比对。该算法基于动态规划,构建一个打分矩阵,通过匹配奖励、错配惩罚和空位罚分三个参数,找到两条序列之间得分最高的局部匹配区域。将其应用于提词器文本对齐时,「序列」变成了语音识别输出的词序列和预设脚本的词序列,「空位」对应用户的跳读或即兴插入,「错配」对应识别错误。相比全局对齐算法(如 Needleman-Wunsch),局部对齐的优势在于它不要求两条序列从头到尾完全匹配——这恰好契合了演讲者可能随时偏离又回归脚本的真实使用模式。
第三层是滚动控制策略:根据匹配位置平滑调整显示内容,通常采用带缓动函数的动画插值,避免突兀跳转造成视觉疲劳。
这类技术在过去往往受限于识别延迟和准确率。近年来,苹果的 Speech 框架(基于 SFSpeechRecognizer)持续迭代,配合 A 系列芯片内置的 Neural Engine 专用硬件(从 A11 仿生芯片起引入,专门加速矩阵乘法运算),使得端侧实时语音识别在移动设备上成为可能。Apple Neural Engine(ANE)的设计理念与 GPU 不同:GPU 擅长大规模并行浮点运算,而 ANE 针对神经网络推理中的矩阵乘法和卷积运算做了深度优化,采用更激进的低精度量化(支持 FP16 和 INT8)和专用内存带宽设计。到 A17 Pro 芯片,ANE 的算力已达35 TOPS(每秒35万亿次整数运算),同时功耗仅为 GPU 运行相同任务的1/10左右。苹果的 Core ML 框架提供了从 PyTorch/TensorFlow 模型到 ANE 优化格式的自动转换工具(coremltools),开发者无需手动适配硬件指令集。这一软硬一体化策略使得 iOS 设备在端侧 AI 推理方面具备独特优势,也是 Scriptly 能实现低延迟语音识别的硬件基础。Scriptly 的出现,某种程度上也是 AI 语音技术走向消费级应用的一个缩影。
端侧 AI 的技术权衡
端侧 AI 处理(On-device AI)与云端处理各有优劣,选择哪种方案往往取决于具体应用场景的核心约束。端侧处理的核心优势是低延迟(无网络往返时间,通常节省50-200ms)、隐私保护(数据不出设备,无需授权远程访问)、离线可用(无需网络连接),但代价是模型精度受限(需通过量化、剪枝等技术将模型压缩到能在移动芯片上运行,通常损失2-5% 的准确率)、功能迭代慢(需通过 App Store 审核而非服务端热更新)、设备算力要求高(通常需要 A12 仿生或更新的处理器)。云端处理则可以使用参数量达数十亿的大模型、快速迭代功能、降低设备要求,但面临延迟(最快也有50ms 往返)、隐私合规和网络依赖的问题。苹果的整体策略是「混合智能」:常用、实时性要求高的功能端侧处理(如 Siri 基础唤醒和本地指令),复杂推理任务通过 Private Cloud Compute 进行隐私增强的云端辅助。Scriptly 选择纯端侧方案,显然将实时性和隐私置于识别精度之上——这对提词场景是合理的取舍,因为哪怕200毫秒的延迟就足以破坏语音跟随体验的流畅感。
隐私优先:脚本和视频本地存储
在数据隐私日益受到重视的今天,Scriptly 特别强调了本地存储隐私设计。用户的脚本、录制的视频内容都存储在本地设备上,而非上传至云端服务器。
对于经常处理敏感内容的创作者而言,这一点尤为重要。无论是企业内部培训材料、未公开的产品发布脚本,还是个人的创作草稿,本地存储都意味着更高的数据安全性和更强的隐私掌控感。
在 AI 应用普遍依赖云端处理的背景下,这一选择具有显著优势。传统云端语音识别服务(如 Google Cloud Speech-to-Text、AWS Transcribe)需要将音频上传到远程服务器处理,这带来三重风险:数据在传输过程中可能被截获(即便 TLS 加密也无法完全规避中间人攻击风险)、云端存储面临数据泄露的潜在威胁、服务提供商可能将用户语音数据用于模型训练(这在各家服务条款中均有不同程度的说明)。
欧盟《通用数据保护条例》(GDPR)要求数据处理需获得明确同意并遵循「数据最小化」原则;加州《消费者隐私法案》(CCPA)则赋予用户知悉和拒绝数据销售的权利。具体而言,GDPR 于2018年5月正式生效,适用于所有处理欧盟居民数据的组织,无论其物理位置在何处。其核心原则包括:数据最小化(仅收集实现目的所必需的数据)、目的限制(数据不得用于收集时声明之外的目的)、存储限制(数据在目的达成后应删除)。违反 GDPR 的罚款上限为全球年营收的4%或2000万欧元(取其高者)。CCPA 于2020年生效,侧重于赋予消费者四项权利:知情权(了解哪些数据被收集)、删除权、退出权(拒绝数据被出售)和非歧视权(行使隐私权不应受到服务降级)。对于 AI 语音应用而言,用户的语音数据属于 GDPR 定义的生物特征数据,归入「特殊类别个人数据」,处理标准更为严格——这使得端侧处理成为最简洁的合规路径。这些法规的日趋严格,使企业和个人创作者对数据合规愈加重视。端侧处理则完全规避了上述问题——所有语音识别、文本匹配都在设备上完成,数据从不离开用户设备。
有意思的是,本地化处理往往也意味着语音识别在端侧完成,这既保障了隐私,也降低了对网络连接的依赖——用户即便在没有 Wi-Fi 的环境下也能正常使用提词功能。苹果从 iOS 13 开始大力推进端侧机器学习(Core ML 框架),其 Neural Engine 专用硬件可高效运行语音模型,使得在飞机上、地下室、外景拍摄地等无网络环境的使用场景成为可能,这对外景拍摄、现场演讲等创作场景尤为重要。
写作、管理、录制:一体化创作工作流
Scriptly 并不只是一个孤立的提词工具,而是提供了完整的创作闭环:
- 写作(Write):直接在应用内撰写脚本,无需在多个 App 之间来回切换
- 组织(Organize):对脚本进行分类管理,方便复用与检索
- 录制(Record):内置专业级提词与录制工具,一键完成视频拍摄
这种「写-管-录」一体化的设计,大幅减少了创作者的工具切换成本。过去你可能需要在备忘录里写稿、在提词器 App 里念稿、再用相机 App 录制,如今 Scriptly 将这一切整合到单一界面之中。对于高频出镜的视频创作者来说,效率提升非常明显。
Scriptly 值得尝试吗:优势与不足
Scriptly 是一款典型的「小切口、真需求」型产品。它没有试图成为大而全的视频编辑平台,而是聚焦于「语音跟随提词」这一个具体而高频的痛点,做出了差异化。
Scriptly 的三大优势:
- 语音驱动的交互创新——让 iOS 提词器真正适配人的说话节奏
- 隐私优先的本地化设计——契合用户对数据安全的关切
- 一体化工作流——降低内容创作者的工具切换成本
需要关注的不足:
作为公开测试阶段的产品,语音识别在复杂口音、嘈杂环境或多语言场景下的表现仍有待验证。TestFlight 是苹果官方提供的 iOS 应用测试平台,允许开发者向最多10,000名外部测试者分发应用,并收集崩溃报告、性能指标和用户反馈——对于 Scriptly 这类创新型应用,公测阶段至关重要。具体而言,TestFlight 支持两种测试模式:内部测试(最多100名团队成员,无需 App Store 审核)和外部测试(最多10,000名用户,需通过苹果的基础审核,通常24-48小时内完成)。TestFlight 的技术价值不仅在于分发渠道,更在于其内置的诊断工具:它能自动收集崩溃日志(Crash Logs)、能耗报告(Energy Logs)、磁盘写入报告,并通过 App Store Connect 仪表盘可视化展示。开发者还可设置自定义反馈触发器,用户截屏时自动弹出反馈表单。每个 TestFlight 构建版本有效期为90天,这一设计迫使开发者保持迭代节奏。对 Scriptly 而言,TestFlight 阶段的核心目标是收集不同口音、环境噪声、语速变化条件下的语音对齐性能数据,这些边缘场景的真实数据是优化模型表现的关键输入。
语音识别的准确率挑战
语音识别的准确率看似简单,实则受多重因素影响,构成复杂的工程问题。学术界和工业界通常用词错误率(Word Error Rate,WER)衡量系统性能,其计算公式为:WER = (替换数 + 删除数 + 插入数) / 参考词总数。顶级云端系统在安静环境、标准口音下可达 WER 2-5%(即95-98% 准确率),但这一数字在现实场景中会显著下降:在嘈杂咖啡馆环境中 WER 可攀升至15-30%,重口音说话者的 WER 可能高出标准值2-3倍。
从行业基准来看,WER 数字随测试数据集的不同而差异巨大。在 LibriSpeech(英语有声读物)的 clean 测试集上,最先进的模型 WER 已低于2%,接近人类专业转录员约5.5% 的错误率(这一人类基准来自 IBM 在2017年的研究)。但在真实世界场景中,性能落差显著:Switchboard(电话对话)数据集上 WER 约5-6%,CHiME-6(多人嘈杂环境会议)数据集上 WER 高达20-40%。对于非英语语言,资源稀缺的语种(如方言、小语种)WER 可能超过30%。端侧模型由于参数量受限(通常比云端模型小10-100倍),在上述场景中的性能进一步下降。这也解释了为什么 Scriptly 采用「模糊匹配」而非「精确转录」策略——提词器不需要100% 正确识别每个词,只需准确定位用户在脚本中的大致位置即可。
对于 Scriptly 这类应用,还叠加了提词场景特有的三重挑战:其一,实时性约束——必须在语音产生后200毫秒内完成识别和对齐,无法像转录软件那样事后修正;其二,容忍即兴发挥——用户可能临时插入原稿中没有的句子,系统需要判断是真正偏离还是正在回归脚本;其三,处理停顿犹豫——「嗯」「啊」「那个」等语气词如何过滤而不影响对齐位置,是实现流畅体验的关键细节。这就是为什么产品需要大规模公开测试——只有真实用户在各种场景下的持续使用,才能暴露边界情况并持续优化模型表现。
目前仅支持 iOS 平台,Android 用户暂时无法使用。这也与 TestFlight 仅支持 iOS/iPadOS 的技术限制有关。
如果你经常需要对着镜头讲话,厌倦了与传统提词器「抢节奏」的体验,不妨在 TestFlight 上试试这款由声音掌控的语音提词器。它或许代表了提词器这一经典工具在 AI 时代的进化方向。
相关推荐
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。
用GPT和Grok搓出本地AI视频生成器,真能跑起来吗?
海外博主纯靠 GPT、Grok 和 Cursor,不写专业代码从零搭建本地 AI 视频生成应用,最终真的跑通了「威尔·史密斯吃意面」测试。本文拆解其构建全过程、14B 模型带来的质变,以及本地部署的现实门槛。