四大AI编程模型实测:同一提示生成动画,谁最忠实?
四款AI编程模型用纯代码生成20秒动画,Astra以一分优势胜出且成本远低于Fable。
创作者将同一段苛刻提示词交给Claude Fable 5.2、GPT 6.2 Astra、Gemini 4 Hydrogen和Qwen 4 Max,要求纯代码生成20秒日式剑斗动画,并按11项标准打分。结果显示,Astra与Fable质量几乎持平(54分对53分),但Astra的令牌消耗仅为Fable的五分之一,性价比最高;Hydrogen速度最快但角色粗糙且需人工介入;Qwen最便宜但中后段严重偏离指令。Artificial Analysis基准测试与竞技场排名也印证了Astra的令牌效率优势。创作者建议日常任务不必使用最贵的模型。
一场只靠代码的动画对决
如果只给AI一句提示词,要求它用纯代码生成一段20秒的日式动漫剑斗动画——没有现成图片、没有录制音频,所有画面和声音都必须由代码生成——它会交出怎样的作品?一位YouTube创作者把同一段提示词原封不动地交给了四款AI编程模型:Anthropic的Claude Fable 5.2、OpenAI的GPT 6.2 Astra、Google的Gemini 4 Hydrogen和阿里巴巴的Qwen 4 Max。全程不碰一行代码,只发送一次指令,最后按11项标准打分。
这场测试的核心不是“谁做得更漂亮”,而是“谁更听指令”。创作者的原话是:一个做得好看却不听指令的AI,日常工作中没法用。
文中提到的“纯代码生成动画”指的是通过编写程序(通常是JavaScript配合WebGL或Canvas API)在浏览器中实时渲染每一帧画面和合成音频,而非使用预渲染的视频文件或外部素材。这类任务要求模型同时具备空间想象、数学计算和代码组织能力,因为动画的每一帧、每一个特效粒子、每一段鼓点都必须由算法在运行时动态计算得出。与常见的“文生图”或“文生视频”不同,纯代码动画没有像素级参考,模型必须自行构建场景图、光照模型和动画时间线,因此更能暴露其在长程规划和细节一致性上的短板。
提示词苛刻到每一片花瓣
测试用的提示词几乎不留发挥空间:夜晚、巨型月亮、废墟神社庭院、红色鸟居;两位角色——冷静迅捷最终获胜的Kaito,和壮硕落败的Daigo;月亮要带陨石坑和光晕,三座山脉、四盏石灯笼、两棵樱花树、六百片飘落的花瓣;动画要12帧每秒,冲击瞬间天空变白、其余全黑。技术约束同样硬性:单个网页文件、强制使用3D库、所有形状与火焰与鼓点都由代码生成,且同一秒必须永远渲染出完全相同的画面。
这实际上是在考四件事:分镜调度、动画、特效,以及逐行写出来的配乐。更关键的是,提示词要求AI自己打开并测试生成的影片。
“同一秒必须永远渲染出完全相同的画面”指向的是确定性渲染(deterministic rendering)要求。在实时图形中,如果动画依赖随机数或时间相关的浮点运算,同一时间点多次渲染可能产生细微差异,导致画面闪烁或不可复现。提示词强制要求确定性,意味着模型必须使用固定种子的伪随机数生成器,并避免依赖系统时间或帧率的不稳定逻辑。这对代码生成模型提出了额外挑战:它需要在动画循环中精确控制状态更新顺序,确保花瓣飘落、火焰抖动等效果在每次回放时完全一致,而不是简单地调用Math.random()了事。
四款模型的实际表现
Gemini 4 Hydrogen:最快,但角色粗糙
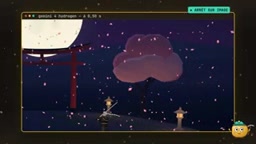
Hydrogen用时33分钟完成,是所有模型中最快的。它的场景忠实度不错:鸟居顶部弯曲、四盏灯笼点亮、两棵樱花树呈圆润花团、花瓣大量飘落,三个大冲击的白闪黑剪影效果也都到位。问题出在角色上——人物像被切成方块,Kaito的披风细看像虚线,眼部特写轮廓有像素感,光效遮住了半张脸。地裂之后天空两侧还残留方形黑块悬在树前。
据创作者描述,Hydrogen首次启动时曾失败,因为它试图一次性写完整个影片、超出了单次响应上限;重试又撞上工具bug,第三次同样报错。创作者手动粘贴了一次工具报错信息后,它才改为分段写入,最终还修改了23次。
GPT 6.2 Astra:细节最丰富,也最自由
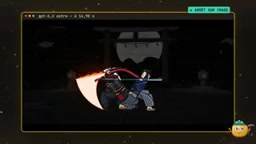
Astra用时47分钟。创作者的第一反应是“像真正的动画片”:樱花树有扭曲的树干和枝条,灯笼真的照亮了周围地面。它还主动加了石墙、鸟居后的台阶、岩石,以及鸟居上系着白纸的绳子——真实神社的样子。这既是美感,也是对指令的偏离:提示词要的是圆润花团状的樱花,它按自己的方式画了。
角色是四者中最精致的:Kaito有草鞋、褶皱裤和飘动的围巾,Daigo有伤疤、胡须和金边黑甲,眼部特写中火焰映在脸上。特效方面,火焰被画成动漫风格而非简单光球,冲击干净利落,慢镜头时世界变暗、只剩青色线条。一个被创作者称赞的细节:慢镜头中Daigo的剑削断了Kaito围巾的一角,片尾这块布躺在地上。
Qwen 4 Max:最便宜,也最放飞
Qwen用时64分钟,是四者中价格最低的。开场地形忠实:鸟居、四盏灯笼、圆团樱花、带陨石坑的月亮。但随着影片推进,它越来越偏离指令:第一次冲击时鸟居变成简单黑色矩形、屏幕被橙色填满;月亮本应始终保持奶白色,却在落地冲击后变橙、变黑、闪烁到结尾;地面裂缝本应在三秒内熄灭,最后一帧仍在发光。一些细节被遗漏:Daigo落地时缺少速度线,Kaito蓄力时光应为闪烁却呈橙色,慢镜头中天空仍是紫色而非世界熄灭。角色纤细、细节少,围巾和马尾像管子。
Claude Fable 5.2:最守规矩的“优等生”
Fable用时68分钟,是最慢的,但它把提示词读到了最后一行。地面上的石板、裂缝、苔藓斑点一一呈现,月亮带蓝色光晕,樱花是标准的圆润花团,四盏灯笼各就各位。细节不如Astra丰富,但更忠实。
它的优势在电影感,尤其是光影:刀刃反光、月光水面、大量烟尘,落地冲击有熔岩裂缝和火柱,双色调画面保留橙色反光和烟雾。角色干净扎实,Daigo眼部特写带着伤疤和橙色眼睛,几乎逐字对应提示词。唯一瑕疵是鸟居顶部直直落下、停在柱脚,而不是向后方倾倒。此外,月前场景中Daigo的剪影偏小,刀刃只是一条黄色光带而非应有的火焰延展;慢镜头中场景变灰但仍几乎和之前一样亮,没有达到“世界只剩四分之一亮度”的要求。
文中反复提到的“令牌消耗”是理解成本差异的关键。在大型语言模型中,令牌(token)是文本处理的基本单位,模型读写代码时每个单词、符号或代码片段都会被切分为若干令牌。生成一段动画代码,模型需要先“思考”再“输出”,思考过程(尤其是扩展思考模式)也会消耗大量令牌。Astra的令牌效率高,意味着它在同等任务下产生的内部推理和输出代码更精简,从而降低了按令牌计费的成本。对于订阅制服务,令牌消耗虽不直接产生账单,但会影响响应速度和调用限额,因此仍是衡量模型实用性的重要指标。
代码与成本的量化对比
四份代码的文件体积从约104KB(Qwen)到183KB(Hydrogen)不等,Fable和Astra居中。代码行数差异很大,但创作者指出行数受格式影响大,文件体积更有可比性。
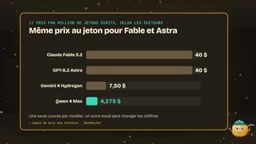
真正拉开差距的是令牌消耗。Astra写出的令牌量远低于其他三家,约为Fable的五分之一,尽管它的文件是第二大的。按各厂商公开定价折算,Fable的影片成本远高于Astra,Astra又高于Hydrogen(后者还需为一次失败启动额外付费),Qwen最低。Fable与Astra的单令牌价格相同,但Astra的总成本低得多,原因就是它消耗的令牌少得多。
创作者对此保留了两点:换一次测试可能得到不同数字;Fable和Astra走的是订阅制,并非真实账单。
基准测试与竞技场的旁证
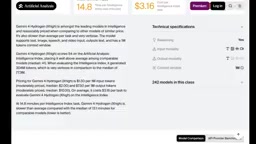
Artificial Analysis用与测试相同思考等级对四款模型跑了一组基准:Fable得分最高,Astra紧随其后,Hydrogen居中,Qwen垫底。该站还统计了模型完成全部测试所写的令牌量,Astra只有Fable的四分之一多一点——这和本次动画测试中“Astra令牌消耗约为Fable五分之一”的结论方向一致,说明这不是偶然,而是它的工作方式。
在人类投票评选最佳网站的竞技场中,Fable排名第一,Qwen第六,Hydrogen第十一;Astra刚发布,尚未上榜。
Artificial Analysis是一个独立第三方评测机构,它通过标准化提示词和统一思考等级对主流大模型进行横向对比,并公布得分与令牌消耗数据。其基准测试覆盖推理、编码、指令遵循等多个维度,常被用作模型选型的参考。文中提到的“竞技场”则指LMSYS Chatbot Arena等人类偏好投票平台,用户对两个匿名模型的回答进行盲选,最终形成Elo式排名。这两类评测与本次动画测试形成互补:基准测试反映通用能力,竞技场反映人类主观偏好,而动画测试则聚焦于特定长程代码生成任务中的指令遵循与成本效率。
最终排名:一分之差
创作者按11项标准、每项1到5分打分,其中Fable和Qwen采用盲评。结果:Qwen 37分(55分制)第四,Hydrogen 47分第三,Fable 53分第二,Astra 54分第一。第一名与第二名只差一分,创作者认为这几乎算平手,基准测试也显示两者接近。
真正的胜负手是成本:质量几乎相同的情况下,Astra的成本远低于Fable,单位得分花费也更低,是本次测试中性价比最高、令牌效率最好的模型。小预算场景下Hydrogen是备选(但它需要一次人工介入),Qwen最便宜且表现超出预期。创作者的建议是:日常任务不必用Fable或Astra这类面向复杂任务的模型,更便宜的模型往往够用。
这场测试只衡量一件事:一句提示词生成一整部代码动画的忠实度。它不能代表所有任务,但它清楚地说明——在指令遵循这件事上,不同模型的差距不在“能不能做”,而在“愿不愿意听话”和“花多少代价听话”。
相关推荐
FBI警告的AI黑客工具ARTEX:攻击全流程拆解
FBI就开源AI黑客框架ARTEX(ARDEX)发布紧急警报,Google与Mandiant已在真实入侵中追踪到它。本文拆解其五阶段攻击链、AI模型调用方式、行为特征与检测缓解措施。
Qwen 4 Max对决Gemini 4 Hydrogen:实测游戏开发谁更强
实测对比Qwen 4 Max Preview、Gemini 4 Hydrogen与Gemini 4 Argon的游戏开发生成能力:从Minecraft克隆、3D射击到SVG交互动画,跑分最高的模型未必最好用,揭示AI编程模型选型的实战盲区。
Qwen 4 Max发布:低价混合跑分,谷歌Gemini新模型曝光
Qwen 4 Max 正式上线:2.4 万亿参数 MoE 架构、100 万 token 上下文,API 价格大幅下调但终端任务跑分落后 Opus。同时谷歌 Gemini 4 的 Oxygen、Krypton 模型曝光,GPT-6.2 Sol 疑似灰度,Anthropic 研究员预测超人类 AI 约 1.3 年后到来。