Unsloth v0.1.916-beta发布:大型性能修复与双GPU加速
Unsloth v0.1.916-beta 集中修复聊天卡顿,并为图像视频推理带来双卡拆分提速。
Unsloth 发布 v0.1.916-beta,更新重心落在可感知的速度提升上。聊天侧修复了 Glass 主题与背景图下长对话输入卡顿、超长历史搜索失败与批量删除缓慢的问题,Linux 桌面 Glass 主题响应最高快 2 倍且不再依赖 GPU 渲染。图像与视频侧,两张型号匹配的空闲 NVIDIA GPU 可将 SDXL、Qwen-Image、Wan2.2 5B 提速约 1.5 到 1.8 倍,FLUX 与 Lumina 2 改为批次拆分;SDXL 加载快 40%,LTX-2.5 在 16-24 GB 显存上改为 GPU 编码提示词。功能上新增浮动浏览器与每聊天独立浏览器实例,思考块与代码块改为可滚动容器。训练侧 Linux + NVIDIA 下 Llama、Qwen2、Qwen3 的 model.generate() 默认更快。官方同时提示多数提速有硬件与平台前提。
Unsloth 作为面向本地大模型训练与推理的开源工具链,长期以「让有限显存跑得动大模型」为核心卖点。本次发布的 v0.1.916-beta 版本号虽然仍带 beta,但更新日志里塞进的内容量更像一次阶段性大版本:从聊天界面卡顿、图像/视频生成加载,到 Python 训练接口的 model.generate() 默认性能,几乎每一条都冲着「感知得到的速度」而去。
聊天体验:长对话不再卡输入
长对话下打字卡顿是本地聊天客户端的通病,尤其叠加上 Glass 主题或聊天背景图之后,GPU 渲染压力会直接反映在输入延迟上。这次更新明确修复了「开启 Glass 主题或聊天背景后长聊天输入卡顿」的问题,并让超长历史记录的聊天搜索保持可用,而不是加载失败。
清理和删除聊天在大量历史记录下也明显提速。语音或音频功能首次调用后不再冻结正在流式输出的回复数秒,用 Unsloth 模型引擎朗读时也不再多等一次模型查找。对于在 Linux 桌面上使用背景图 Glass 主题的用户,官方称响应速度提升最高可达 2 倍,且不再依赖 GPU 渲染。
Glass 主题本身也做了视觉修正:背景图从模糊改为调暗,其他页面的控件与聊天界面保持一致的玻璃质感。下一个版本还会继续做 Glass 主题优化,说明这条视觉线尚未收尾。
图像与视频:双卡拆分与加载提速
这是本次更新中技术含量最高的部分。在两张型号匹配且空闲的 NVIDIA GPU 上,SDXL、Qwen-Image、Wan2.2 5B 这类单卡放得下的模型,会把每一步计算的一半分给第二张卡,官方给出的提速幅度约为 1.5 到 1.8 倍。FLUX 和 Lumina 2 则采用不同策略——把等量的图像批次拆分到两张卡上并行。
加载侧的改进同样直接:SDXL 加载最高快 40%,首张图的等待时间缩短。在 16 到 24 GB 显存的 GPU 上,LTX-2.5 改为在 GPU 而非 CPU 上编码新提示词,新提示词的视频片段渲染显著加快;LTX-2.5 GGUF Q8_0 视频在 NVIDIA GPU 上约快 10%,且画面帧完全一致。
AMD 用户也有收获:FLUX、Z-Image 等图像模型在 Linux 搭配 RDNA3、RDNA4 GPU 时渲染更快。提交记录里还能看到更细的优化,比如 RDNA3/RDNA4 ROCm 上编译版 int8 W8A8 线性层让 Qwen-Image-2.1 int8 每步快 21%,以及为 ROCm 安装 flash-attn 的 Triton AMD 后端带来 10-15% 的扩散步骤提速。
文中提到的「每一步计算的一半分给第二张卡」,指的是扩散模型推理中的序列并行/模型并行拆分思路。扩散模型(如 SDXL、FLUX)的推理由数十步去噪迭代组成,每步都要跑一次完整的 UNet/DiT 前向。当单卡显存放得下整个模型时,最常见的多卡加速方式不是模型切分(那会引入大量卡间通信),而是在 batch 维或计算图内部做切分:要么把同一提示词的多张候选图分给两张卡并行生成,要么把单个样本的注意力/线性层计算按 token 或通道维切开,每张卡只算一半、再通过 NCCL 做 all-gather/all-reduce 汇合。前者的通信开销几乎为零但只在批量生成时有效,后者对单图也能加速,代价是每步都要同步梯度以外的激活张量。这也解释了为什么官方强调「型号匹配且空闲」——两张卡算力不一致会让快的那张一直等慢的,而卡上有其他任务占用显存时,拆分本身就可能 OOM。
文中反复出现的 GGUF、Q8_0、int8 W8A8 是三类不同的量化格式,容易混淆。GGUF 是 llama.cpp 生态的模型容器格式,把权重和元数据打包成单文件,量化粒度可以是 Q4_K_M、Q8_0 等,主要面向 CPU/混合推理与低显存场景;Q8_0 表示每 32 个权重共享一个 8-bit 缩放因子,属于「接近无损」的 8 比特量化。而 W8A8 指权重(Weight)和激活(Activation)都量化到 8 比特,需要硬件或内核支持 int8 矩阵乘,因此文中特意限定在 RDNA3/RDNA4 的 ROCm 编译版线性层上——只有底层有对应 int8 GEMM 内核时,W8A8 才真的比 FP16 快,否则反量化开销会吃掉收益。Q8_0 视频「约快 10% 且画面帧完全一致」则说明该优化发生在计算调度层面(如更好的 kernel 选择或内存布局),没有改动数值精度。
新增功能:浮动浏览器与独立会话浏览器
功能层面最直观的变化是浮动浏览器:内置浏览器可以变成悬浮在聊天上方的小窗口,随手移动和缩放,每个聊天会记住自己是否处于浮动状态。更进一步,多个聊天现在可以各自运行独立的浏览器实例,模型在后台做事时不会互相抢占同一个页面。
思考块和代码块的展示也重新设计,改为带滚动容器的封顶高度,长输出不再无限撑高页面。模型侧引入了 Dynamic V3.1 Qwen3.8-Flash,官方称 token 使用量减少 50%、准确率提升 15%。
其他新增包括:支持从单文件检查点加载 Anima、Chroma、MOSS-Image、Krea 2 图像模型(除 Chroma 外均支持 LoRA 和 LoKR 文件);账户拥有者可以在不丢失聊天、文件和设置的前提下重命名托管账户;下载限速可以在设置中限制;OpenAI 兼容连接支持发送自定义请求头。
修复与训练库改动
修复项覆盖了不少日常痛点:仅聊天安装且已下载非 GGUF 模型时,首次聊天不会再因为找不到默认模型而失败;纯 CPU 机器上的 GGUF 模型在 Auto 上下文下不再爆内存;Windows 上 HTTPS 下载在暂停或中断后可以续传而不是从头开始;Windows 更新结束时不再静默卡半分钟;通过 MCP 连接 Blender 恢复可用;Compare 模式首条消息不再留空一个面板。
训练与库层面,Linux + NVIDIA GPU 环境下 Llama、Qwen2、Qwen3 的 model.generate() 默认更快,小模型上可达数倍提升。Hub 数据集被拆成数百个文件时,训练启动最多提前一分钟。启用「仅助手补全」时,以换行开头的回答不再被排除在训练之外。提交记录中还出现了默认启用 CUDA graphs 解码并带内存释放与 eager 回退、冻结 LoRA 的 A/B 矩阵跳过梯度 GEMM、以及可选的 BF16 AdamW 随机参数更新等底层改动。
CUDA graphs 是 NVIDIA 提供的一种捕获-重放机制:把一段固定的 GPU 计算序列(kernel 启动、内存拷贝等)录制为一张图,之后用一次 graph launch 重放,从而消除逐 kernel 的 CPU 启动开销。对 model.generate() 这类自回归解码尤其有效,因为每生成一个 token 的计算图结构几乎相同,属于典型的「小 kernel 多、启动开销占比高」场景——这也解释了为什么小模型提升可达数倍,而大模型因单步计算本身够重、收益被摊薄。代价是 CUDA graphs 要求显存地址固定,动态 shape 或动态分配会失效,所以提交记录里配套了「内存释放与 eager 回退」:遇到不支持的算子或超长序列时退回普通逐 kernel 执行,避免直接报错。解码阶段默认开启、训练阶段通常不开,是这类优化的常见取舍。
值得注意的取舍
这次更新的提速大多有前提条件。双卡拆分要求两张卡型号匹配且空闲,1.5 到 1.8 倍是官方口径下的典型值而非保证值;LTX-2.5 的提速限定在 16 到 24 GB 显存区间;部分优化(如 FLUX 的 fused AdaLN、MiniMax-H3 的 int8 视频解码器)只在特定架构或平台默认开启。对普通用户来说,最稳妥的收益来自聊天卡顿修复、SDXL 加载加速和 model.generate() 的默认改进——这三项不需要额外硬件配置就能吃到。
Unsloth Desktop 依旧免费开源,提供 Windows、macOS、Linux(deb、AppImage、ARM64)以及 Windows ARM64 的下载包。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
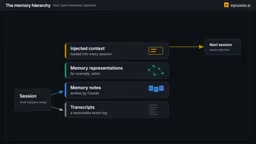
AI智能体记忆全解析:四层结构与“做梦”机制
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。