Vex:为AI Agent打造的GitOps技能版本管理器

Vex将GitOps版本控制理念引入AI Agent上下文管理,让Agent记忆可分支、可回滚、可审计。
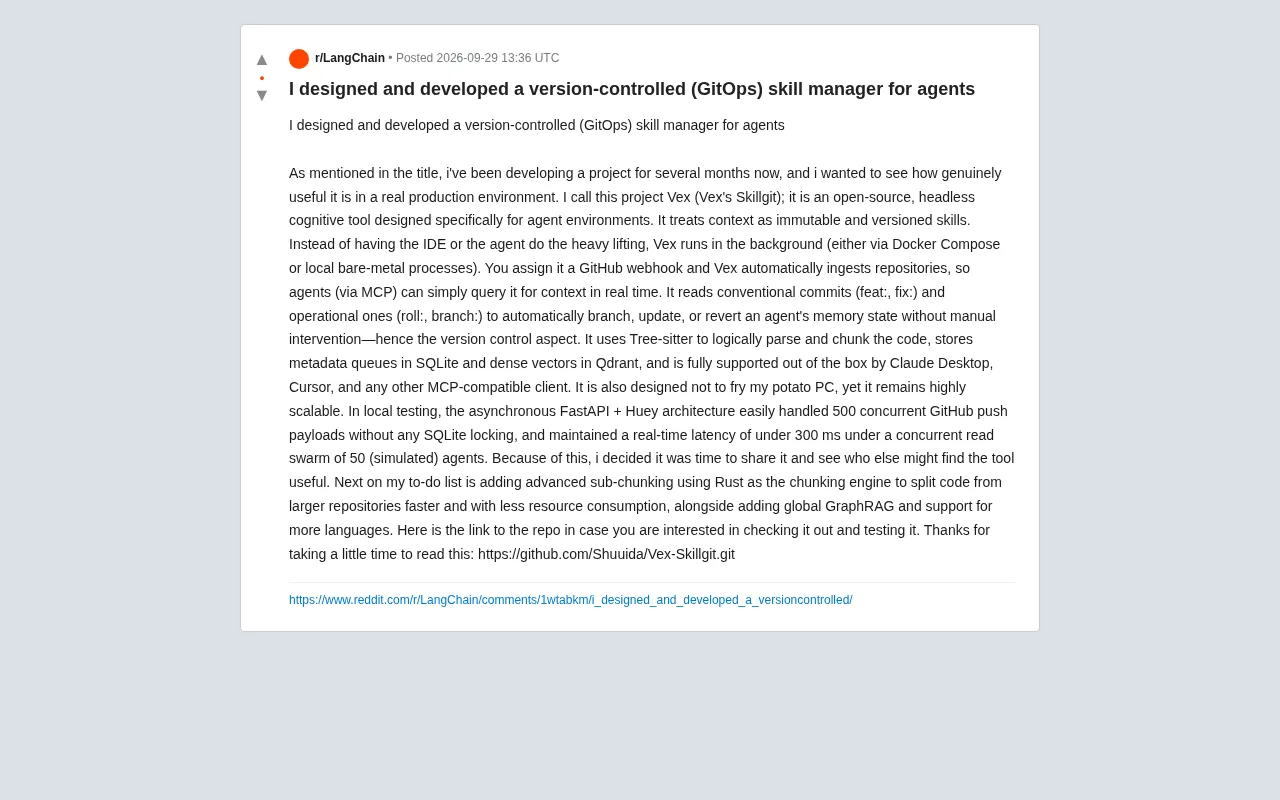
Vex(Vex's Skillgit)是一个开源的无头认知工具,核心理念是将Agent的上下文与技能视为"不可变、可版本化的资产",用Git的心智模型解决Agent记忆难以追溯、无法回滚、不利于团队协作的问题。它以后台服务形式运行,通过GitHub Webhook自动摄取代码仓库,Agent经由MCP协议实时查询所需上下文;同时复用标准Git提交约定,自动为Agent记忆状态执行分支、更新或回滚,全程无需人工干预。技术栈上,Vex选用Tree-sitter做语义感知的代码分块、SQLite存元数据、Qdrant处理向量检索、FastAPI+Huey实现异步并发,兼顾本地轻量运行与横向扩展能力。项目已在GitHub开源,路线图包含Rust分块引擎、全局GraphRAG及多语言支持。
当Agent的记忆也需要版本控制
随着AI Agent逐渐从实验走向生产环境,一个被长期忽视的问题浮出水面:Agent的上下文与技能如何管理?大多数方案要么把重活丢给IDE,要么让Agent本身承担繁重的上下文加载,结果是难以追溯、无法回滚、更谈不上团队协作。
一位开发者在Reddit上分享了他历时数月打造的开源项目 Vex(Vex's Skillgit),试图用软件工程里最成熟的范式——版本控制(GitOps)——来解决这个问题。它的核心理念相当直接:把上下文当作**不可变、可版本化的技能(immutable, versioned skills)**来对待。
GitOps 思路如何落地到 Agent 记忆
Vex 被定义为一个无头(headless)的认知工具,专门服务于Agent环境。它不像插件那样嵌入编辑器,而是以后台服务的形式运行——既支持 Docker Compose,也支持本地裸机进程。
使用方式是给它配置一个 GitHub Webhook,之后 Vex 会自动摄取(ingest)代码仓库,Agent 则通过 MCP(Model Context Protocol) 实时查询所需上下文。
最有意思的是它对 Git 提交约定的复用。Vex 会读取常规提交(如 feat:、fix:)和它自定义的操作性提交(如 roll:、branch:),据此自动为Agent的记忆状态进行分支、更新或回滚,全程无需人工干预。这意味着Agent的"记忆"不再是一团黑箱,而是像代码仓库一样可分支、可回退、可审计——这正是所谓"版本控制"的落点。
与主流客户端的兼容性
由于建立在 MCP 之上,Vex 声称开箱即用地支持 Claude Desktop、Cursor 以及任何兼容 MCP 的客户端。对于已经在使用这些工具的开发者来说,接入成本相对较低。
MCP(Model Context Protocol) 是 Anthropic 于2024年提出的开放协议,旨在标准化大语言模型与外部工具、数据源之间的交互方式。其设计类似于"AI领域的USB接口"——工具提供方只需实现一次MCP服务端,即可被所有支持该协议的客户端(如Claude Desktop、Cursor等)直接调用,无需为每个宿主环境单独适配。在Vex的架构中,MCP扮演的角色是Agent查询技能上下文的统一通道:Agent发出语义查询请求,Vex的MCP服务端负责在Qdrant向量库中检索相关代码片段并返回,整个过程对Agent透明,也使得Vex天然具备跨客户端的可移植性。
技术栈拆解:轻量与可扩展的平衡
从作者披露的架构看,Vex 在选型上刻意兼顾了"不烧掉我的土豆电脑"和"高可扩展性"两个目标:
- 代码解析:使用 Tree-sitter 对代码做逻辑化解析与分块(chunking),而非简单按字符或行数切割,从而保留语义结构。
- 元数据存储:轻量的 SQLite 承载元数据队列。
- 向量存储:稠密向量交由 Qdrant 处理,支撑语义检索。
- 异步架构:FastAPI + Huey 的组合负责处理并发任务。
这种组合的取向很明确——用最小的本地资源占用换取够用的性能,同时保留横向扩展的空间。
性能数据
作者给出了本地测试结果:异步的 FastAPI + Huey 架构能"轻松处理 500 个并发 GitHub push 负载"而不出现 SQLite 锁定问题;在模拟 50 个 Agent 的并发读取压力下,实时延迟保持在 300ms 以内。
需要说明的是,这些均为作者本地环境的自测数据,尚未经过第三方在真实生产环境中的验证,读者在评估时应保持谨慎。
Tree-sitter 是一个增量式语法解析库,原本为代码编辑器实时高亮而设计,其核心优势在于能将源代码解析为具有完整语法结构的抽象语法树(AST),而非简单的文本流。用它做代码分块(chunking)的好处显而易见:切割边界会自然落在函数、类、方法等语义单元上,而不会在一个表达式中间断开,这对后续的向量嵌入质量至关重要——语义完整的代码块在检索时更容易匹配到真正相关的上下文,而非只共享了若干行字符串的代码片段。Tree-sitter目前支持100余种编程语言的语法定义,这也是Vex路线图中"支持更多编程语言"能够相对低成本实现的技术基础。
值得关注的设计取向
Vex 最大的价值或许不在于单点技术,而在于它把软件工程的成熟实践迁移到了Agent上下文管理这个新兴领域。当团队开始在生产环境中部署多个Agent时,"谁的记忆是哪个版本""某次更新导致行为退化如何回滚"这类问题会越来越现实。用Git的心智模型来应对,是一个符合直觉且易于团队协作的方向。
把上下文视为不可变、可版本化的资产,也呼应了近年来"上下文工程(context engineering)"逐渐取代单纯"提示工程"的趋势——Agent的能力边界越来越取决于它能访问到什么样的、经过组织的上下文。
上下文工程(Context Engineering) 是近期在AI工程师群体中兴起的概念,由Shopify CEO Tobi Lütke等人推广。其核心主张是:随着基础模型能力趋于饱和,决定Agent实际表现的关键因素已从"如何措辞提示词"转移到"如何系统性地组织、筛选、动态注入上下文"。提示工程关注的是单次交互中语言的精确度,而上下文工程关注的是整个信息架构——哪些记忆应该在哪个时机以什么形式出现在模型的注意力窗口内。Vex的设计与这一趋势高度契合:通过版本化管理使上下文的来源可追溯、通过语义检索使注入的内容精准相关,本质上是在为Agent构建一套"有据可查的认知基础设施"。
未来路线图
作者列出的下一步计划包括:
- 引入 Rust 作为分块引擎,实现更高级的子分块(sub-chunking),以更快、更省资源的方式处理大型仓库;
- 加入 全局 GraphRAG,提升跨文件、跨模块的关联检索能力;
- 支持更多编程语言。
项目已在 GitHub 开源(Shuuida/Vex-Skillgit),作者也明确表示希望有更多人试用并反馈其在真实生产环境中的实用性。对于正在探索 Agent 上下文管理、又偏好 GitOps 工作流的开发者,Vex 提供了一个值得一试的思路样本。
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。

Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。