训练4B小模型生成查询计划,比Postgres快81%
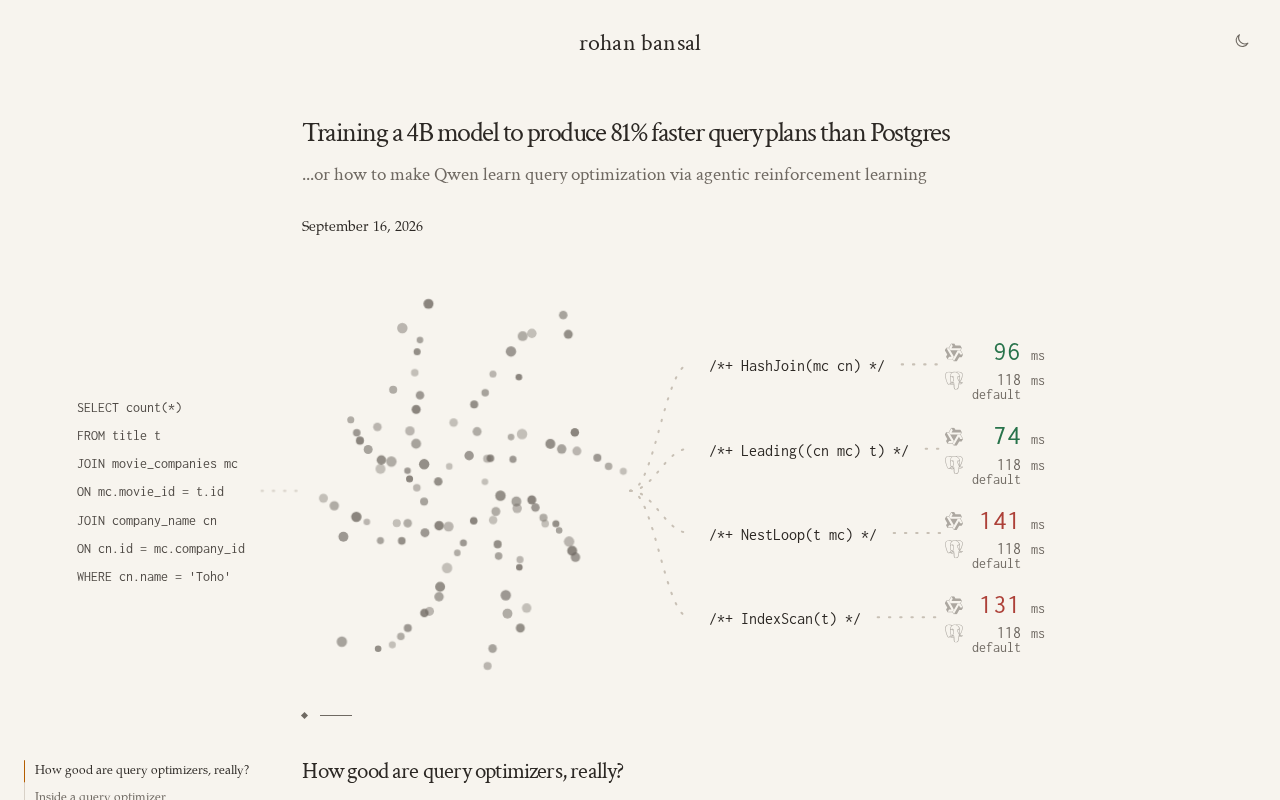
4B小模型生成的查询计划在基准测试中比Postgres快81%,展示了学习式优化器替代传统成本模型的可行路径。
传统数据库查询优化器依赖成本模型和统计估算,在多表JOIN、数据分布倾斜等场景下容易产生严重误差。一个仅4B参数的小型神经网络模型通过直接从真实执行数据中学习,在基准测试中生成的执行计划比Postgres原生优化器快81%。4B这一规模本身是工程权衡的产物——既要保证足够的表达能力,又要在毫秒级延迟约束内完成推理。学习式查询优化并非新概念,MIT的Neo、Bao等学术系统已有探索,但本项目将大语言模型时代的训练方法引入这一领域,工程上更为简洁。落地面临泛化能力、最坏情况可靠性、可解释性和训练数据成本等挑战,现阶段更务实的做法是将模型作为传统优化器的增强层而非完全替代。
用小模型重构数据库查询优化
数据库查询优化器是关系型数据库最核心也最复杂的组件之一。它决定了一条 SQL 语句以何种方式执行——先扫描哪张表、使用哪个索引、以什么顺序做 JOIN。同样一条查询,不同的执行计划在性能上可能相差数十倍。Postgres 等成熟数据库依赖基于成本模型(cost model)的启发式优化器,通过统计信息估算每种执行路径的代价,再挑选估算成本最低的方案。
这套方法工作了几十年,但也存在固有短板:成本模型依赖的统计估算经常失准,尤其在多表连接、数据分布倾斜、列间存在相关性的场景下,优化器容易做出糟糕的选择。近期一个引发 Hacker News 社区关注的项目提出了另一条路径——用一个仅 4B 参数的小型模型来生成查询计划,声称其产出的执行计划比 Postgres 原生优化器快 81%。
4B 模型为什么能跑赢传统优化器
这个数字背后的核心思路,是把查询优化从「基于规则和统计估算的搜索」问题,转化为一个「学习」问题。传统优化器的估算误差会在多层 JOIN 中层层累积,而机器学习模型可以直接从大量真实执行数据中学习哪些计划实际表现更好,绕开了成本模型的估算偏差。
值得关注的是模型规模的选择。4B 参数在当下大模型语境里属于「小模型」,这意味着它有机会在合理的延迟和资源开销内完成推理——这一点对数据库场景至关重要。查询优化必须在毫秒级完成,如果为了生成一个更好的计划而花费数百毫秒的模型推理时间,那么在多数在线查询场景下反而得不偿失。选择 4B 而非更大的模型,本身就是对「优化收益」与「推理开销」之间平衡的权衡。
「81% 更快」这个指标需要谨慎解读。它通常指在特定基准测试集(如复杂分析型查询)上,模型生成计划的执行时间相比 Postgres 默认计划的改善幅度。这类提升在分析型(OLAP)负载中更容易实现,因为那里的查询更复杂、优化空间更大;而在简单的点查或事务型(OLTP)负载中,Postgres 原生优化器往往已经足够好,改善空间有限。
传统优化器估算误差的根源在于「基数估计」(cardinality estimation)问题——即预测某个查询条件会返回多少行数据。单表的基数估计尚可依赖直方图统计,但多表 JOIN 时优化器通常假设各列之间相互独立,用各自的选择率相乘来估算结果集大小。现实中列间往往存在关联性(如城市与邮编高度相关),这种独立性假设会导致估算值与真实值相差数个数量级。错误的基数估计会让优化器误判 JOIN 的代价,进而选择错误的 JOIN 顺序或连接算法(如用 Nested Loop 替代 Hash Join),在数据量较大时引发严重的性能退化。这也是为什么机器学习方法被寄予厚望——它可以通过观察大量真实执行结果,隐式地学习到数据分布的内在规律,而无需显式建模列间相关性。
学习式查询优化并非全新概念
用机器学习改进数据库查询优化是学术界持续多年的方向。MIT 的 Neo、微软的 SQL Server 学习式基数估计、以及 Bao 等系统都探索过类似思路。这些工作大致分为几类:用模型改进基数估计(cardinality estimation)、用强化学习引导 JOIN 顺序搜索、或直接端到端生成执行计划。
这个 4B 模型项目的意义,在于把大语言模型时代的训练方法带入了这个领域。相比早期需要精心设计特征工程的学习式优化器,用一个统一的神经网络模型直接从查询和数据中学习,工程上更简洁,也更容易迁移到新的工作负载。不过社区讨论中也提出了几个关键疑问,值得任何考虑落地的人思考。
这里提到的几个代表性系统各有侧重,值得简要区分。Neo(Neural-Enhanced Optimizer,MIT 2019)采用端到端方式,直接将查询树映射为执行计划,通过模仿学习和强化学习迭代改进。Bao(Bandit Optimizer,MIT 2021)则更保守:它不从零生成计划,而是给传统优化器提供不同的 hint(如禁用某种 JOIN 算法),让优化器在受限空间中搜索,再用 bandit 算法从执行反馈中学习哪些 hint 组合效果更好——这种方式天然保留了传统优化器的回退能力。微软在 SQL Server 中引入的学习式基数估计则聚焦于单点问题:用神经网络替换直方图来提供更准确的行数预测,改善成本模型的输入质量而非替换整个优化流程。相比之下,用 4B 参数的大语言模型风格架构直接生成计划,代表了更激进的路线。
落地前必须回答的几个问题
第一是泛化能力。模型在训练数据覆盖的查询模式上表现优异,但面对未见过的 schema、数据分布或查询结构时会如何?数据库的现实是 schema 和数据持续变化,一个「冻结」的模型很可能随时间退化,需要机制来检测并触发重新训练。
第二是最坏情况的可靠性。传统优化器即使不够聪明,其行为是可预测的;而学习式模型偶尔生成一个灾难性的坏计划,可能导致某条关键查询超时。生产环境通常需要一个「安全网」——比如将模型作为建议器,与传统优化器的计划做对比择优,或设置回退机制,而非完全替换。
第三是可解释性与调试。DBA 排查慢查询时依赖 EXPLAIN 输出去理解优化器的决策逻辑。当计划由神经网络生成时,如何调试为什么某个计划被选中,会成为运维上的新挑战。
第四是训练成本与数据获取。要训练出高质量模型,需要在真实或仿真环境中执行大量查询以收集反馈信号,这个数据采集过程本身有相当成本,也可能对生产系统产生干扰。
「分布漂移」(distribution shift)是这类系统面临的长期挑战之一。数据库的数据量、数据分布和查询模式都会随业务发展持续演变——节假日流量峰值、新功能上线带来的查询模式变化、数据增长导致的索引选择性改变,都会让训练时的「最优计划」变得不再最优。工程上需要设计持续监控机制:对比模型推荐计划与实际执行结果,当检测到系统性偏差时触发增量训练或重新训练。此外,「冷启动」问题同样棘手——新部署的数据库没有历史执行数据,模型无法基于空数据集进行训练,通常需要先用传统优化器积累足够的执行样本,才能切换到学习式方案。这意味着学习式优化器本质上是一个需要持续维护的「活系统」,而非一次性部署的静态组件。
一个方向性的信号
抛开单一基准数字的争议,这个项目更大的价值是一个方向性信号:随着模型推理成本下降、小模型能力增强,把学习能力嵌入数据库系统核心组件正变得越来越可行。查询优化只是起点,缓存策略、索引推荐、资源调度等场景同样存在类似的机会。
对实际工程团队而言,现阶段更务实的做法或许不是用模型完全替代成熟优化器,而是将其作为增强层——在传统优化器给出计划的基础上,让模型识别其中的次优决策并提供改进建议。这样既能获得学习式方法的收益,又保留了传统方法的可靠性下限。当模型的鲁棒性和泛化能力被充分验证后,更深度的集成才会水到渠成。
相关推荐
Devin 推出 Code Scans:让工程目标自动转化为代码改进
Cognition 为 AI 软件工程师 Devin 推出 Code Scans 功能,可将宽泛的工程目标自动转化为具体的代码改进,通过调查、评估、生成 Pull Request 三步闭环帮助团队系统性提升代码库质量。
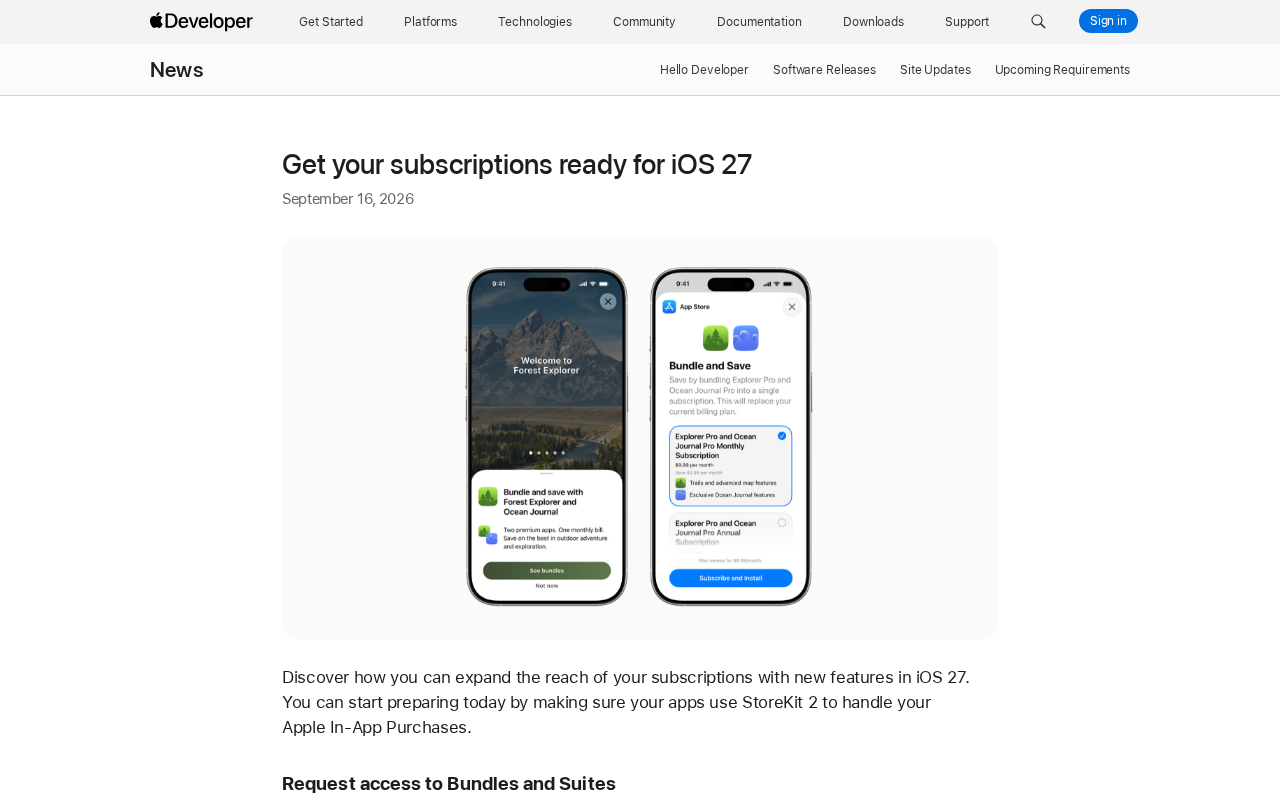
iOS 27订阅新玩法:Bundles、Suites与多席位购买全解析
苹果公布iOS 27订阅新功能:Bundles与Suites支持跨应用、跨开发者打包订阅,Multiseat多席位购买让团队与组织批量采购。本文解析新能力、上线时间节点及开发者应对策略。
TensorRT Edge-LLM实测:Jetson AGX Thor跑MLPerf边缘Agent基准快6.4倍
NVIDIA TensorRT Edge-LLM在Jetson AGX Thor上完成MLPerf边缘Agentic基准测试速度提升6.4倍。本文解析边缘智能体工作负载特点、基准意义及软硬件协同优化对边缘AI落地的价值。