深度
AI 领域长篇解读、行业观察、技术分析 —— 慢下来读一篇。
OpenAI在AIE Code Summit展示Codex新玩法:语音、云端与dots
OpenAI在AI Engineer Code Summit首日展示Codex新工作方式:通过语音引导编码代理、将任务移交云端执行,以及利用dots组织工作上下文,开发者与AI协作的交互模式正在改变。
LLM生成世界模型评估:机械有效不等于语义忠实
一项研究评估五个LLM生成部分可观察随机博弈世界模型的能力,发现机械有效性通过率虽高但结构F1仅0.366,证明可执行性不等于语义忠实,对神经符号推理提出警示。
时间序列基础模型的采样频率不变性:量化评估与关键发现
一项新研究对MOMENT、Chronos-2、Moirai-MoE和TimesFM四个时间序列基础模型进行采样频率不变性压力测试,提出FSI、FDI、CDI三个新指标,发现不变性取决于信号原生采样率与任务所需带宽的余量,为传感器应用中的模型选型提供指导。
单一VLA策略攻克100项家务:BEHAVIOR挑战赛技术解读
2026年BEHAVIOR挑战赛独立团队方案解读:单一VLA模型完成100项长程家务任务,Q值提升至0.392,并探索GPT-6编码智能体混合架构,14项任务Q值达0.639。
分支定界 vs A*:资源约束项目调度中的搜索算法对决
最新研究对比分支定界与A*算法在资源约束项目调度(RCPSP)中的表现,通过480个基准实例实验发现A*凭借重复状态检测显著优于B&B变体,并揭示深度优先搜索的内存优势与LP松弛的权衡。
Re-Search:用20问游戏拆解LLM的科研创意瓶颈
Re-Search研究将科研创意改造成二十问游戏,用200篇ICML论文评测六个LLM,发现模型瓶颈在生成而非判断,前30个问题决定成败,为自动科研系统设计提供新思路。
ReTrace:将工具调用Agent蒸馏为无规划器工作流
ReTrace 将 LLM Agent 执行 SOP 的过程蒸馏为无规划器工作流:从 Agent 推理文本提取步骤条件,合并为规则文档并编译成代码驱动的工作流,在接近 Agent 完成率的同时降低每任务成本与延迟。
对比集替代单一假设:让AI科研智能体从同一证据中解出更多科学问题
Contrastive Discovery 提出用互斥且穷尽的对比集替代单一假设,让LLM科研智能体从同一批证据中解出更多科学问题。本文解析其信念重分配评分机制、与现有智能体的兼容性及人类专家盲评结果。
企业分析Agent评估框架对比:稳定性、检测与发现
基于三种评估范式的对比研究:基于轨迹的LLM评判在已知风险检测中F1达0.90,纯文本评估误报高5倍,功能测试与安全红队发现零重叠,研究推荐功能评估与对抗红队结合的双框架策略。
EM-DETR:基于示例 grounding 的医学病灶检测基础模型
研究提出学生-教师训练策略与示例驱动的EM-DETR框架,整合异构医学图像数据集构建多领域病灶检测基础模型,在胸部X光片和乳腺钼靶上取得SOTA,AUC提升1个百分点,mAP50超越单数据集训练2-3个百分点。
医学图像分割:基础模型微调与任务专用训练谁更胜一筹?
系统对比DINOv2基础模型适配与U-Net任务专用训练在医学图像分割中的表现:基础模型跨机构泛化更优,但分布内边界精度不及数据充足时的专用模型,适配容量由成像域决定。
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。
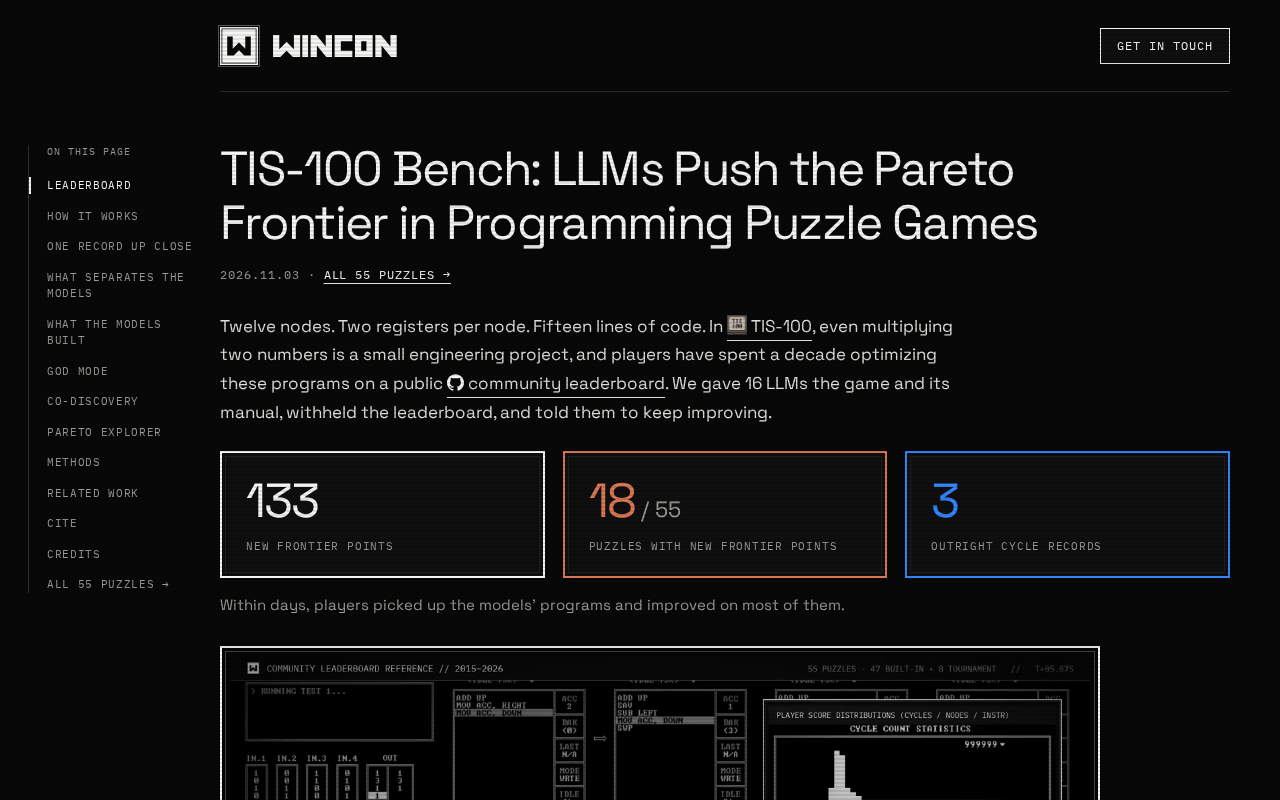
LLM挑战Zachtronics烧脑神作TIS-100
Hacker News上出现让大语言模型游玩Zachtronics硬核编程解谜游戏TIS-100的项目。本文分析TIS-100为何成为检验LLM程序合成与推理能力的试金石,探讨模型在严格指令集下的能力边界及对AI编程工具的启示。
MiniMax H3 Image 上线 AI Gateway:文生图与编辑一key可用
MiniMax H3 Image 与 Highspeed 版上线 AI Gateway,支持文生图与图像编辑、自定义尺寸及 2K/4K 输出,一个 API key 即可调用,无需单独 MiniMax 账户,并兼容 OpenAI 图像路由。
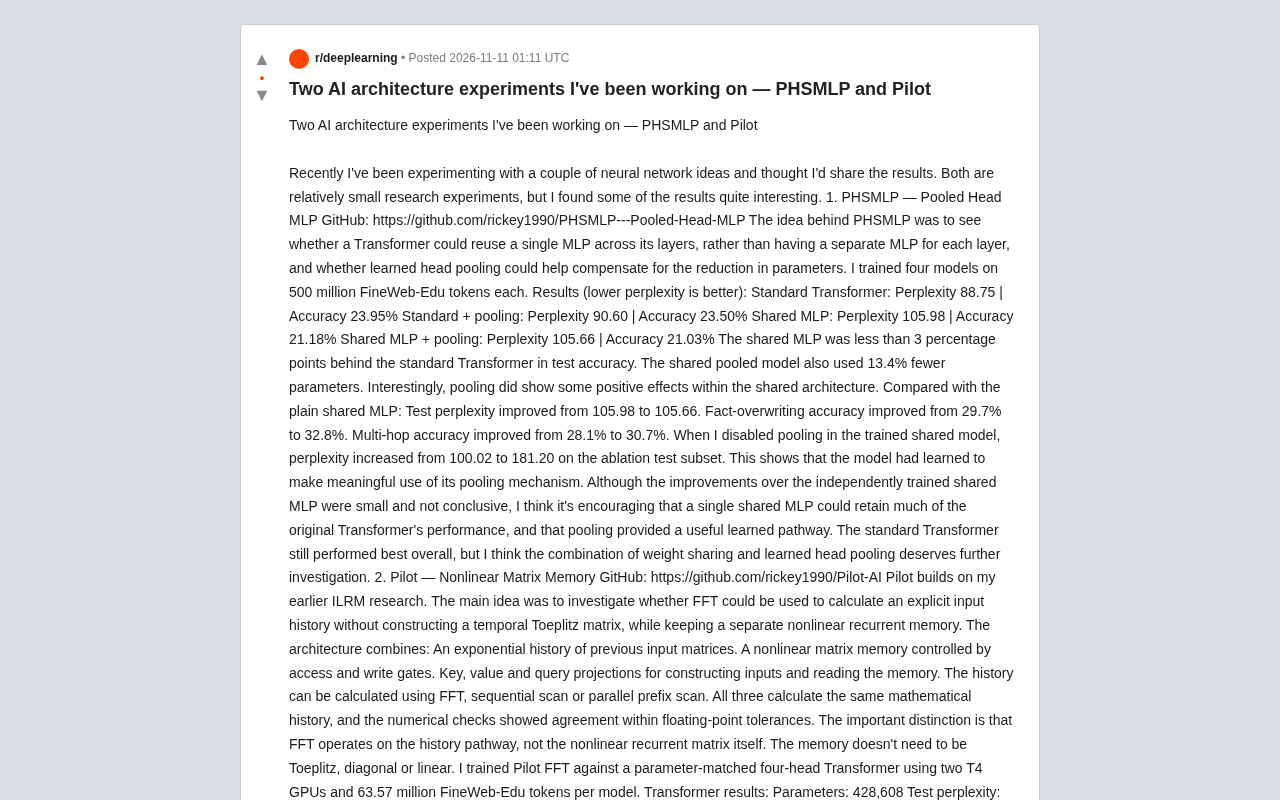
两个AI架构实验:共享MLP与FFT非线性记忆
开发者分享两个小型AI架构实验:PHSMLP用共享MLP减少Transformer参数并验证head pooling的价值;Pilot结合FFT显式输入历史与非线性矩阵记忆,语言建模困惑度低于参数匹配的Transformer,但记忆任务和训练速度仍是短板。
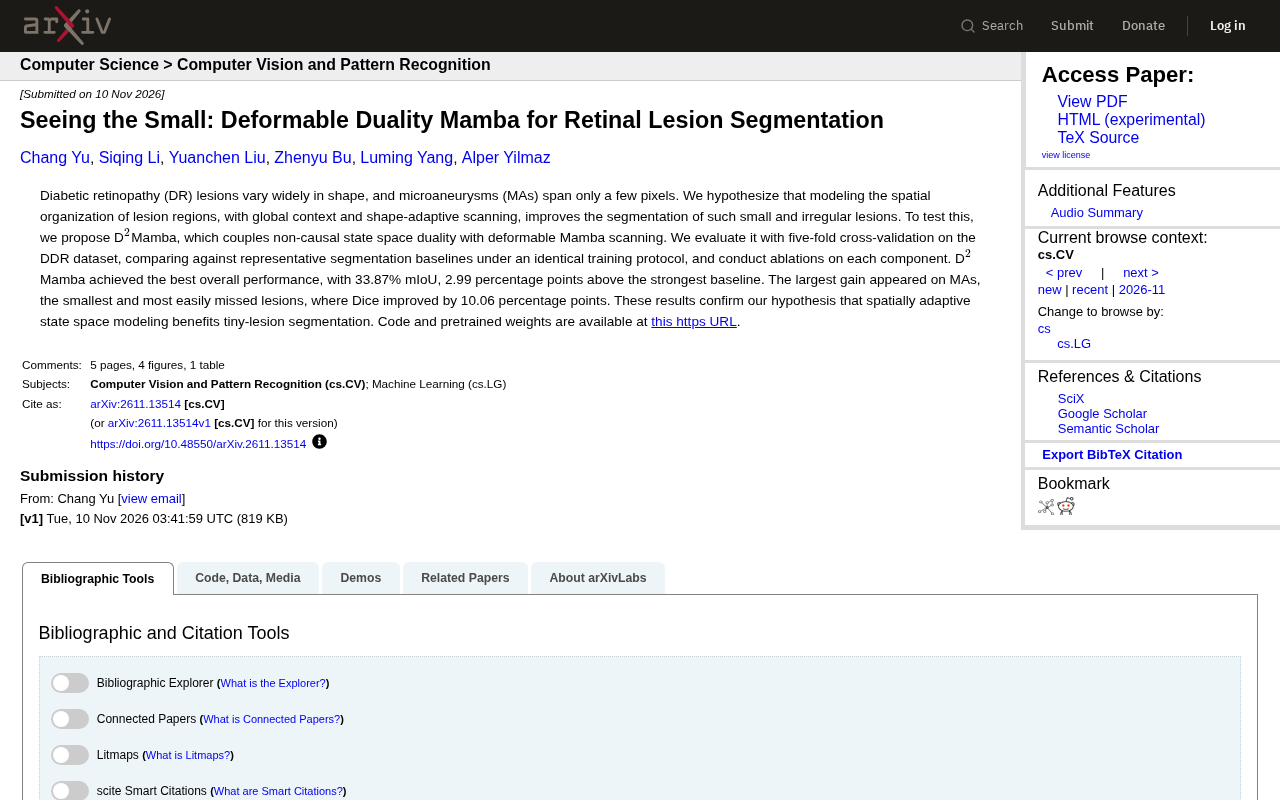
D²Mamba:可变形双态Mamba如何提升视网膜微动脉瘤分割
D²Mamba模型通过可变形Mamba扫描与非因果状态空间对偶性,在DDR数据集上实现33.87% mIoU,微动脉瘤分割Dice提升10.06个百分点,为小目标医学影像分割提供新思路。
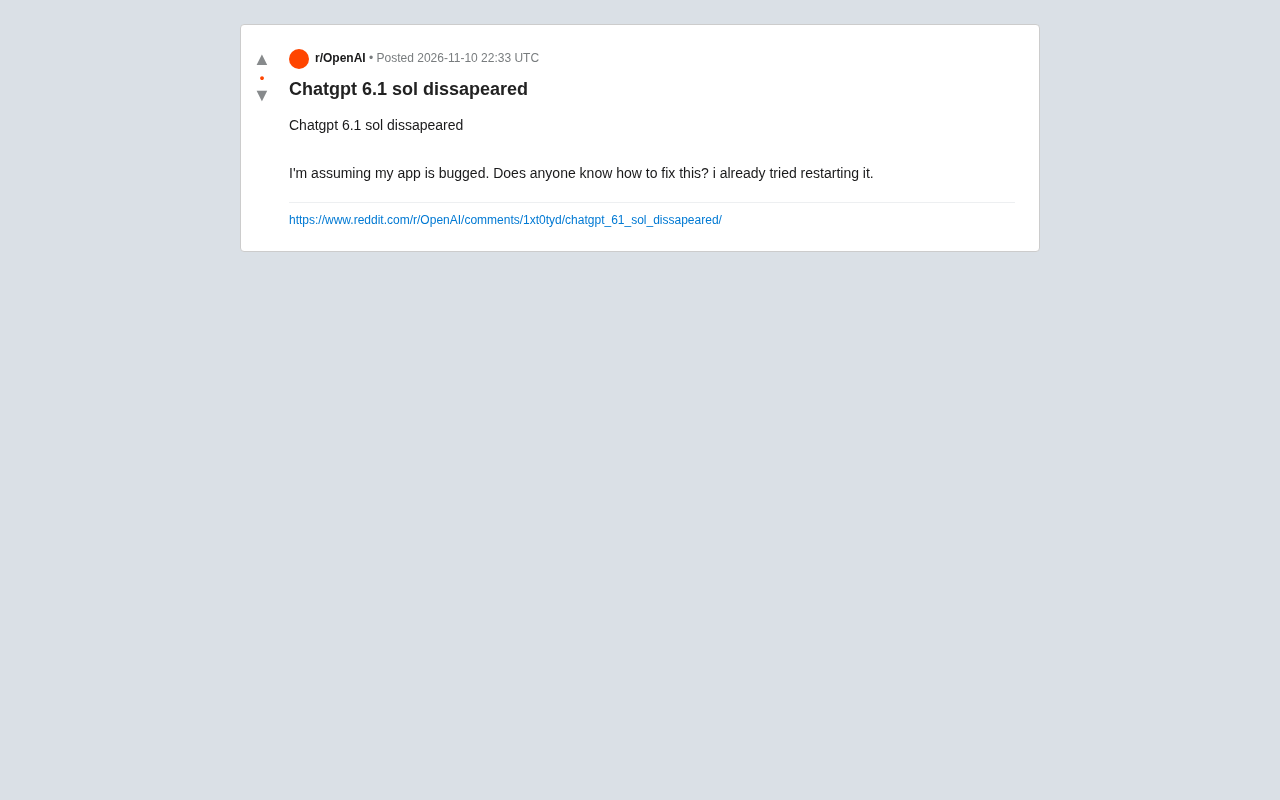
ChatGPT 6.1 Sol 消失?Reddit 用户求助与修复思路
Reddit 用户反映 ChatGPT 6.1 Sol 模型选项消失,怀疑应用 bug。本文分析可能原因并提供修复步骤,包括清除缓存、检查更新、账户状态等,帮助排查问题。
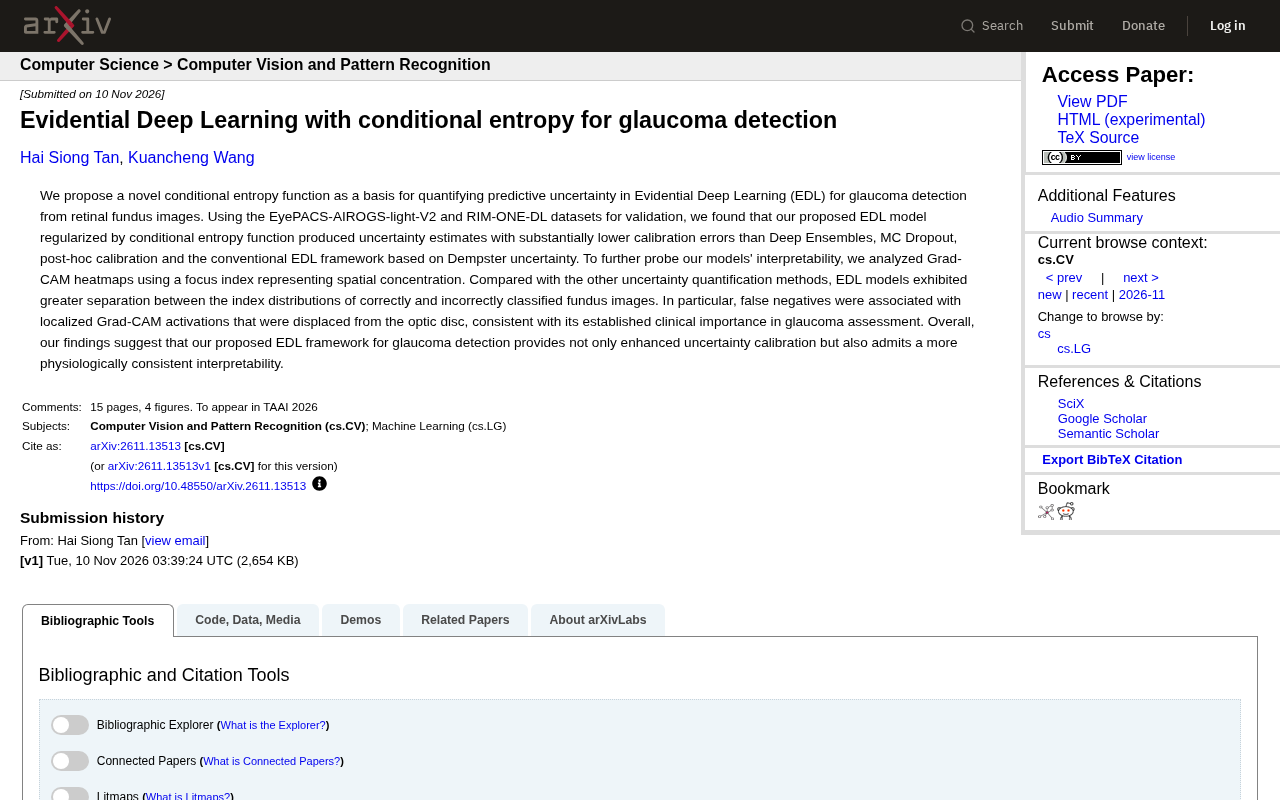
条件熵加持的EDL:青光眼检测的不确定性量化新突破
新研究提出条件熵正则化的证据深度学习框架,在青光眼眼底图像检测中显著降低校准误差,优于Deep Ensembles和MC Dropout,并通过Grad-CAM焦点指数揭示假阴性样本的注意力偏离视盘现象。