#前沿研究
共 9532 篇相关文章

先测量再训练:个人多语言收件箱路由系统的基准测试与洞察
Foyer 研究在 739 封真实邮件上对比九种系统:生产规则准确率仅 28%,逻辑回归基线全面领先,LLM 少样本未弥合差距。关系信息应存入联系人图谱,准确率不等于产品指标。先测量再训练。

Yalda-Embedding:开源波斯语检索模型的突破
Yalda-Embedding 是一个开源的 5.958 亿参数波斯语检索模型,基于 Qwen3-Embedding-0.6B 微调,在八个波斯语检索任务上取得同规模最高分,并通过知识蒸馏显著提升性能,所有资源开源。

AdaBPE:动态频率阈值如何优化混合语料分词
论文提出AdaBPE分词方法,通过长度与类型双重自适应频率阈值,解决传统BPE在混合自然语言与LaTeX符号语料中的边界局限,在提升领域内容编码效率的同时保持通用语言性能。

LLM智能体概率模拟:真与假为何加不到1?
研究发现LLM智能体在意见模拟中无法通过互补一致性检验:将陈述改写为否定并替换概率为1-p后,报告加和不等于1。三个小型开源模型均出现此偏差,幅度是复述变化的2-10倍,且导致模拟群体镜像破缺。研究建议将改写一致性作为标准诊断指标。

J-Comm:雅可比引导的LLM智能体潜在通信新框架
J-Comm提出雅可比引导的LLM智能体潜在通信框架,包含免训练GEAR推理方法与H+J通信接口,在Qwen3-8B到4B通信中七项基准领先,MATH500达94.80%,token减少最高74.8%。
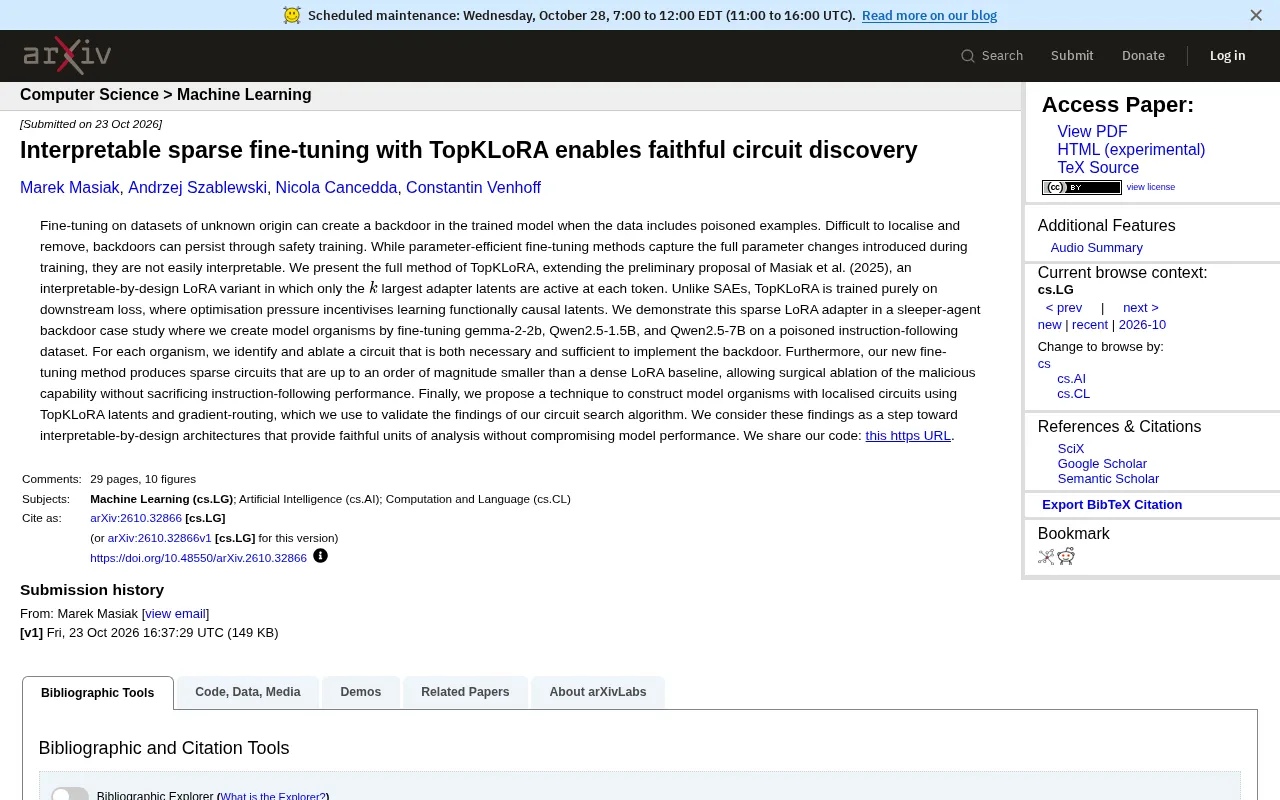
TopKLoRA:稀疏微调如何精准拆除模型后门
TopKLoRA 是一种设计即可解释的稀疏 LoRA 微调方法,每个 token 仅激活 k 个潜变量。论文在 gemma-2-2b、Qwen2.5 等模型上构造后门模型生物,定位并消融必要且充分的后门电路,电路规模比稠密 LoRA 小一个数量级,实现精准清除后门且不损失指令跟随性能。

SPOOK揭示视觉编码器盲区:稀疏像素优化如何攻破语义边界
SPOOK研究通过稀疏像素优化在空白画布上探测视觉编码器,发现OpenCLIP和DINOv3均存在离流形语义误映射的共享失败模式,为表示几何诊断提供简单黑盒探针。

机器翻译能拯救紧急预警吗?一线应急管理者的真实困境
一项全国性调查揭示应急管理者使用商业翻译工具发布多语言预警的真实工作流与质量盲区,并评估机器翻译在紧急响应中的适用边界与安全使用指南。

Bengali农业咨询系统KRISHOKTECH:生成前后的显式授权控制
KRISHOKTECH是一个孟加拉语农业咨询系统,通过在生成前后设置显式授权边界,控制不安全请求。测试显示跨作物检索违规从36.5%降至0%,剂量错误验证器捕获114/118个错误。

SceneBloom:智能体框架生成逼真3D室内场景
SceneBloom是一个智能体框架,结合扩散模型与合约引导的3D编译,自动生成逼真、多样且物理有效的室内3D场景,用于训练具身智能体。实验表明其视觉质量与物理稳定性领先,且训练的策略在真实扫描上成功率更高。
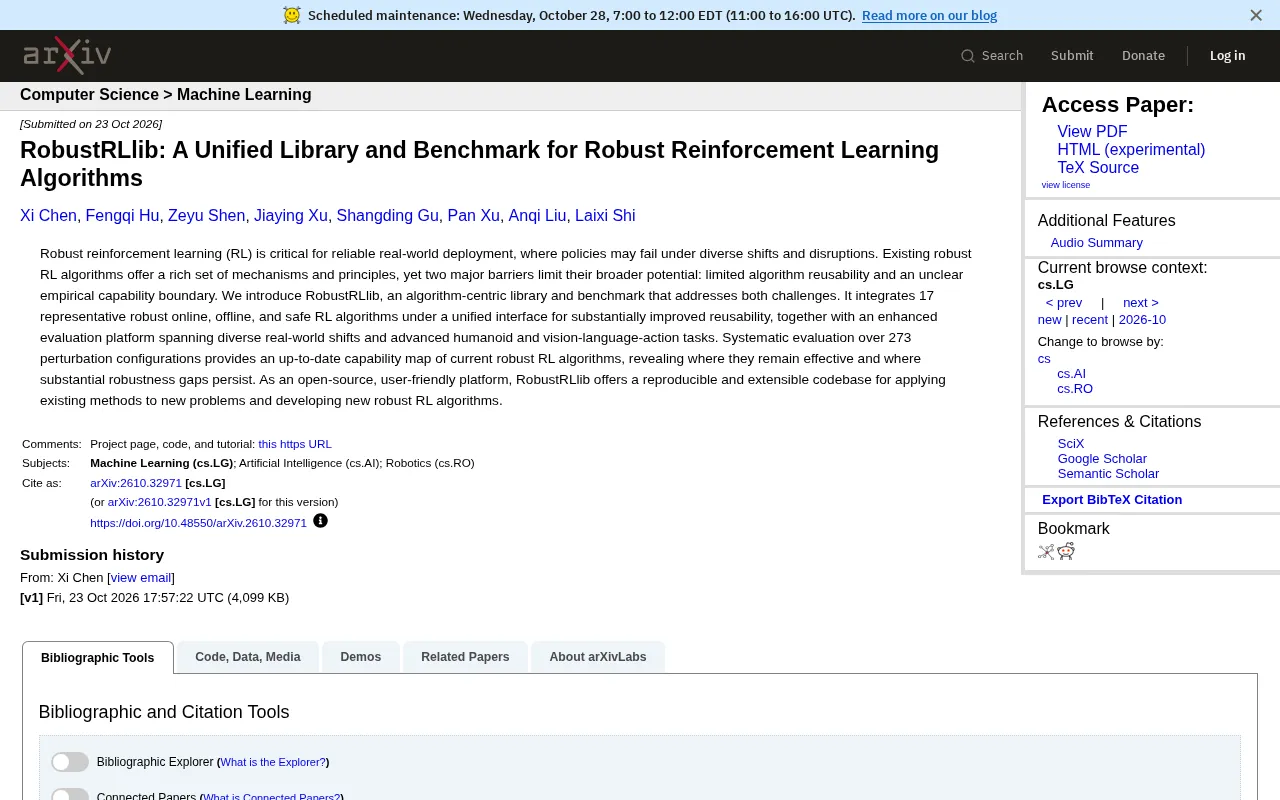
RobustRLlib:17种鲁棒强化学习算法的统一基准库
RobustRLlib是一个统一的鲁棒强化学习算法库与基准,整合17种在线、离线与安全RL算法,覆盖273种扰动配置,揭示当前鲁棒RL的能力边界与差距,开源可扩展。

DexPort:手持技能接口如何破解灵巧手数据采集难题
DexPort 是面向高自由度机器人手的便携数据采集接口,通过手持技能接口记录机器人指令与关节状态,消除具身差距。论文显示使用机器人指令可将任务表现从11%提升至64%,野外数据使成功率从36%升至78%。

HAD-VLM:用扩散模型破解医疗视觉语言模型的数值离散化难题
HAD-VLM提出混合自回归-扩散框架,用扩散过程预测连续测量值,解决医疗视觉语言模型离散token预测的数值精度瓶颈。在超声心动图四项测量任务中误差降低21.4%-37.6%,X射线椎体测量误差从11.4降至6.7像素,同时保留医学问答能力。

LLM平台如何靠广告与订阅赚钱?三大发现揭示定价玄机
LLM平台引入广告时如何设计订阅套餐?研究揭示三大发现:广告补贴导致用户效用分化、适度广告上限可最大化消费者剩余、算力成本下降反而可能推高广告总收入,菜单设计成为评估广告策略的核心。

SemantEq:形式化数学语句的双向等价新方法
SemantEq提出一种更严格的双向等价关系,用于验证形式化数学语句的忠实性。通过要求语句仅通过允许的步骤相互转化,该方法在ProofNetVerif上达到100%精确率,并开源代码。

LLM优化代码反而更耗能?实测44种配置仅2种省电
LLM自我精炼优化代码是否真的更节能?基于EffiBench全部1000题、11个开源模型的硬件级能耗实测显示,44种配置中42种比人类参考解更耗能,超出4%至886%;限制输出token最多省69%推理能耗,MoE架构比解码调参更关键。
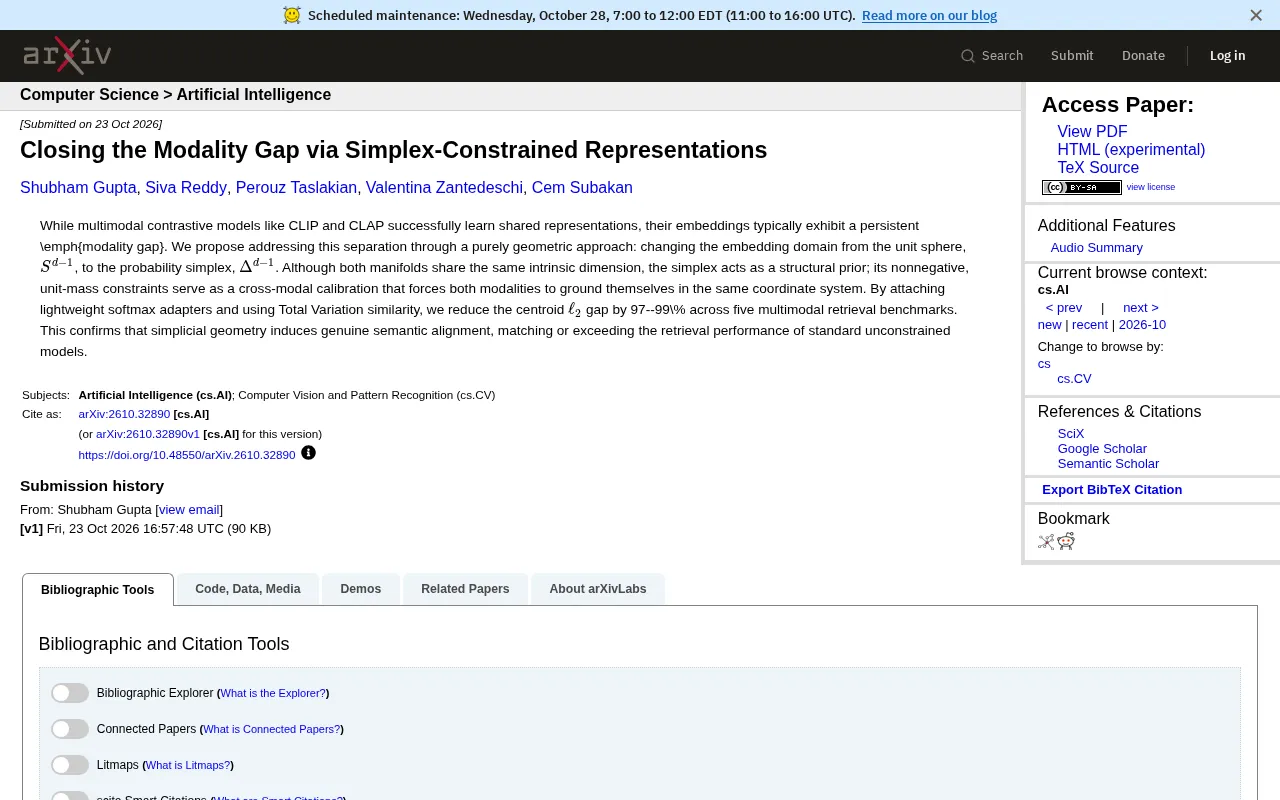
单纯形约束表示:97%消除多模态嵌入模态鸿沟
新论文提出用概率单纯形替代单位球作为多模态嵌入域,通过softmax适配器和全变差相似度,在五个检索基准上将模态鸿沟的质心距离缩小97-99%,检索性能持平或更优。

NgramRL:用Rollout历史加速RL后训练的推测解码新方案
NgramRL 提出用近期 rollout 历史构建按 prompt 的 n-gram 草稿器,无需辅助模型即可加速 RL 后训练的 rollout 生成,热缓存下每次前向提交 3.60-7.77 个 token,Spider 任务吞吐提升 1.38 倍。

