#前沿研究
共 7353 篇相关文章

CALM:文生图安全防护的新思路,局部反事实修正破解全局过滤困局
arXiv 最新论文提出 CALM(反事实自适应局部调制),一种免训练的文生图安全防护方案。它用提示词局部的反事实修正取代全局不安全信号移除,破解覆盖率与选择性的权衡困境,在抑制不安全内容的同时保留良性生成能力。

AI风险观测站:年报披露揭示社会韧性的真相
arXiv最新研究用LLM分析9821份英国上市公司年报,揭示AI风险披露五年激增至41.2%,但仅4.3%具实质内容,供应商集中与关键基础设施披露滞后暴露社会韧性隐忧。

System-1决策模型评测:快模型遇上严谨证据的真相
一篇arXiv研究对开放权重模型Laya和托管模型Jev两款System-1决策模型进行配对评测,并自审评测流程。结果显示托管模型在9/11决策点显著领先,而成本节省等宣称经修正后大幅缩水,揭示AI Agent评测中的隐藏陷阱。

MintFlow:以最小轨迹干预实现约束流匹配采样
MintFlow 是一种无需训练的约束流匹配采样框架,通过对预训练流轨迹的最小干预实现约束满足,同时最大限度保留生成分布。本文解析其核心思路、伴随法闭式解与自适应干预机制。

从部分语音学习何时提交:端到端同声语音翻译新突破
arXiv 最新研究提出基于前缀监督的端到端同声语音翻译方法,无需转录和人工翻译。多轮解码使提交校准误差下降63%-80%,置信度阈值有效平衡质量与延迟,在FLEURS和CoVoST2多语言方向验证有效。

大模型时间抽取任务泛化能力评测:单一维度不可靠
arXiv新研究系统评测大语言模型在时间与事件抽取任务中的多维泛化能力,涵盖领域偏移、对抗扰动、组合性与长度增加四个维度,发现归纳式提示最稳定,单一维度无法可靠预测模型泛化表现。

从检索到类型化决策:生物医学句编码器的System One模型解析
解析arXiv论文SBERT2S1:如何将生物医学句编码器转化为类型化决策模型。深入探讨检索训练对不同决策头的影响、C头与PFR架构对比、RLCD训练目标缺陷及模型校准问题。

神经符号框架破解阿拉伯语句法歧义:准确率达96.88%
一项 arXiv 研究提出生成语言学启发的神经符号框架,结合 AraBERT 解决阿拉伯语句法歧义,准确率达96.88%,宏平均F1为95.92%,为形态丰富语言的句法分析提供可解释路径。
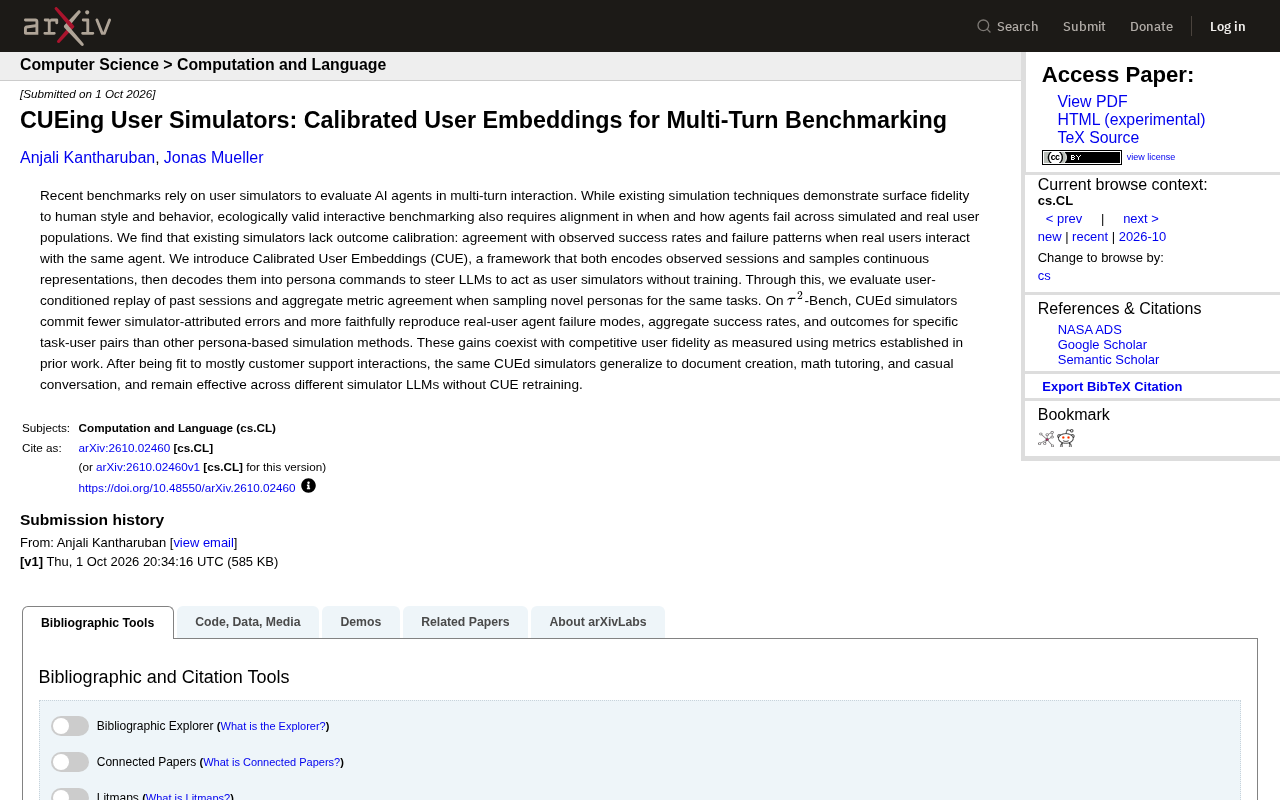
CUE框架:让AI用户模拟器真正贴近真实用户失败模式
arXiv 新论文提出 CUE(校准用户嵌入)框架,解决 AI 用户模拟器缺乏结果校准的问题。无需训练即可让模拟器更忠实复现真实用户导致的智能体失败模式,并在 τ²-Bench 及多场景中展现泛化能力。

APDMem:让AI助手用8%的数据实现长期记忆精准检索
APDMem提出智能体控制的渐进式披露记忆架构,用四层分层结构和自适应检索控制器,在LongMemEval基准上仅访问8%对话即实现强劲的长期记忆推理性能。

反例生成新突破:符号验证器揭示模仿学习陷阱与强化学习修复之道
arXiv 新论文 SymCE 通过每定理符号验证器揭示大模型反例生成中的模仿陷阱:监督微调会让真定理识别能力崩溃,而强化学习不仅修复还超越基线。4B 模型表现超越 7B 专用模型并可泛化到主流数学基准。
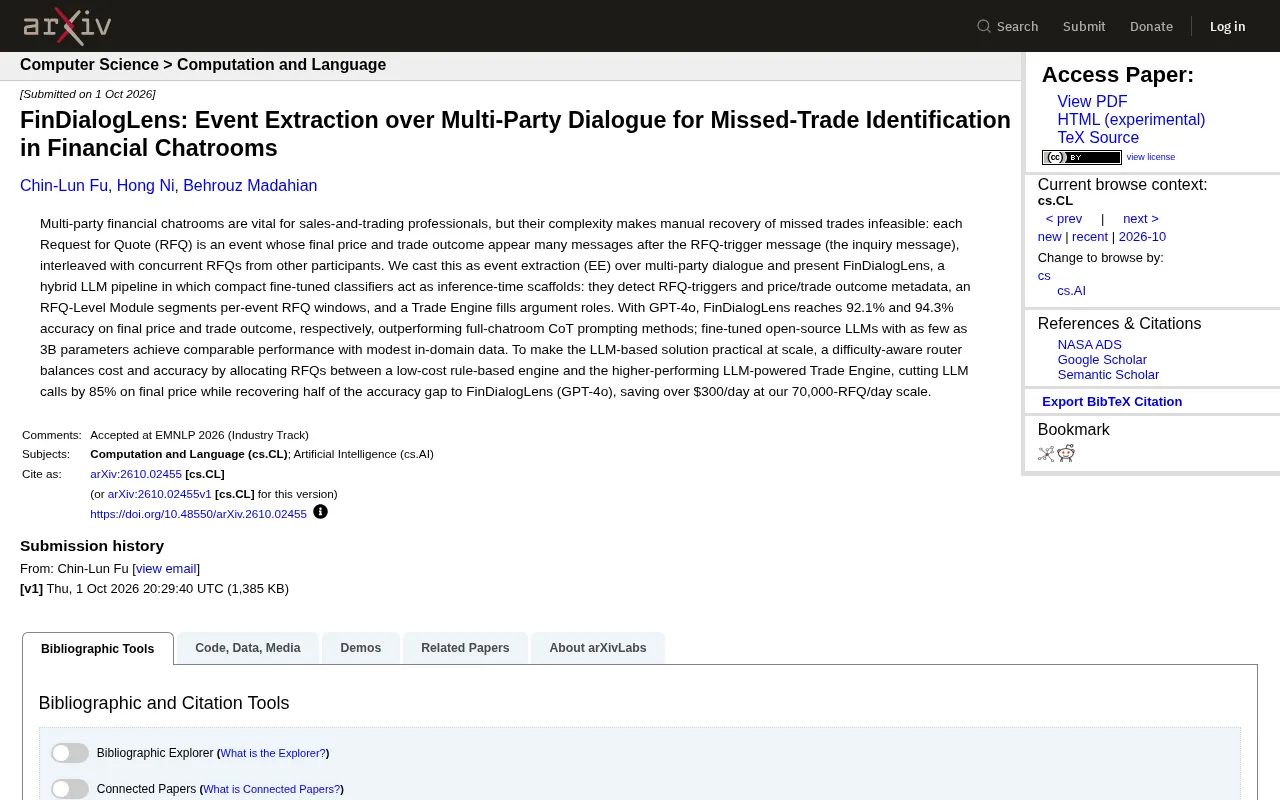
FinDialogLens:用事件抽取从金融聊天室中找回漏单交易
arXiv 论文 FinDialogLens 提出混合 LLM 流水线,将金融聊天室漏单识别建模为多方对话事件抽取,GPT-4o 下价格与成交准确率达 92.1%/94.3%,并通过难度感知路由削减 85% 调用、日省 300 美元。

XiangqiBench:中国象棋揭示LLM智能体的闭环短板
arXiv 新研究 XiangqiBench 以中国象棋残局为载体,提出 LLM 智能体的闭环评估基准,揭示转化差距、一致性差距与模拟差距三大短板,指出找到好棋不等于赢得整盘棋。

HakemBench:土耳其语「类型化决策」基准测试解析
HakemBench 是一个 CC BY 4.0 开源的土耳其语「类型化决策」基准测试,含 2346 条目、7 大赛道,从决策质量、校准度和选择性自动化三维度评测大语言模型,并坦诚披露标签非人工核验及自评数据污染问题。

低成本安全主动式AI Agent架构:三层设计避坑指南
如何构建低成本、安全的主动式 AI Agent?本文拆解一套三层架构:沙箱边缘执行、System 1 决策模型、System 2 完整 Agent 循环,从结构上解决入站监听的成本陷阱与提示注入安全风险。

评估LLM与Agent工作流为何这么难?现实场景中的基准测试困境
来自研究者社区的讨论揭示了现实LLM与Agent工作流评估的核心难点:多工具协作、过程正确性、评估环境成本等。本文梳理现有基准测试的盲区与跨行业需求,为AI工程实践者提供评估思路参考。

多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。
xAI的Agent优势:把X实时数据变成模型工具
解析xAI为Grok打造的Agent能力:将X实时数据与Web作为模型工具,支持服务端工具调用、OpenAI兼容API和Beta多Agent架构。深入剖析其作为实时工具层的优势与作为完整Agent操作系统的不足。

