#前沿研究
共 7132 篇相关文章
GPT-6.1 Sol与Grok 4.7登陆Databricks:前沿模型竞速背后的企业治理难题
OpenAI GPT-6.1 Sol 与 SpaceX AI Grok 4.7 同日登陆 Databricks,分别在成本-质量与企业文档解析基准领先。Unity Gateway 提供统一的模型选型、治理与成本控制,揭示前沿模型竞速背后的企业治理新逻辑。
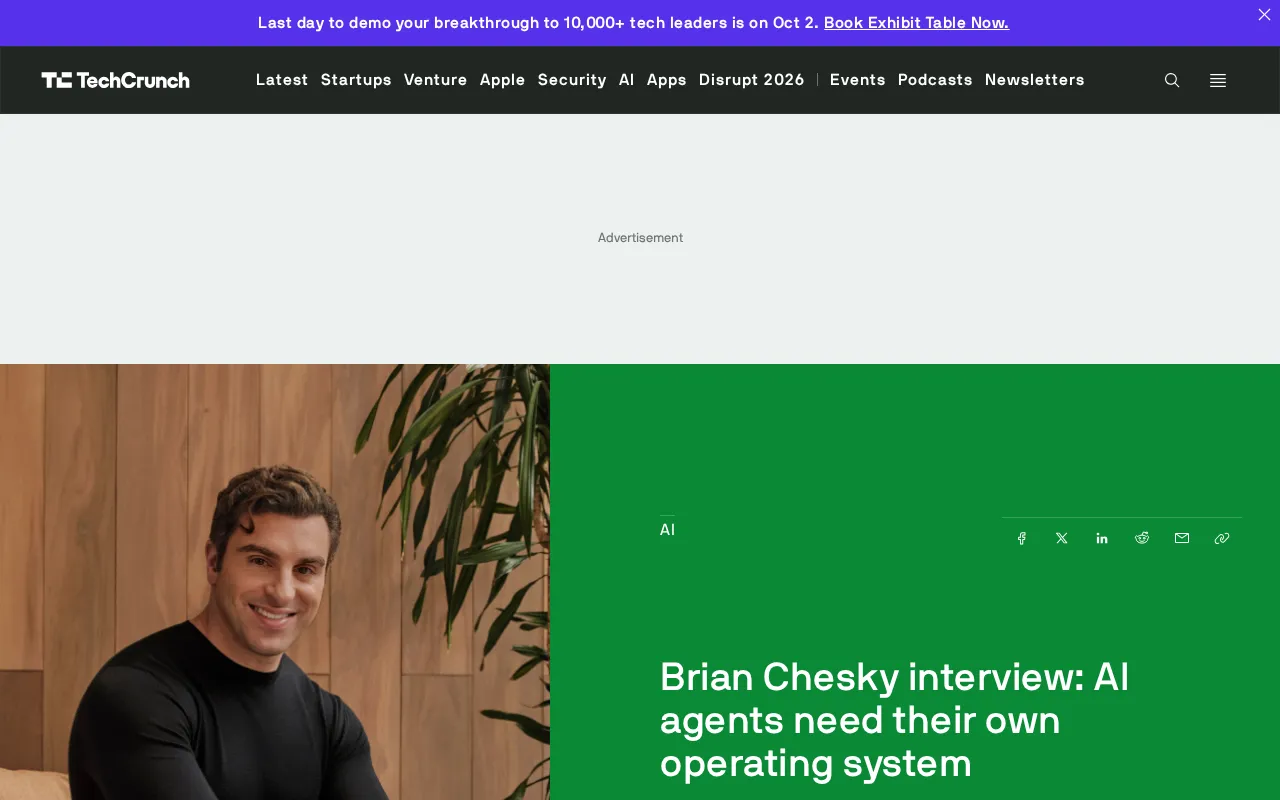
Brian Chesky:AI智能体需要专属操作系统
Airbnb CEO Brian Chesky在访谈中提出AI智能体需要专属的AI原生操作系统,并谈及如何让平台对智能体友好、消费级AI的现状与挑战,揭示AI浪潮下的生态重构趋势。
MCP网关横评:Cloudflare、Okta、Auth0与微软怎么选
Cloudflare、Okta、Auth0 和 Microsoft 均推出 MCP 网关。本文横向对比四家在认证、日志与定位上的差异,并解析接入网关后 MCP 服务器仍需自行承担的业务授权责任,帮你做出选型决策。
智能体AI时代的身份管理:OpenID基金会白皮书解读
智能体AI时代的身份管理:OpenID基金会白皮书解读
OpenID基金会发布智能体AI身份管理白皮书,探讨当AI能够自主行动时传统身份与访问管理体系面临的挑战,提出独立智能体身份、短生命周期令牌、可验证委托链等关键主张,为Agentic AI的安全落地提供框架。
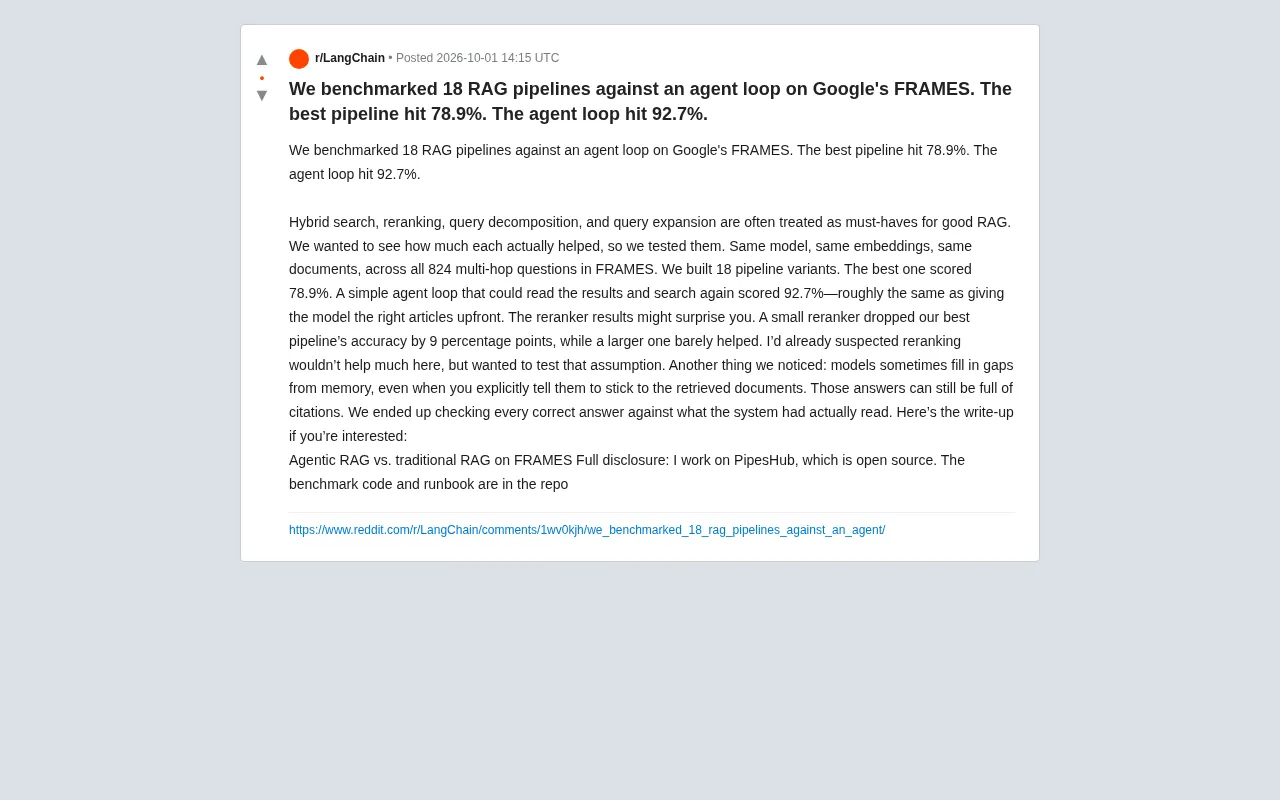
Agentic RAG实测:Agent循环以92.7%碾压传统管道
PipesHub 在 Google FRAMES 基准上对比 18 个 RAG 管道与 Agent 循环:最佳传统管道仅 78.9%,Agent 循环达 92.7%。实验还揭示重排器可能降低准确率、模型凭记忆脑补等关键发现。
GitHub Universe 2026:10场值得关注的技术演讲前瞻
GitHub Universe 2026 大会前瞻:官方列出的技术演讲清单聚焦 AI 生成代码验证与 npm 依赖安全两大主题,本文解读背后反映的软件工程趋势与开发者应对思路。
RLTL;DR:让AI从失败中总结经验实现自我提升
RLTL;DR提出一种让AI从失败中自我提升的新方法:在每次失败尝试后,让模型根据验证器输出写出一条TL;DR式洞见,并用它指导下一轮尝试,破解了强化学习在零成功样本场景下的困境。
强Agent做自主机器学习,到底需要多复杂的脚手架?
自主机器学习工程(MLE)Agent正在排行榜上快速进步,但复杂的多Agent脚手架是否仍必需?本文探讨强编码Agent通过read/write/bash直接访问环境的极简路线,剖析智能应放在模型还是系统架构中的核心权衡。
RNN训练提速100倍:时间并行方法攻克混沌系统重建难题
NeurIPS 2026 Spotlight论文提出时间并行训练方法,结合DEER与广义教师强制(GTF),将混沌动力学系统上的RNN训练提速超100倍,并在动力学系统重建任务中超越Mamba等状态空间模型。
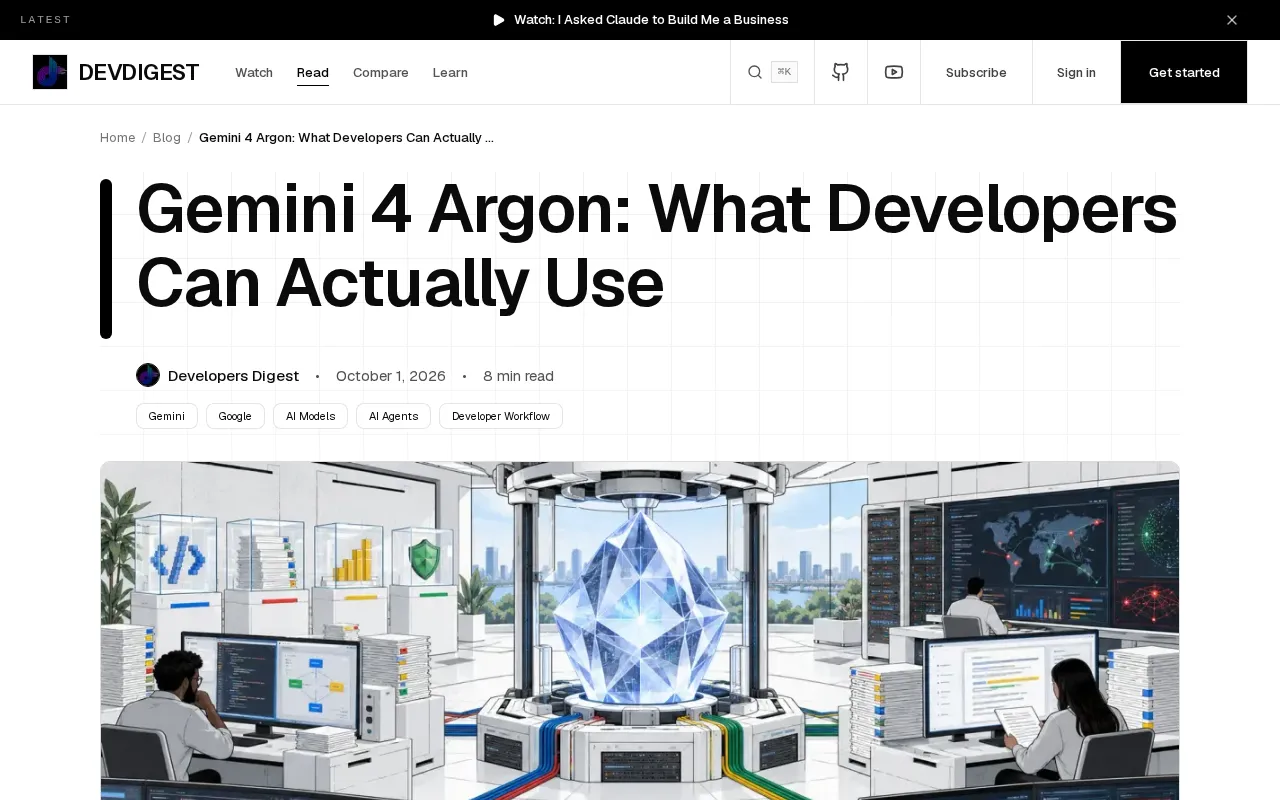
Gemini 4 Argon发布:开发者现在能用到什么?
Google发布前沿模型Gemini 4 Argon,主打编程与企业工作流能力,但初始访问受限。本文梳理已上线内容、待验证能力及开发者应对策略。
四个Claude中藏一个Kimi:AI能揪出"卧底"模型吗?
一场有趣的AI实验:把一个Kimi藏进四个Claude中,Claude靠多提示行为指纹法加SHA-256哈希校验成功揪出卧底,而Kimi反向识别却失败。本文解析其背后的评测协议设计原理。
Gemini 4 Argon的100万Token输出窗口:范式革命还是营销噱头?
Gemini 4 Argon 传闻拥有 100 万 token 输出窗口,约 1400 页文本。本文剖析超大输出窗口对智能体工作流的意义,探讨它是解决上下文漂移的范式跃迁,还是会导致长程逻辑崩塌的营销噱头。

AI"读心术"问世:仅凭脑部扫描重建你眼前所见
一款新AI工具能仅凭大脑扫描数据重建人眼前所见的画面,被称为AI"读心术"。本文解析其技术原理、医疗应用前景以及随之而来的隐私与伦理挑战。
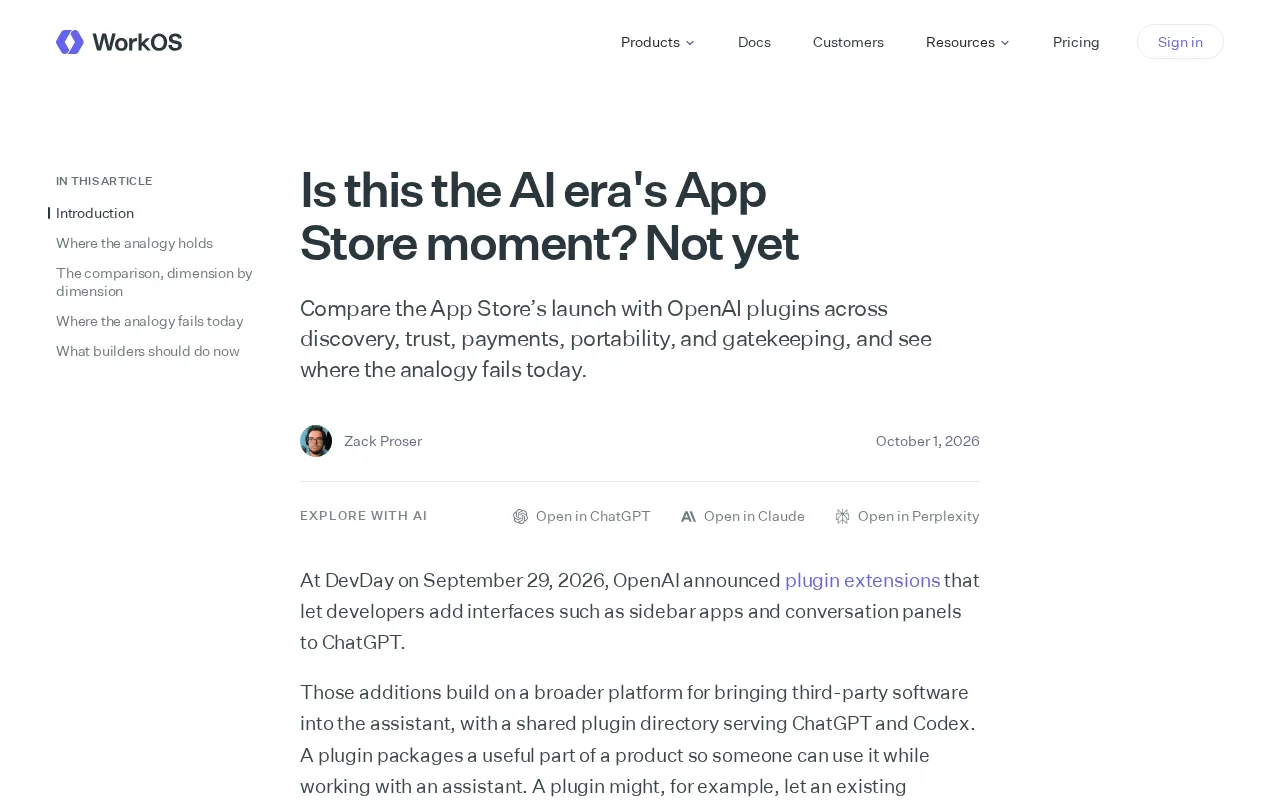
AI的App Store时刻还没到:五个维度看清差距
OpenAI插件生态真的是AI时代的App Store时刻吗?本文从发现、信任、支付、可移植性、守门五个维度对比苹果App Store与当前AI应用生态,拆解类比为何在今天大多失效。
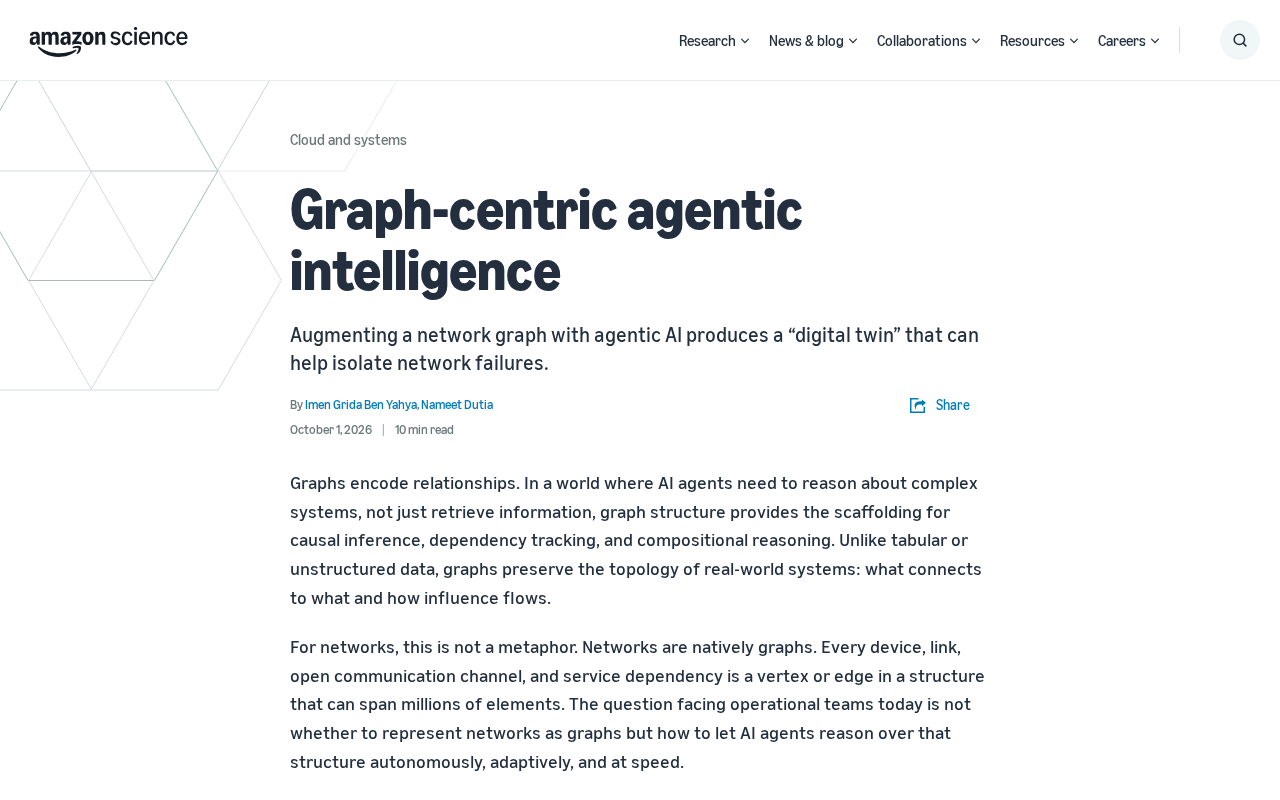
图谱驱动的智能体AI:构建网络运维数字孪生
将网络图谱与智能体AI结合可构建网络数字孪生,实现故障的自主定位与隔离。本文解析图谱驱动的智能体智能在网络运维中的原理、价值与落地挑战。
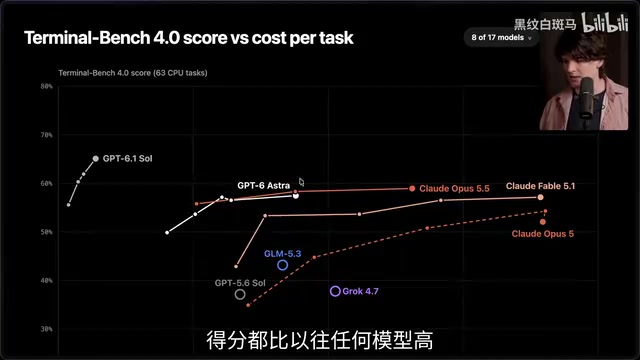
GPT-6.1 Sol深度实测:OpenAI用极致性价比反击Opus 5.5
OpenAI发布GPT-6.1 Sol深度实测:以仅为Opus 5.5数十分之一的成本追平其基准表现,缓存读取价格再砍半。本文解析其极致性价比、稳定性提升、代码审查优势与前端短板,以及对AI补贴时代的影响。
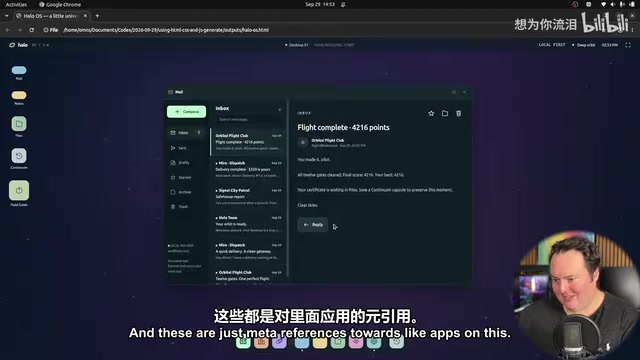
GPT-6.1 Sol 实测:3D任务不敌Claude Opus 5.5?
GPT-6.1 Sol 实测对比 Claude Opus/Sonnet 5.5。同价位下,Sol 在 3D 游戏生成上不及 Sonnet,但在场景复刻、视觉理解和 token 效率上表现亮眼。附泳池派对、滑板游戏、Jerry 公寓复刻等多项测试细节。
揭秘URSALA、RAQUEL与FARRAH:绝密侦察卫星迷局
美国绝密侦察卫星 URSALA、RAQUEL、FARRAH 近期在技术社区引发热议。本文梳理这类机密航天资产的可能任务类型、公开情报(OSINT)分析手段及其背后的保密与透明议题。