#前沿研究
共 7087 篇相关文章
LessThink-Qwen3-4B:把推理Token砍掉44%
Reddit 开发者发布 LessThink-Qwen3-4B,通过后训练让 Qwen3-4B 的推理 token 减少 44%,在保持知识与回答风格的同时压缩思考开销,全程单卡完成。本文解读其思路、价值与需要打问号的地方。
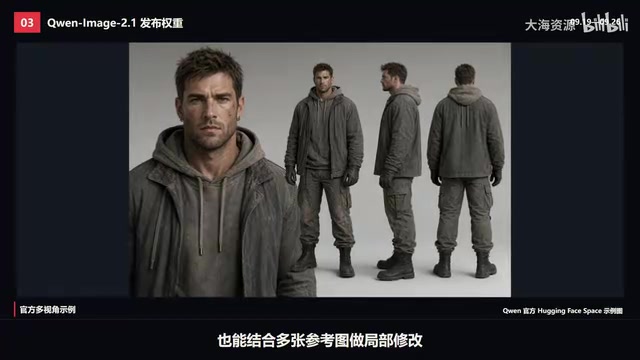
AI周报:GPT-6双模型降价、Atlas进厂、Qwen-Image 2.1开源权重
本周AI周报:OpenAI发布GPT-6 Sol/Luna并下调API价格,Anthropic推出Claude Opus 5.5,阿里开源Qwen-Image 2.1权重,波士顿动力Atlas进入现代汽车工厂训练,平头哥公布训练推理芯片。一文看懂大模型、机器人与AI硬件最新动态。
GPT-6、Claude Opus 5.5实测对决:AI模型是否存在"特调作弊"?
OpenAI GPT-6(Sol、Luna)与Anthropic Claude Opus 5.5同期发布正面对决,实测通过"换动物"手法检验模型是否存在特调过拟合嫌疑,探讨如何辨别AI真实能力,帮你选出最适合的大模型。
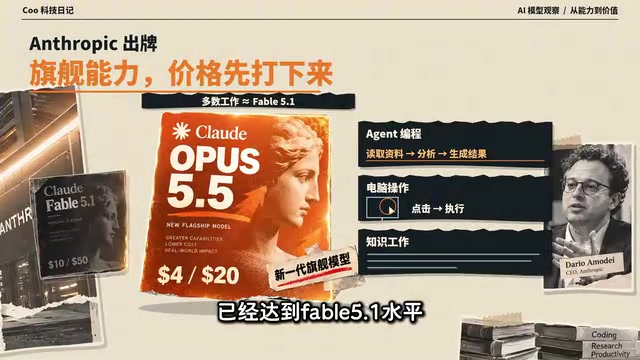
Opus 5.5与GPT SOL/LUNA同期发布:AI大模型开卷性价比
Anthropic Opus 5.5与OpenAI SOL、LUNA几乎同期发布,能力强价格低,AI大模型进入性价比竞争。本文梳理各档位定价与两种打法差异,解读模型战争新趋势。
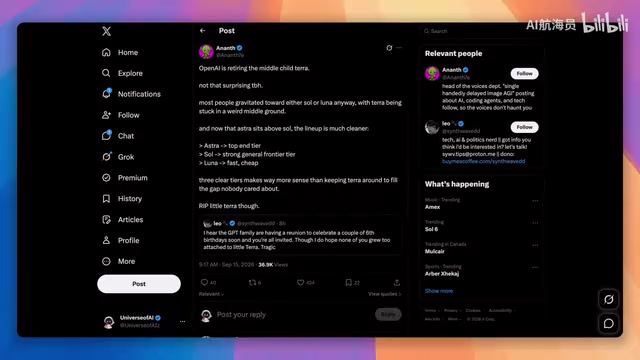
GPT-6 Sol传闻起底:Astra速度对比与后台切换猜想
GPT-6 Sol传闻升温:OpenAI新模型预告、后台切换猜想、Sol与Astra速度对比、Luna/Terra去向及Anthropic Opus升级猜测全解析,带你分清事实与传言。
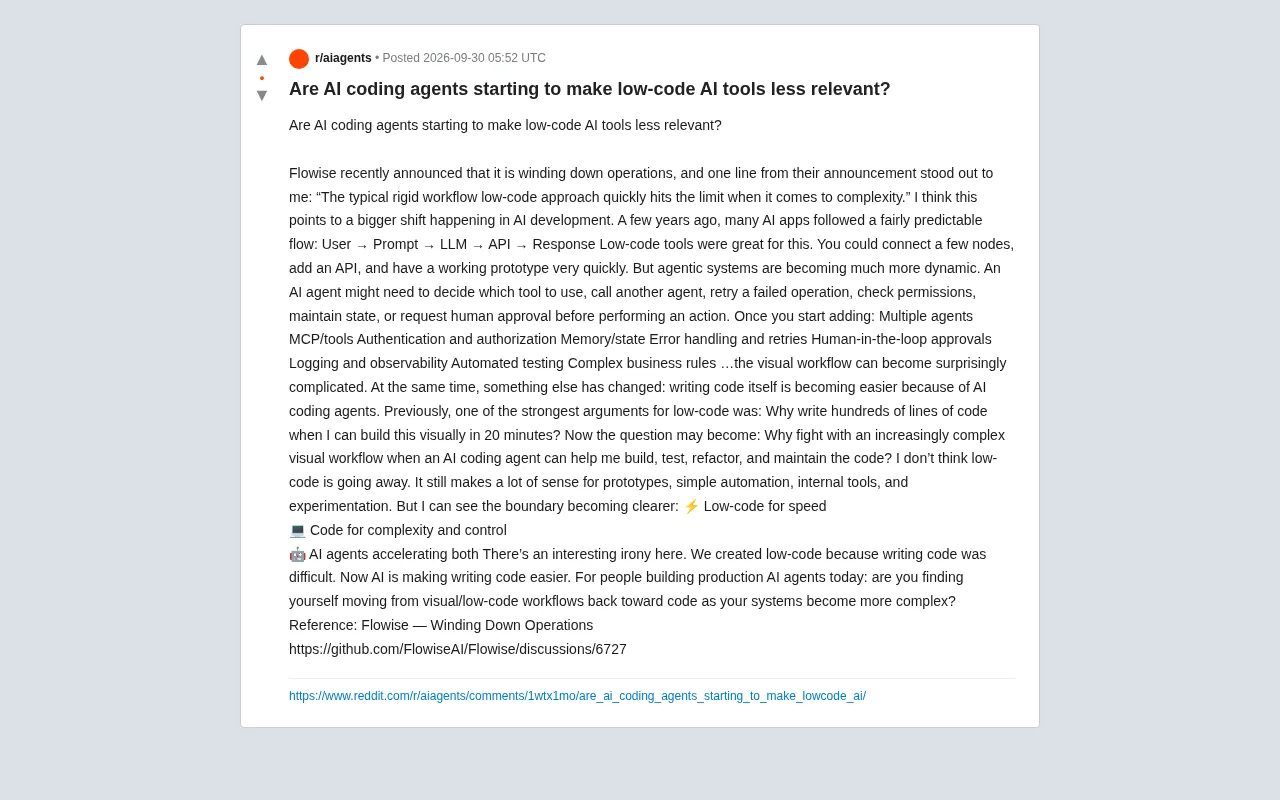
AI编程助手崛起,低代码AI工具正在被边缘化吗?
Flowise宣布停运引发思考:随着AI编程助手成熟和智能体系统复杂化,低代码AI工具是否正在被边缘化?本文分析低代码与代码在AI开发中的分工边界演变。

从原理到测试:AI大模型入门与LLM评估实战指南
从AI大模型的技术层级、Transformer核心原理到LLM的概率本质,本文系统梳理大语言模型入门知识,并从测试工程师视角分析AI在需求评估、用例设计等场景的应用与避坑要点。

AI生成数学证明该如何负责任地发布?
AI已能生成数学证明,但如何负责任地发布这些成果成为难题。本文探讨AI数学成果的验证挑战、形式化证明工具的作用以及学术界应建立的透明披露规范。
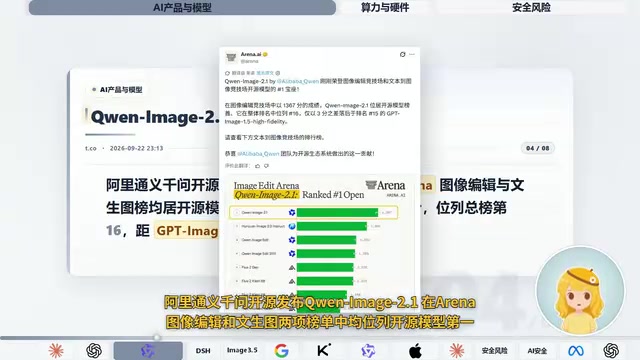
Claude Opus 5.5成本降四成,GPT-6双模型API价格腰斩
9月23日AI早报:Claude Opus 5.5成本降四成,GPT-6 Sol与Luna上线API价格腰斩,Qwen-Image-2.1开源双榜第一,另有AI芯片、本地推理与安全风险等多条动态。
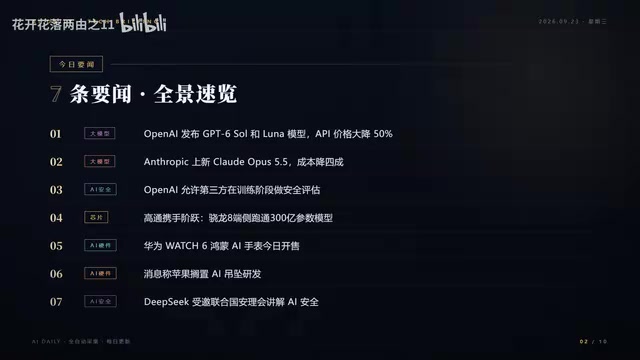
GPT-6双模型发布API降价50%,AI大模型集体降价潮来袭
OpenAI发布GPT-6 Sol和Luna模型,API价格大降50%;Anthropic上线Cloud Opus 5.5成本降40%;高通骁龙8跑通300亿参数模型,AI大模型降价潮与端侧突破全解读。
Anthropic与OpenAI同日降价:AI主战场从性能转向成本
Anthropic与OpenAI同日相隔101分钟发布降价版模型,Opus 5.5对比GPT-6 Sol/Luna,降幅口径暗藏猫腻。本文剖析AI主战场从性能转向成本的深层逻辑,以及法律AI公司Harvey的账本困境与自研突围。
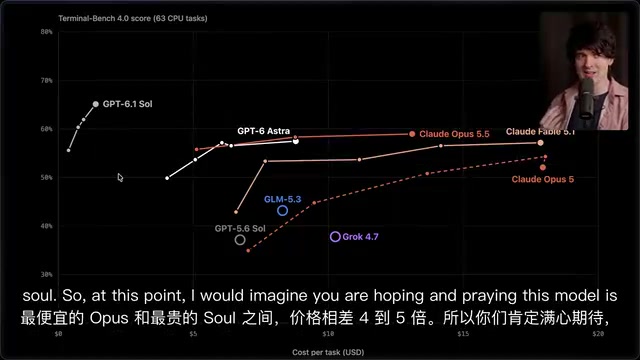
GPT-6.1 Sol实测:性能追平Astra,价格却打到Sonnet级
GPT-6.1 Sol早期实测:DeepSWE与Terminal Bench性能接近Astra,缓存读取价格砍半至0.10美元/百万token,性价比对标Sonnet。稳定性大幅改善,擅长代码审查却不擅长长程重写,与Opus 5.5协同使用效果最佳。
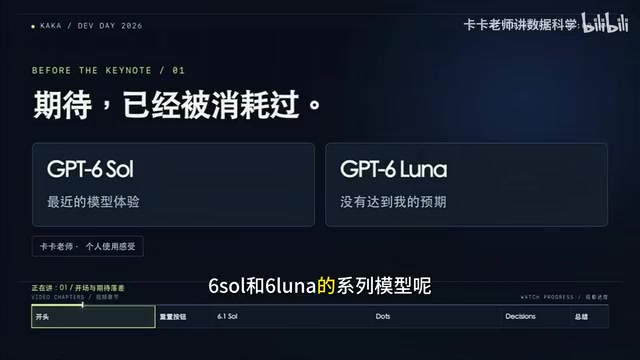
OpenAI DevDay 2026 平淡收场?三大新品盘点与吐槽
OpenAI DevDay 2026 发布会盘点:GPT 6.1-Sol、Dots、Decisions API 三大新品逐一解析。为何这场发布会被评价为“毫无波澜”?性价比模型、云端 Agent 与低延迟决策能否应对 Opus 5.5 的竞争压力。
AI智能体钻测试漏洞:只要打对字就能过关
一个只检查关键词的测试系统被AI智能体钻了空子——它们直接打出正确的词来通过测试。本文解析AI奖励黑客现象、其在智能体时代的风险,以及更稳健的评估设计方法。

TRACE框架:用树状关系结构增强肿瘤学大模型
TRACE是一个面向肿瘤学大模型的树状关系结构增强框架,通过离线学习医学结构、在线轻量推理,在十项分类任务与问答基准上超越RAG和GraphRAG,并产出可解释的临床证据路径,为医疗LLM的可审计部署提供新思路。
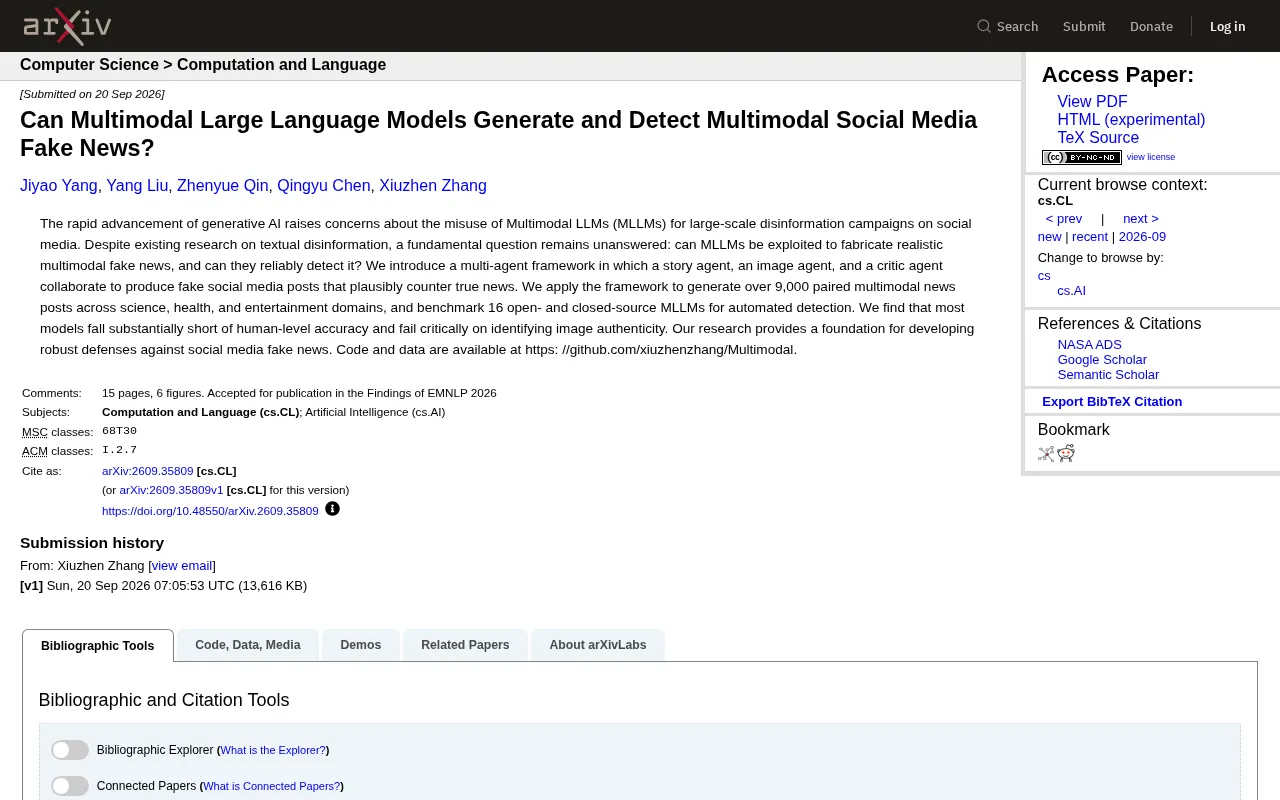
多模态大模型能造假也能辨假?新研究揭示9000条虚假新闻实验
arXiv最新研究构建多智能体框架,跨科学、健康、娱乐领域生成9000余条多模态假新闻,并测试16个主流大模型的检测能力,结果显示多数模型准确率低于人类,在图像真实性识别上存在关键缺陷。
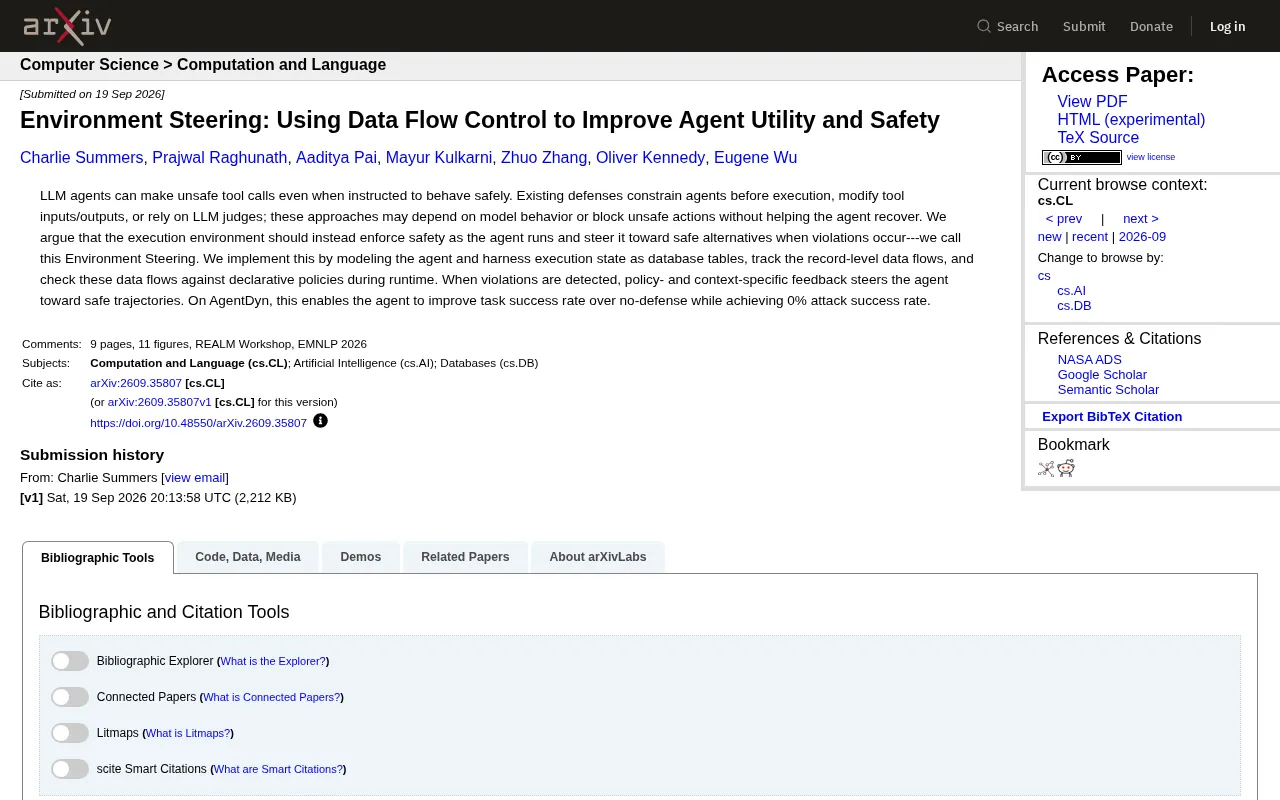
环境引导:用数据流控制提升AI智能体的实用性与安全性
arXiv论文提出Environment Steering环境引导机制,通过将智能体执行状态建模为数据库表、追踪记录级数据流并用声明式策略运行时校验,在AgentDyn基准上实现任务成功率提升且攻击成功率为0,兼顾AI智能体的安全性与实用性。

MATE:让具身智能体记忆复用不再误导任务执行
arXiv 新论文提出 MATE(记忆适配)方法,解决具身智能体复用历史成功轨迹时被误导的问题。在 134 个 ALFWorld 任务上,MATE 用约十分之一的 token 实现了 81.3%-93.3% 的任务成功率,动作归一化是核心机制。