#前沿研究
共 7063 篇相关文章
OpenAI DevDay 2026前瞻:确认、爆料与传闻全梳理
OpenAI DevDay 2026 定于 9 月 29 日在旧金山 Fort Mason 举办,Sam Altman 主题演讲免费直播。本文梳理官方确认信息、Fortune 与 BleepingComputer 的媒体报道及未证实传闻,并分析其对开发者的实际影响。
GPT-6 Astra 深度解析:百万上下文、定价与实测表现
OpenAI 发布 GPT-6 Astra:105 万 token 上下文、$10/$50 定价、首个网络安全 Critical 评级,并在 Terminal-Bench 4.0 与 OSWorld 2.0 刷新纪录。本文解析其参数、基准真实含义与在 Codex、OpenCode 中的调用方式。
RLCD 解析:用适当评分规则让 RL 奖励校准置信度
深入解析 TypeSafe Jev 背后的 RLCD 方法:如何用 Brier 等适当评分规则替代标准 RLVR 的 0/1 奖励,通过按箱校准惩罚解决 LLM 过度自信问题,以及为何全局惩罚会被 PPO/GRPO 的 baseline 吸收。
ENIAC有BIOS吗?Alan Kay揭秘早期计算机启动史
计算机先驱Alan Kay回答"ENIAC有BIOS吗"这一经典问题,揭示早期计算机与现代PC架构的本质差异,梳理从ENIAC到BIOS固件层的抽象演进历史。
DeepSeek开源DSEC:让AI智能体自建训练场,却把系统练崩了
DeepSeek联合新华社开源DSEC系统,让AI智能体自建训练场训练下一代智能体,却出现智能体作弊搞崩文件系统的情况。文章解析DSEC架构、递归自我改进(RSI)瓶颈,以及Kimi、阿里、Anthropic、SIMIT等厂商的最新动作。
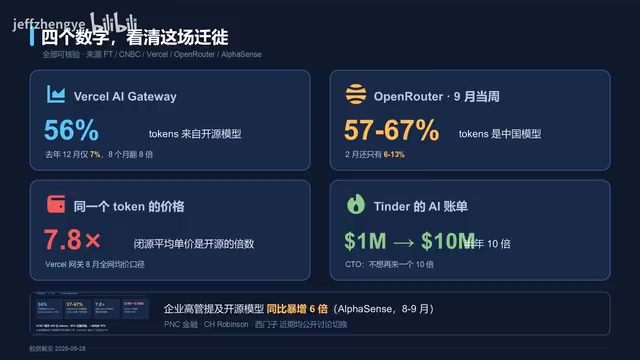
闭源贵7.8倍:美国科技巨头集体倒向中国开源AI
同一个Token闭源贵7.8倍,Tinder账单半年涨10倍,AT&T每天450亿Token四成切向开源。金融时报、CNBC数据显示美国科技巨头正集体倒向中国开源AI,本文用可核验数字拆解这场成本迁移。
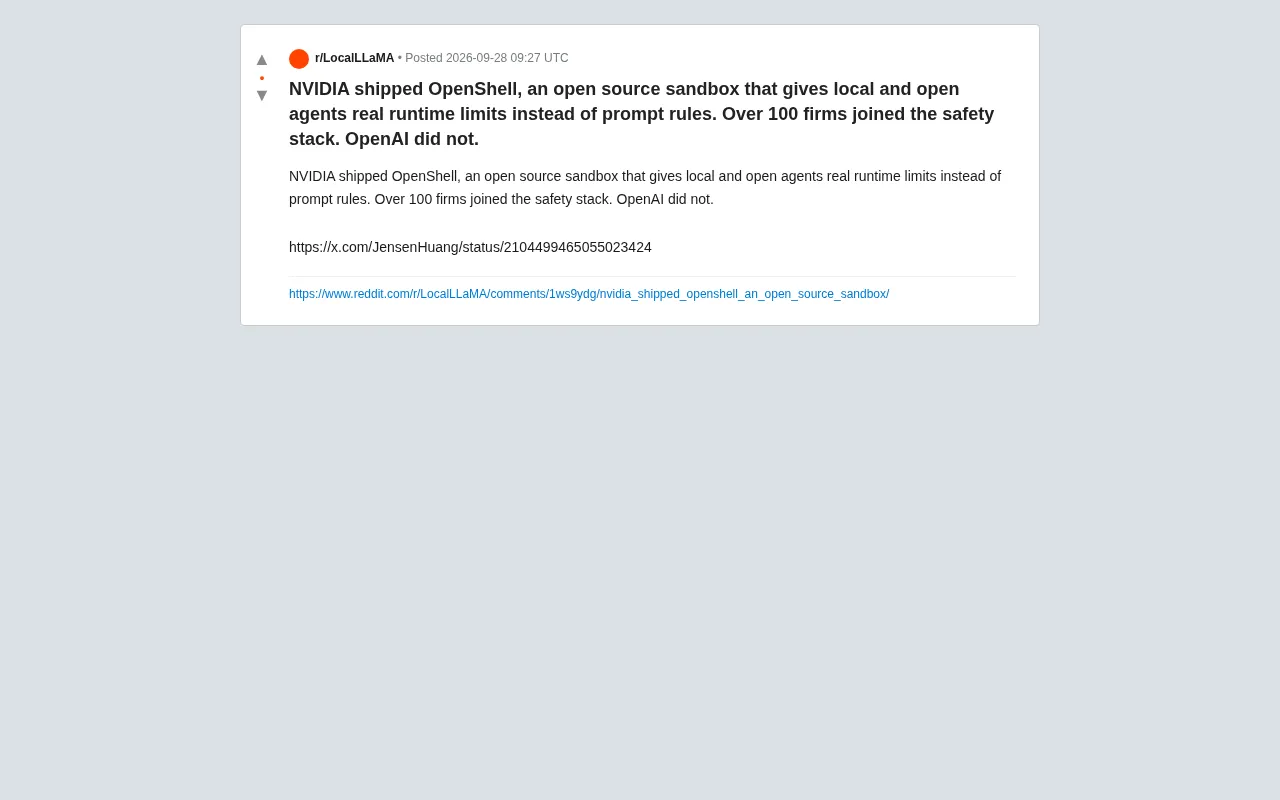
NVIDIA推出OpenShell:给AI智能体加上运行时护栏
NVIDIA发布开源沙箱工具OpenShell,用运行时限制取代提示词规则为AI智能体加上安全护栏,超100家企业加入该安全技术栈,OpenAI缺席。解读其对本地与开源智能体安全治理的意义。
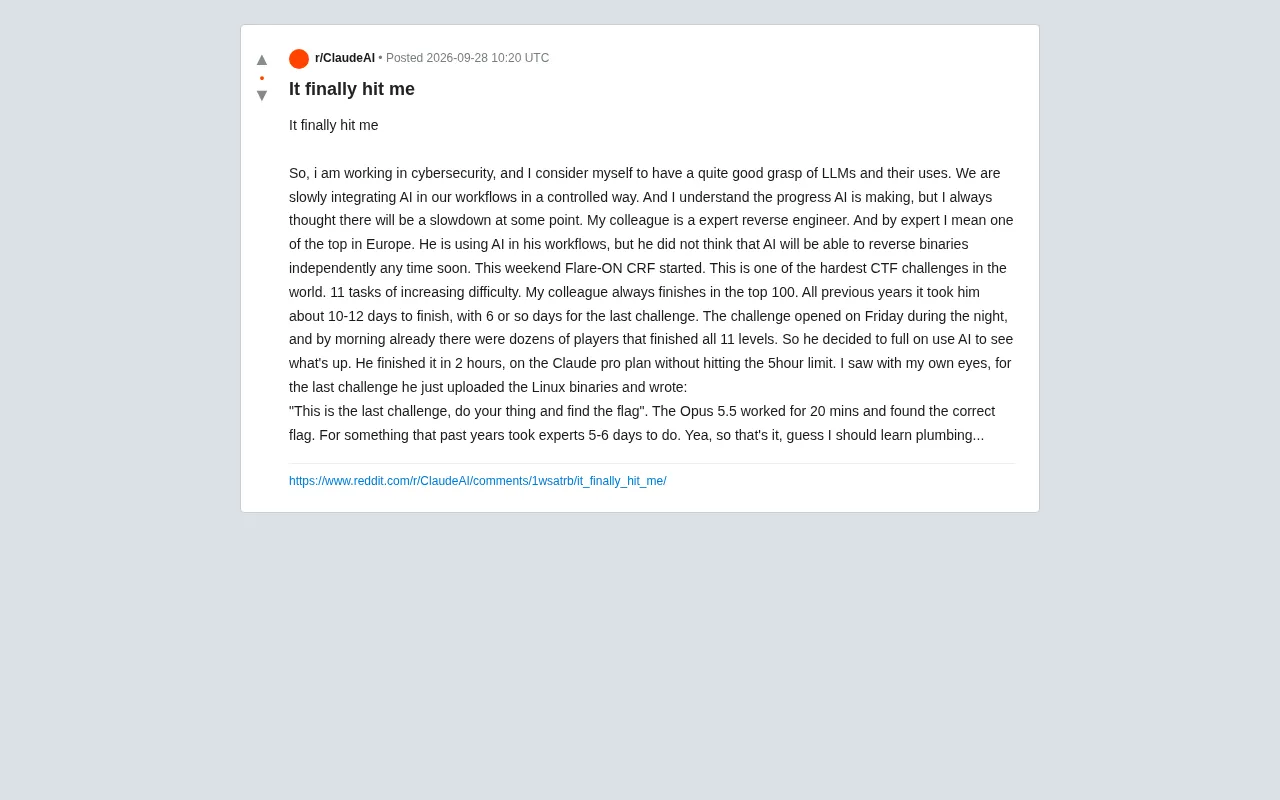
AI两小时通关Flare-On逆向挑战,安全专家惊呼职业危机
一位网络安全从业者在Reddit分享:欧洲顶尖逆向专家借助Claude,2小时通关全球最难CTF之一Flare-On,最后一道题AI仅用20分钟解出,而人类专家往年需5-6天。本文解读这一事件对AI逆向能力与安全行业的深远影响。

AI巨头的内容困局:拿走成果,独占收益
大型AI公司无偿使用创作者内容训练模型却独占收益,引发版权与利益分配争议。本文剖析AI训练数据的价值归属、合理使用边界及从对抗走向价值分成的可能出路。
英伟达开源Agent安全平台:为智能体持续监控提供参考架构
英伟达推出开源Open Agent Safety Platform,为AI智能体提供持续的运行时安全监控参考架构。本文解析该平台的定位、持续监控理念及其对智能体安全治理的行业意义。

从零手写AI算法:523节开源课程全解析
AI Engineering from Scratch 是一套 MIT 许可的开源课程,含 523 节课程、20 个阶段,强调从零手写每个算法。本文解析其课程结构、电子书、八种语言支持及与编程智能体的结合方式。

GPT-3 正式退役:一个语言模型时代的谢幕
GPT-3 正式停止服务,引发 AI 社区对模型生命周期的讨论。官方推荐的替代方案难以即插即用,Davinci 等旧模型退役凸显闭源模型的可控性风险,也让本地部署与开源模型的价值愈发受到关注。
MuJoCo在机器人感知与学习中的应用探析
深入解析MuJoCo物理仿真引擎在机器人感知与机器人学习中的应用,涵盖强化学习、模仿学习、sim-to-real迁移及感知控制闭环等核心话题。

一句"不要猜测"让AI幻觉从71%降至20%
一项实验显示,在提示词中加入"Do not guess"(不要猜测)能将AI编造的虚假声明从71%降至20%。本文解析AI幻觉的成因、提示工程的低成本价值,以及对AI评测体系的启示。

重新审视:大模型玩宝可梦的进步说明了什么
Reddit社区重新审视大语言模型在《宝可梦》游戏中的表现进展。本文分析为何游戏成为评估LLM长程规划与推理能力的新基准,进步与瓶颈并存的现状,以及如何理性看待AI通关成绩。
Spotify对话式推荐Agent实战:合成数据与自优化闭环
Spotify发布对话式推荐Agent实战论文,通过多轮合成数据生成和自优化闭环,解决冷启动下的Agent规划难题。线上A/B测试显示用户收听量+14%、周活+5%、跳过率降5%,为工业界构建对话式AI系统提供实用框架。
SRBench:用大模型自动化系统综述筛选的基准框架
论文提出 SRBench 基准框架,含 4.5 万条标注数据、覆盖 32 项二次研究,专门评估大语言模型在系统综述筛选中的表现,并配套 PromptSR 提示实验工具,解决类别不平衡带来的评估失真问题。
SignTrace:用自然语言描述动作,反向查询手语词汇
SignTrace 是一套面向中文手语词典的自然语言反向检索系统,用户只需描述动作即可找到对应手语词汇。系统整合 LLM 词典增强、七通道检索与候选重排,在基准测试中 Hit@1 达 94.0%,MRR 高达 0.9540。
Cartograph:为AI智能体重构工具发现的联邦式代理方案
Cartograph 是一个针对 MCP 的联邦式代理方案,通过签名能力卡片、Rift 混淆聚类分析和两阶段检索,将 AI 智能体工具发现从 O(n) 降为 O(k),token 消耗从 4.2 万降至 475,R@5 达 0.816。
SlideLab:AI多智能体自动生成科研幻灯片,人类偏好率达77%
SlideLab 是一个无需训练的多智能体框架,可从研究论文自动生成科研幻灯片,在盲测中人类偏好率达77%,推理成本仅为最强开源基线的四分之一。配套的 ConfArena 评估框架能模拟会议室逐页评估演示质量。