#前沿研究
共 8576 篇相关文章
Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
Gemini 3.5 Pro延期难产,谷歌却疯狂迭代3.8 Flash。本文从智能、速度、单位任务成本与TPU算力能效角度,解析谷歌如何重新定义大模型战争,从军备竞赛转向工业竞赛。
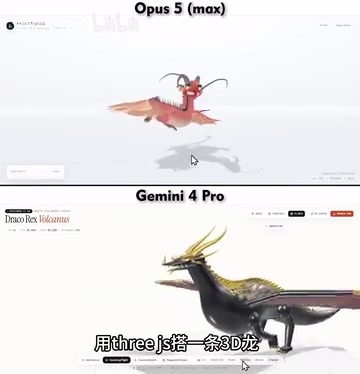
Gemini 4 Pro对决Opus 5 Max:Three.js建3D龙谁更强?
Gemini 4 Pro 与满血 Opus 5 Max 用同一条提示词、通过 Three.js 搭建 3D 龙的横向对比测试。结果显示未发布的 Gemini 4 Pro 竟能与满配 Opus 5 打成平手,本文解析这场 AI 编程能力对决的看点与意义。

AI能力在飙升,可靠性却停滞:被忽视的真正难题
AI能力持续飙升,但可靠性却停滞不前。基于普林斯顿HAL研究和Nature论文,本文探讨为何评测体系奖励自信错误、Agent从建议转向执行后的风险量级变化,以及生产环境中衡量AI可靠性的真正难题。
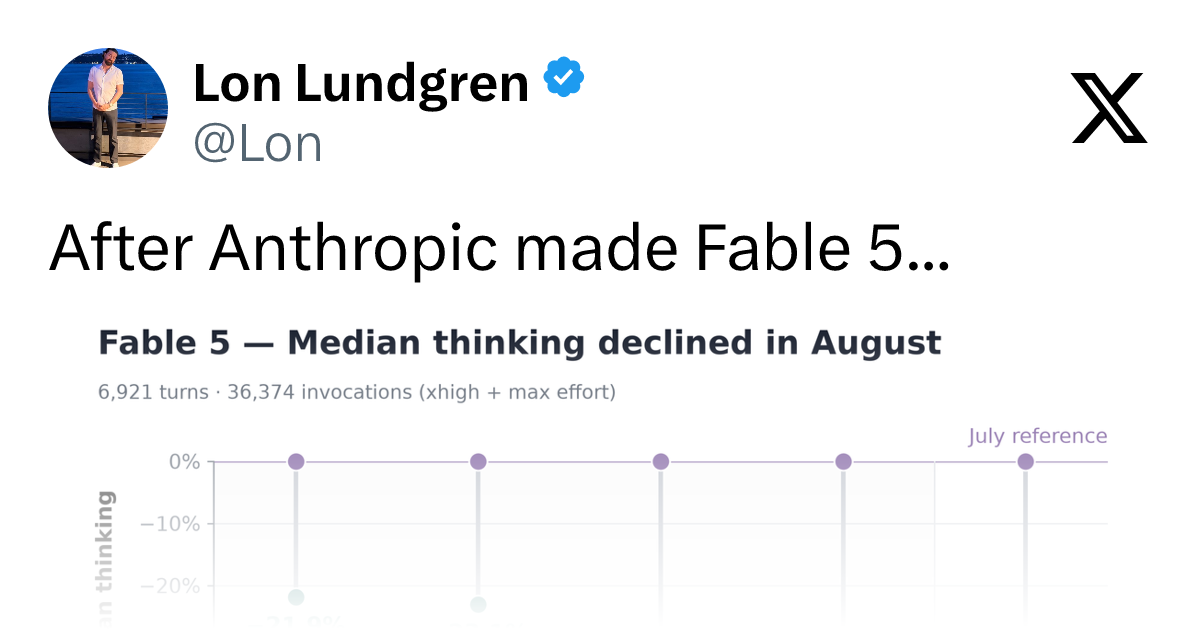
Fable 5引发热议:AI推理能力真的在下降吗?
Hacker News 热议话题「Fable 5」指出 AI 推理能力中位数在八月出现下滑,引发社区对大模型表现波动的讨论。本文分析模型退化的可能原因与第三方监测的价值。
本地部署前沿AI模型:硬件自主运行的可能性
探讨在个人硬件上运行前沿AI模型的可能性、技术门槛与价值。分析本地部署AI在显存算力、模型可获取性方面的挑战,以及数据自主与成本控制带来的吸引力。
亚马逊携手斯坦福启动AI科研计划
亚马逊宣布与斯坦福大学启动AI与科学研究合作计划,聚焦推进前沿研究、扩大参与度和推动成果落地转化,成为科技巨头与顶尖高校联合研发的最新案例。

Grok 4.7 智能、性能与价格深度解析
针对 Grok 4.7 的智能、性能与价格分析进行梳理,介绍评估大语言模型的核心维度,包括基准测试、推理速度与定价性价比,帮助读者建立理性的模型评估框架。

时间触发通信系统中的"喋喋不休"故障及其防护
深入解析时间触发通信系统中的"喋喋不休"(babbling idiot)故障模式,探讨总线守卫、集中式与分布式守卫架构如何实现故障隔离,保障航空、汽车等安全关键系统的通信可靠性。

数学界成立AI咨询组:应对人工智能对研究范式的冲击
数学界成立人工智能咨询组,旨在为研究者和机构提供AI使用指导,应对AI对数学研究严谨性、学术诚信与验证标准的冲击。本文分析其成立背景与可能承担的角色。
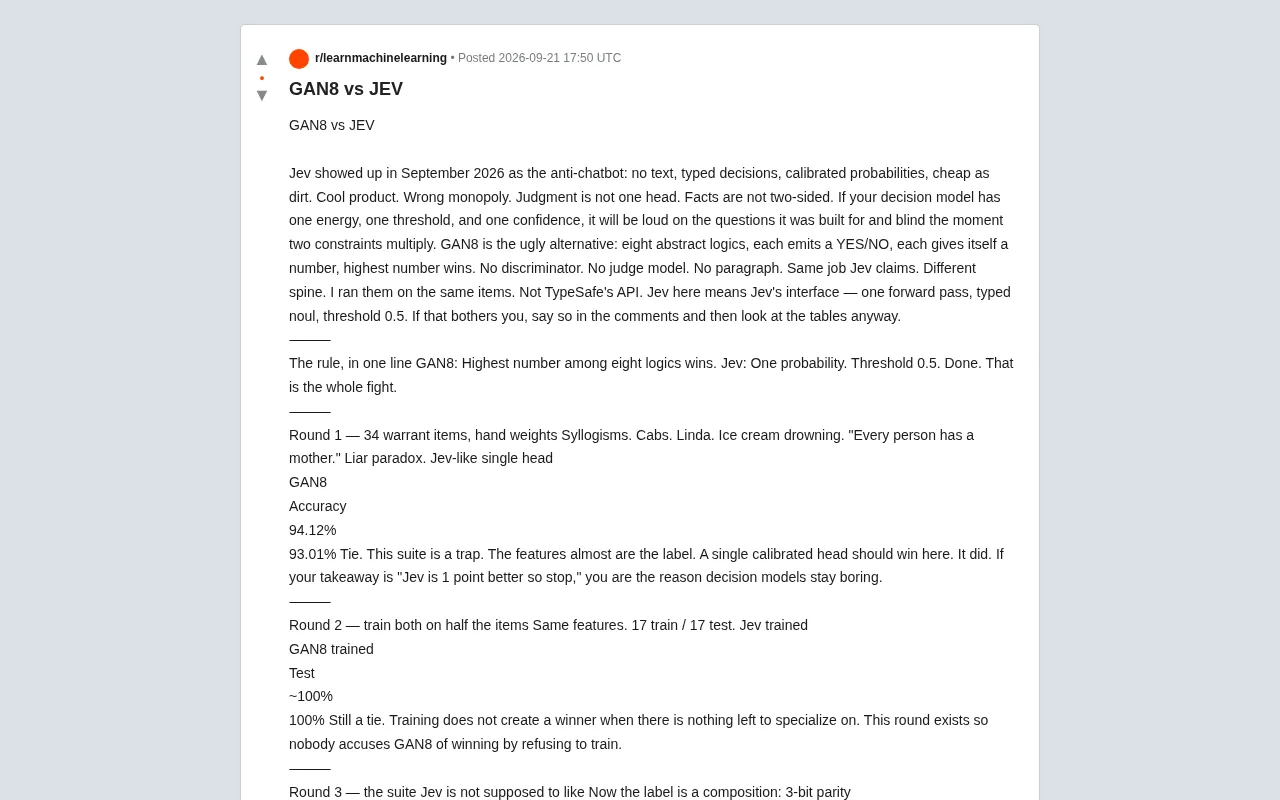
GAN8 对决 JEV:单头判断模型与八逻辑架构的实战较量
GAN8 与 JEV 两种决策 AI 架构的四轮实战对比:单头概率模型 vs 八逻辑表决架构。在奇偶校验等结构性组合任务上 GAN8 完胜,但融合两者反而更糟。深入解析决策模型设计的核心权衡。
冷静看待TypeSafe AI的Jev:新架构还是被过度炒作?
TypeSafe AI的Jev被炒作成全新AI形态,但一位资深NLP从业者指出它更像是对现有分类器与语言模型的改进。本文剖析Jev的真实定位、缺失的架构信息,以及为何厂商自评基准需要谨慎看待。

OpenAI呼吁建立全球AI标准:协同评估与治理成关键
OpenAI提出构建下一阶段AI的全球标准路线图,主张通过协同评估、透明报告与跨机构治理提升AI安全。本文解析标准化三重支柱及其对行业信任的意义。

OpenAI组建数学与AI顾问团:为AI成果把关
OpenAI宣布与独立的数学与人工智能顾问团合作,指导AI新兴成果的评审与传播。本文解析该机制的意义、独立性价值及对AI行业成果发布规范的潜在影响。

亚马逊三篇论文突破AI抗体设计瓶颈:从预测到实验验证
亚马逊生物发现团队发布三篇论文,攻克AI抗体设计核心瓶颈:从结合力预测器的基准测试到全新抗体de novo设计的实验验证,推动AI生物医药走向实用化。
Supra2-IMG:100M参数开源文生图模型,H100单卡10小时训练完成
SupraLabs 开源发布 Supra2-IMG,一款仅 100M 参数的文生图模型,单张 H100 训练不到 10 小时,支持 CPU 20 秒、GPU 2 秒出图,256×256 分辨率高质量生成,已上线 Hugging Face。
Agent Retrieval Bench:评估编程Agent找对文件的能力
Agent Retrieval Bench 专注评估编程Agent的代码检索能力,考察它在修复代码前能否找到正确的仓库文件。这一被多数评测隐藏的关键环节,为诊断AI编程助手的真实能力提供了新视角。

IBAC/RBAC/ABAC/ReBAC对比:哪种访问控制适合AI Agent
对比RBAC、ABAC、ReBAC三种访问控制模型在AI Agent场景下的适配性,剖析各模型失效之处,并解读基于意图的访问控制IBAC的真实含义与边界。

NVIDIA Earth-2:用实时观测数据驱动天气决策的AI平台
NVIDIA Earth-2 借助 GPU 加速与 AI 天气模型,帮助能源、物流、农业等气象敏感行业将实时观测数据转化为及时的天气决策,提供更高分辨率、更本地化的预测能力。