#前沿研究
共 8569 篇相关文章

Kev:基于Qwen3.5打造的轻量级决策模型家族
Kev是基于Qwen3.5打造的轻量级决策模型家族,专注于决策类任务优化。本文解析其技术路线、小型专用模型的应用价值及社区反响。
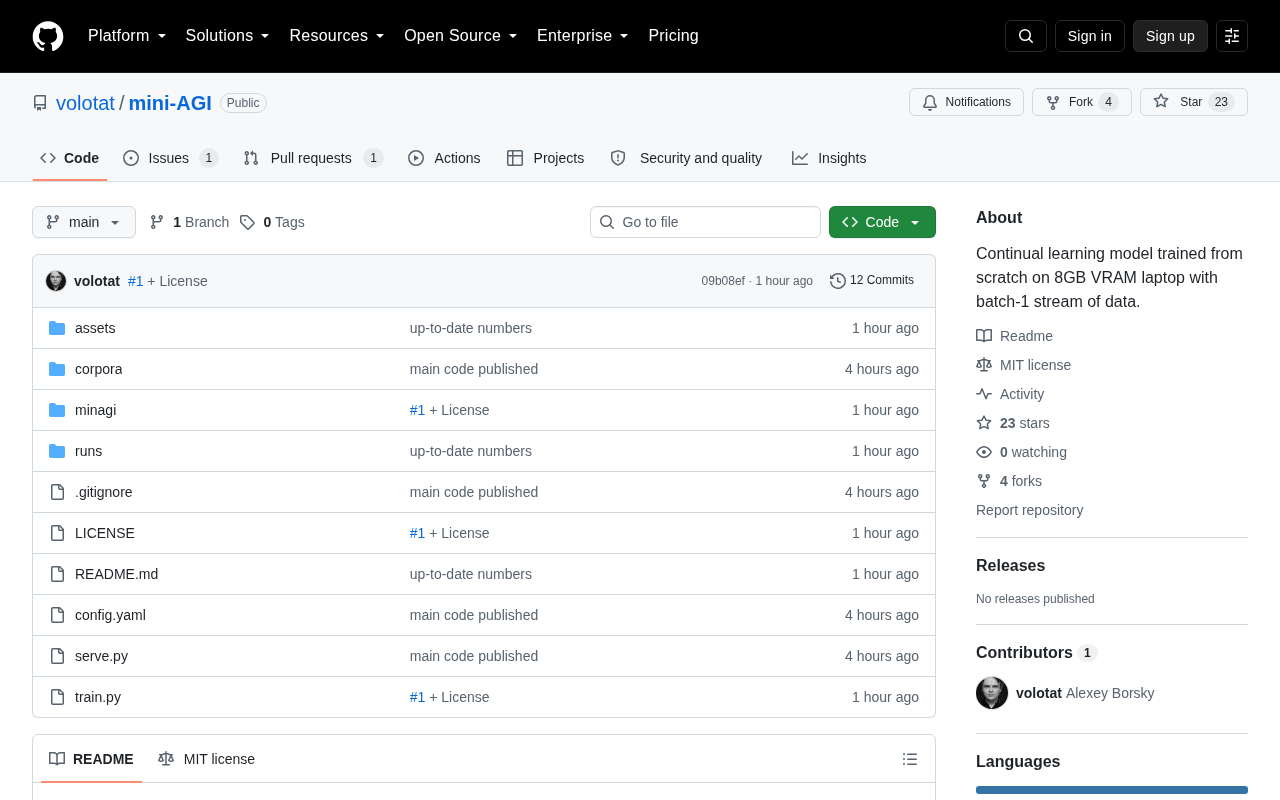
Mini-AGI:8GB显存从零训练的动态持续学习模型
Mini-AGI 是一个开源项目,主打在 8GB 显存的消费级 GPU 上从零训练具备动态持续学习能力的模型。本文解析其技术方向、持续学习原理及应给予的理性预期。
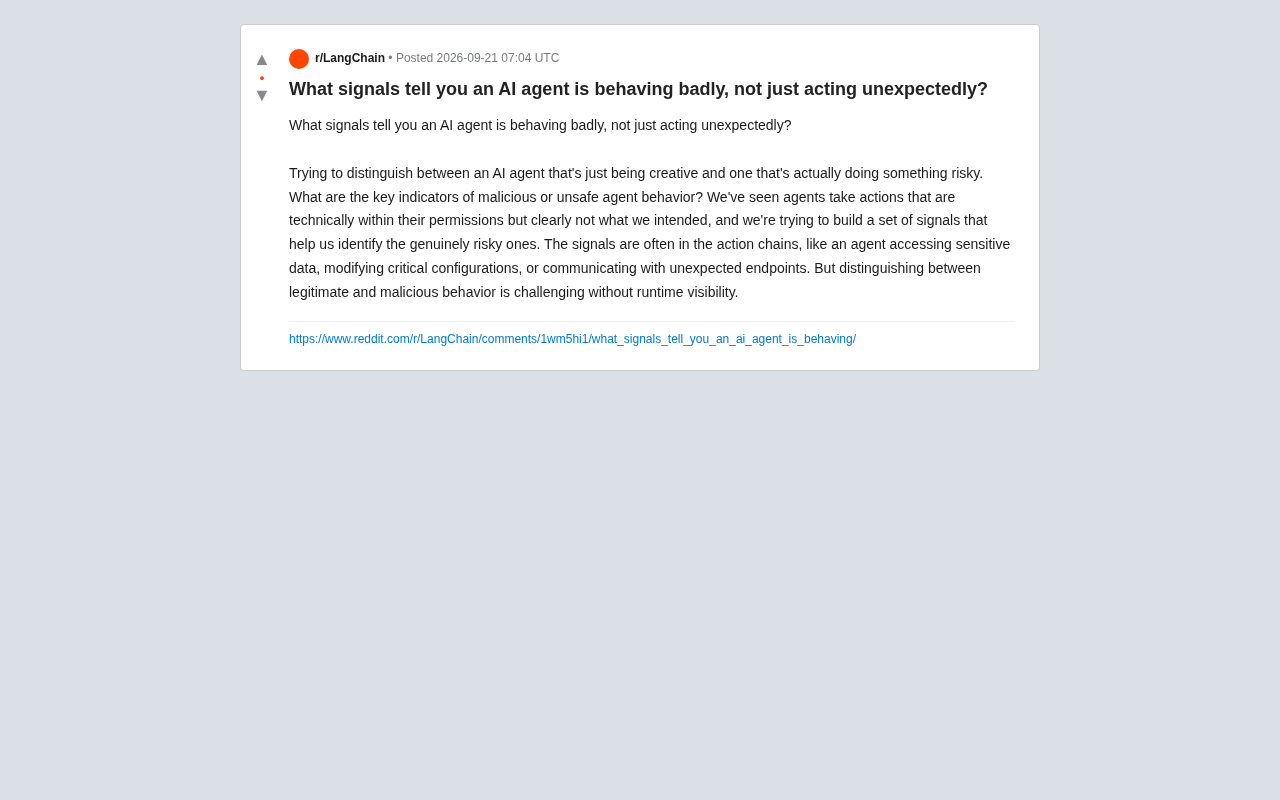
如何判断AI Agent是行为异常还是真的危险?关键信号解析
如何区分AI Agent是无害的创造性行为还是真正危险的操作?本文解析敏感数据访问、关键配置修改、异常端点通信等风险信号,探讨运行时可见性对Agent安全治理的关键作用。
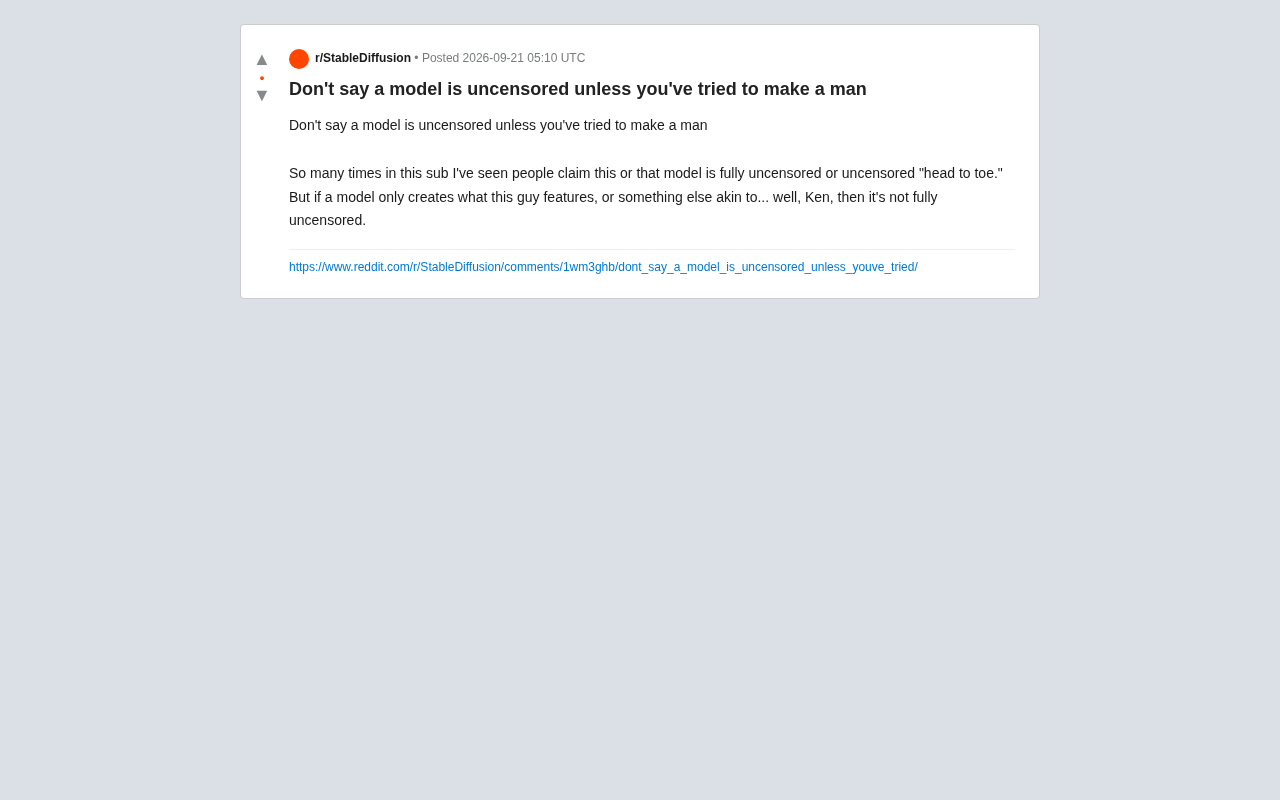
如何判断AI模型是否真的"无审查"?社区争议引发思考
Reddit社区热议如何判断AI生成模型是否真正"无审查"。本文探讨无审查标签的模糊性、训练数据偏差导致的隐性局限,以及用户应如何全面评估模型的实际生成能力。
ICLR审稿新规引热议:挂名3篇即当审稿人?
ICLR审稿政策规定署名3篇及以上论文者需担任审稿人,但未提及资格要求,引发学术社区争议。本文分析该政策的逻辑、挂名作者问题及对审稿质量的潜在影响。

递归语言模型如何实现真正推理:跳出分布外泛化困境
一篇 arXiv 新论文提出反直觉观点:限制语言模型的可见范围反而能提升分布外推理能力。递归语言模型通过上下文隔离排除捷径依赖,挑战了经典学习理论中'覆盖正确规则即可学会'的假设。
传音的说话人归属多语种ASR系统:MLC-SLM 2026挑战赛亚军方案解析
传音语音团队在MLC-SLM 2026挑战赛提交的说话人归属多语种ASR系统解析。基于DiariZen说话人日志、Qwen3-Omni多语种ASR与CTC对齐的级联框架,以15.41%的tcpMER排名第二。
TatBLiMP:首个鞑靼语语法能力评测基准解读
TatBLiMP是首个针对鞑靼语的语法能力评测基准,覆盖16种形态句法现象、1248对最小对立句。研究发现针对性训练比参数规模更能提升低资源语言模型的语法能力。
Reviser:让文本生成模型学会像人一样修改草稿
Reviser 是一种支持修改能力的文本生成模型,通过在可变画布上执行光标动作(插入、移动、停止)实现非单调生成。它在质量上优于扩散模型基线,推理算力更低,为文本生成提供了新范式。

DischargeBench:让LLM学会向病人讲清出院医嘱
arXiv最新研究提出DischargeBench,一个以病人理解为核心的LLM出院教育评测框架。通过人格锚定的虚拟病人模拟和四维评分,揭示大模型在困难病人场景下的覆盖失败与理解鸿沟。
SAGE:用Schema引导LLM做拨款评审,人机协作达成中高一致性
arXiv 最新研究提出 SAGE 系统,用 Schema 引导大语言模型进行拨款评审。通过结构化检查与证据链接,SAGE 在人机协作模式下达成 kappa=0.58 的中高一致性,显著优于简单提示基线,为 AI 辅助专业评审提供可审计范式。
TALON框架:时序感知让放射学报告生成更懂"变化"
TALON是一个时序感知的纵向放射学报告生成框架,通过双通道时序融合模块(DCTFM)自适应整合可变长度患者病史,在MIMIC-CXR数据集上超越现有最先进方法,且病史越长表现越好。

HERMES:用知识图谱从临床文本预测患者结局
arXiv 新论文提出 HERMES 框架,完全基于临床文本构建个性化知识图谱,通过对比逻辑建模与图注意力网络进行患者结局预测。在 MIMIC-III/IV 上的院内死亡率与再入院预测任务中持续超越纯文本基线。
SpecOpt:用智能体优化药物分子的靶向特异性
SpecOpt 提出了一项全新的分子设计任务:通过智能体框架结合残基感知接触分析与大语言模型推理,优化现有药物的靶向特异性。在 915 个化合物上,84.8% 获得结合选择性改善。

小语言模型知道自己不知道什么吗?语义熵是关键
一篇 arXiv 研究揭示:小语言模型(SLM)的 token 级熵几乎失效,但语义熵能有效捕捉不确定性,并通过路由给专家模型带来最高 +50 个百分点的准确率提升,跨家族路由效果远超同家族路由。
AI精神科问诊质量如何把关?临床验证平台给出答案
arXiv最新研究提出InterviewPlayground平台,用记忆增强模拟患者对AI精神科问诊进行质量评估。试点显示LLM信息挖掘率达88%远超医生,但临床幻觉更多、安全隐患刻画不足,为AI医疗部署提供质量把关框架。
AI智能体设计芯片:高层抽象HLS工作流实现2.6倍加速
最新arXiv论文提出AHRR工作流,让AI智能体在HLS高层抽象层设计芯片并结合RTL细化,在11任务基准上实现2.6倍加速,为智能体驱动的芯片设计提供新范式。

微调如何重塑大模型内部机制:表征变化与因果重要性的解耦研究
一篇 arXiv 研究揭示大语言模型微调如何重塑内部机制:表征变化最剧烈的层与真正起因果作用的关键组件并不重合,且跨任务组件重叠不等于性能迁移,甚至可能导致相互干扰。