#前沿研究
共 8576 篇相关文章
SpecOpt:用智能体优化药物分子的靶向特异性
SpecOpt 提出了一项全新的分子设计任务:通过智能体框架结合残基感知接触分析与大语言模型推理,优化现有药物的靶向特异性。在 915 个化合物上,84.8% 获得结合选择性改善。

小语言模型知道自己不知道什么吗?语义熵是关键
一篇 arXiv 研究揭示:小语言模型(SLM)的 token 级熵几乎失效,但语义熵能有效捕捉不确定性,并通过路由给专家模型带来最高 +50 个百分点的准确率提升,跨家族路由效果远超同家族路由。
AI精神科问诊质量如何把关?临床验证平台给出答案
arXiv最新研究提出InterviewPlayground平台,用记忆增强模拟患者对AI精神科问诊进行质量评估。试点显示LLM信息挖掘率达88%远超医生,但临床幻觉更多、安全隐患刻画不足,为AI医疗部署提供质量把关框架。
AI智能体设计芯片:高层抽象HLS工作流实现2.6倍加速
最新arXiv论文提出AHRR工作流,让AI智能体在HLS高层抽象层设计芯片并结合RTL细化,在11任务基准上实现2.6倍加速,为智能体驱动的芯片设计提供新范式。

微调如何重塑大模型内部机制:表征变化与因果重要性的解耦研究
一篇 arXiv 研究揭示大语言模型微调如何重塑内部机制:表征变化最剧烈的层与真正起因果作用的关键组件并不重合,且跨任务组件重叠不等于性能迁移,甚至可能导致相互干扰。
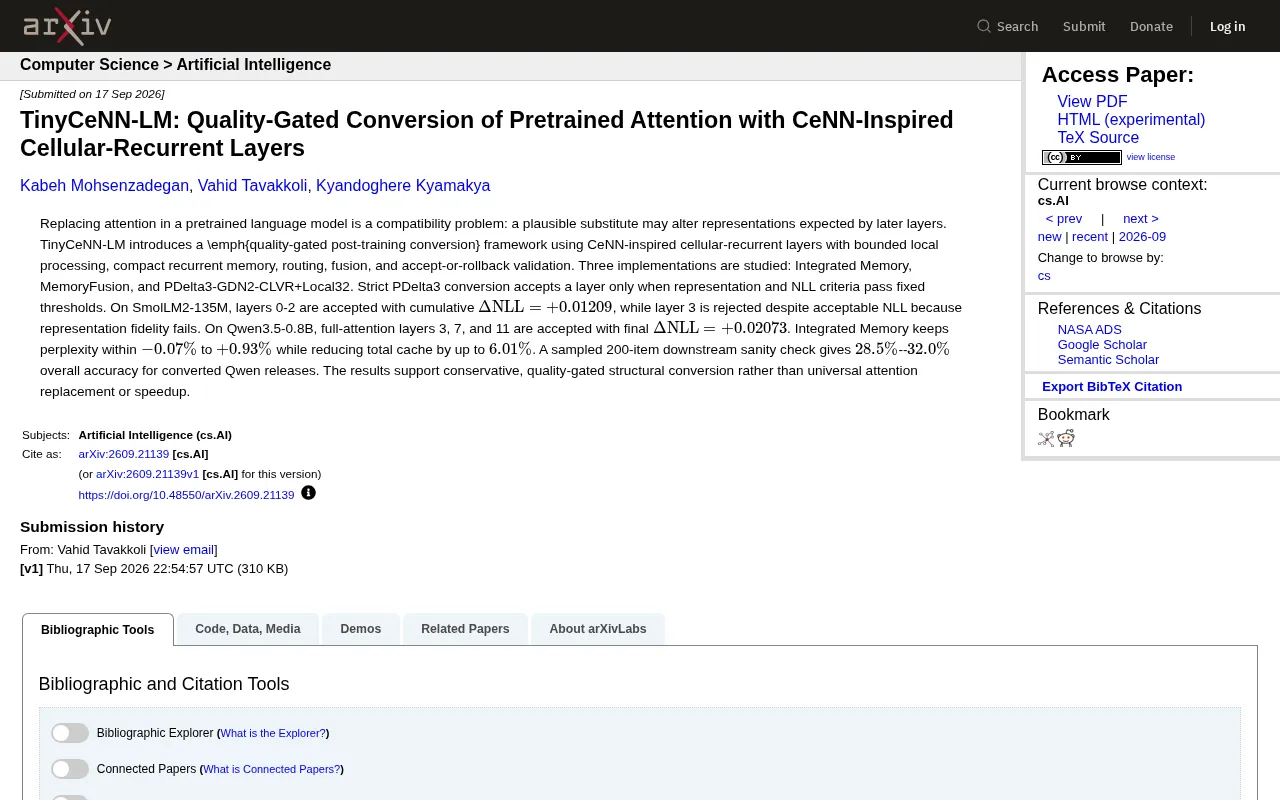
TinyCeNN-LM:用质量门控替换预训练注意力层
TinyCeNN-LM 提出质量门控的后训练转换框架,用 CeNN 启发的细胞循环层替换预训练模型的注意力层。在 SmolLM2-135M 与 Qwen3.5-0.8B 上逐层验证,缓存最多减少 6.01%,主张保守的质量门控结构转换。

拓扑视角揭示大模型幻觉:注意力图中的信息流失真信号
一篇 arXiv 新研究提出用注意力图的拓扑结构检测大模型幻觉,通过 Forman-Ricci 曲率识别信息瓶颈,仅需单次前向传播即可判别幻觉,并揭示过度自注意力、上下文弥散与信息挤压三种失真机制。
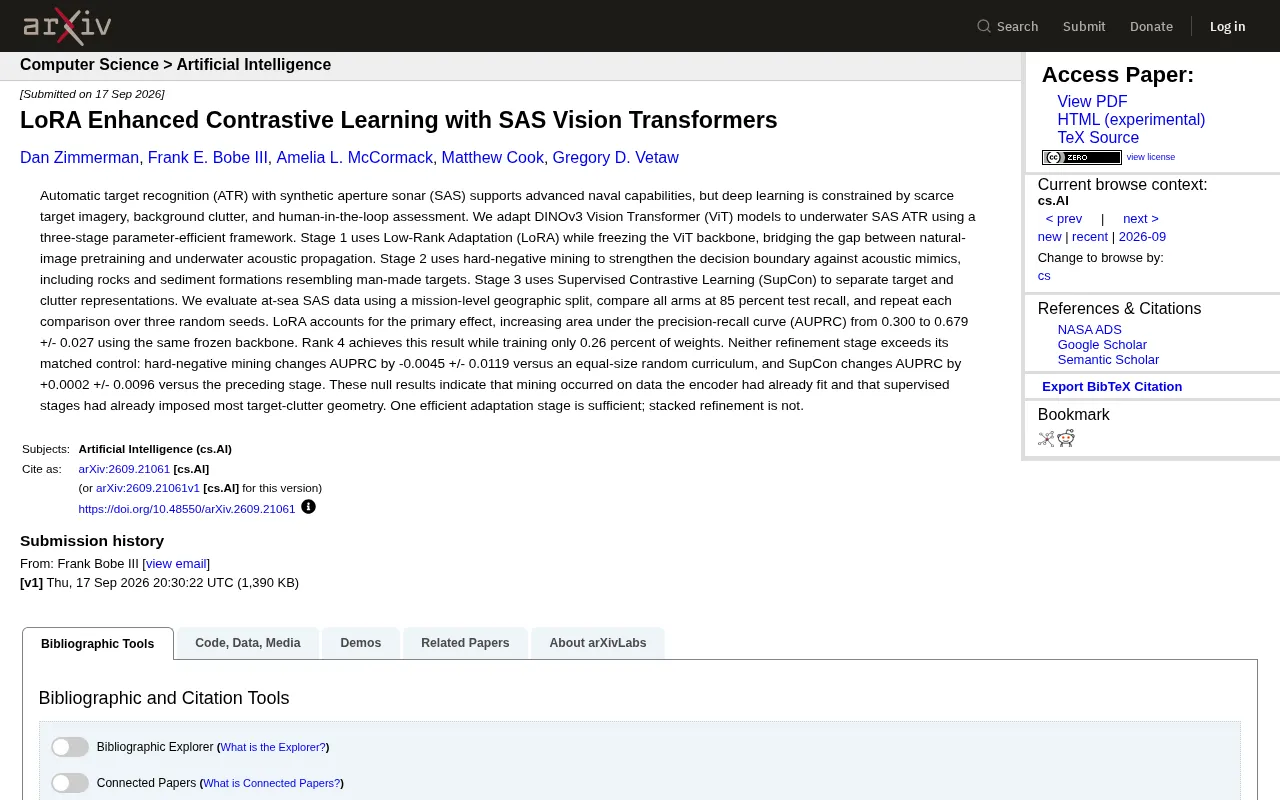
LoRA微调DINOv3实现声呐目标识别:一次高效适配足矣
arXiv最新论文将DINOv3视觉Transformer迁移到合成孔径声呐目标识别,通过LoRA低秩适配仅训练0.26%权重就让AUPRC从0.300提升至0.679,而难负样本挖掘与监督对比学习几乎无额外增益,揭示一个高效适配阶段已足够。

知识蒸馏详解:如何让小模型学会大模型的本领
知识蒸馏(Knowledge Distillation)是让小模型学习大模型能力的关键模型压缩技术。本文详解软标签、温度参数、损失函数等核心机制,以及它为何有效和实际应用场景。
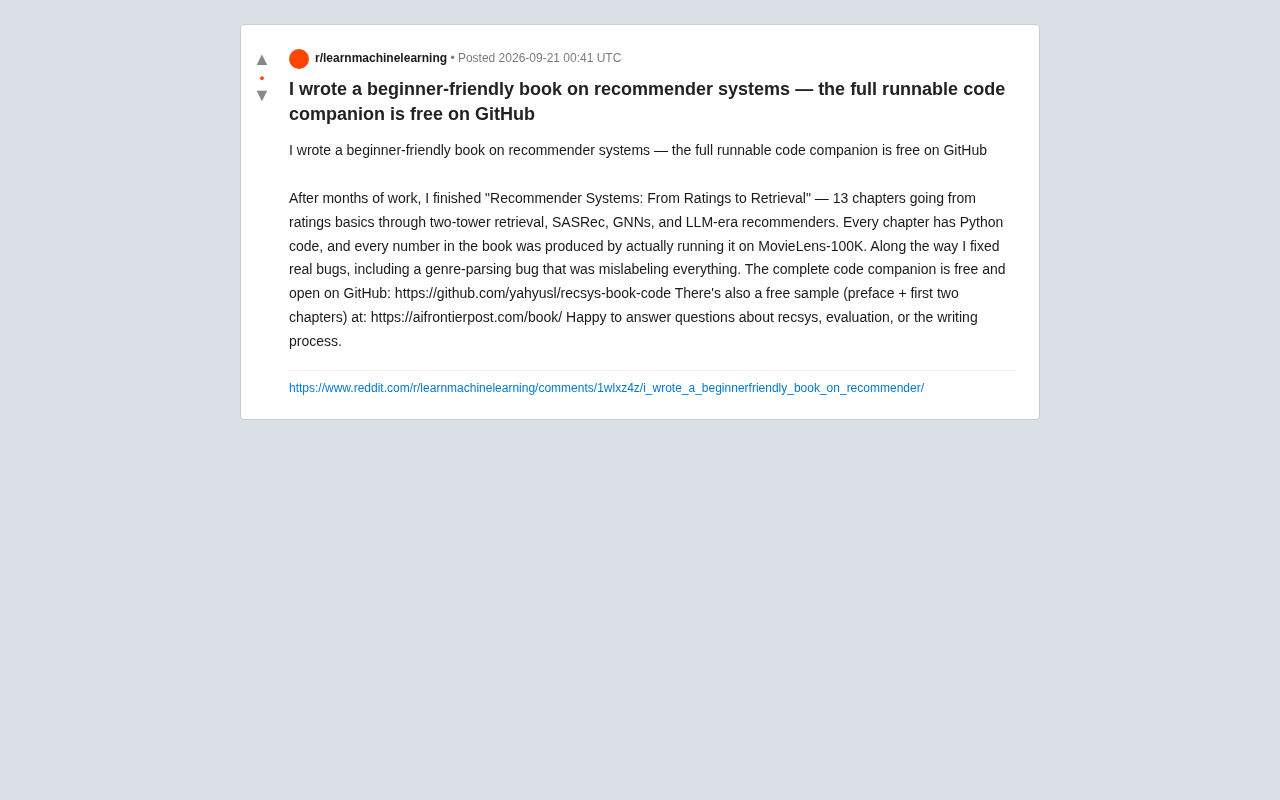
从评分到检索:一本面向初学者的推荐系统实战书籍与免费代码
一位开发者开源了推荐系统入门书《From Ratings to Retrieval》的完整可运行代码,涵盖评分预测、双塔检索、SASRec、GNN 到 LLM 推荐系统,所有数据基于 MovieLens-100K 实测,GitHub 免费获取。

arXiv背书机制解析:首次投稿者如何获得cs.AI认可
一位研究者在Reddit为cs.AI论文寻求arXiv背书,引出学术新人普遍面临的门槛问题。本文解析arXiv背书机制的运作逻辑、背书人资格要求,以及首次投稿者获得背书的稳妥途径。

终极井字棋竞技场的AI军备竞赛观察
一位开发者记录了终极井字棋竞技场排行榜上的算法军备竞赛。本文解析这一小众博弈游戏为何催生激烈技术竞争,以及背后的搜索算法与工程优化思路。

Jev在NASA开普勒信号上的实测:零微调达到72.5%准确率
开发者在Reddit公开了将AI系统Jev用于NASA开普勒望远镜信号分类的实测:8054个决策零微调达到72.5%准确率,超过简单规则基线,误报识别率达81.7%。本文分析其结果、混淆矩阵偏向与局限。

FlashAttention与Muon是如何诞生的?拆解突破性论文背后的方法论
FlashAttention和Muon Optimizer这类突破性论文是如何诞生的?本文从领域交叉、问题重述、系统性试错等角度,拆解顶尖AI研究成果背后的方法论,解答'为什么事后看这么简单'的疑惑。

Jev大模型对决经典机器学习:8个分类数据集实测揭示真相
开发者用8个分类数据集实测大模型Jev与SVM、XGBoost等11个经典机器学习模型。结果显示有标签数据时经典模型在准确率和成本上仍占优,Jev仅在IMDb等特定任务表现出色,少样本提示也未带来稳定提升。

记忆能遗传吗?RNA如何打破跨代遗传禁区
斯坦福教授Huberman对话遗传学家Oded Rechavi,解析基因、RNA与跨代遗传。为何知识不能遗传?RNA如何打破Weismann屏障,让线虫将病毒抗性和大脑活动传给后代?揭示表观遗传前沿。
共轭矩量测度:用单一凸势函数统一采样与映射的生成模型新范式
共轭矩量测度是一种生成模型新方法,用单一凸势函数 W 同时刻画采样与传输过程。本文解析其理论基础、与最优传输的联系、为何优于原始矩量测度分解,以及基于凸神经网络的估计算法与实验发现。

jevals:用类型化Jev决策替代LLM评判器的新思路
开源项目 jevals 提出用类型化 Jev 决策替代传统 LLM 评判器,为大语言模型评估引入结构化与确定性。本文解析其核心理念、与主流方案对比及现存局限。