#前沿研究
共 8617 篇相关文章
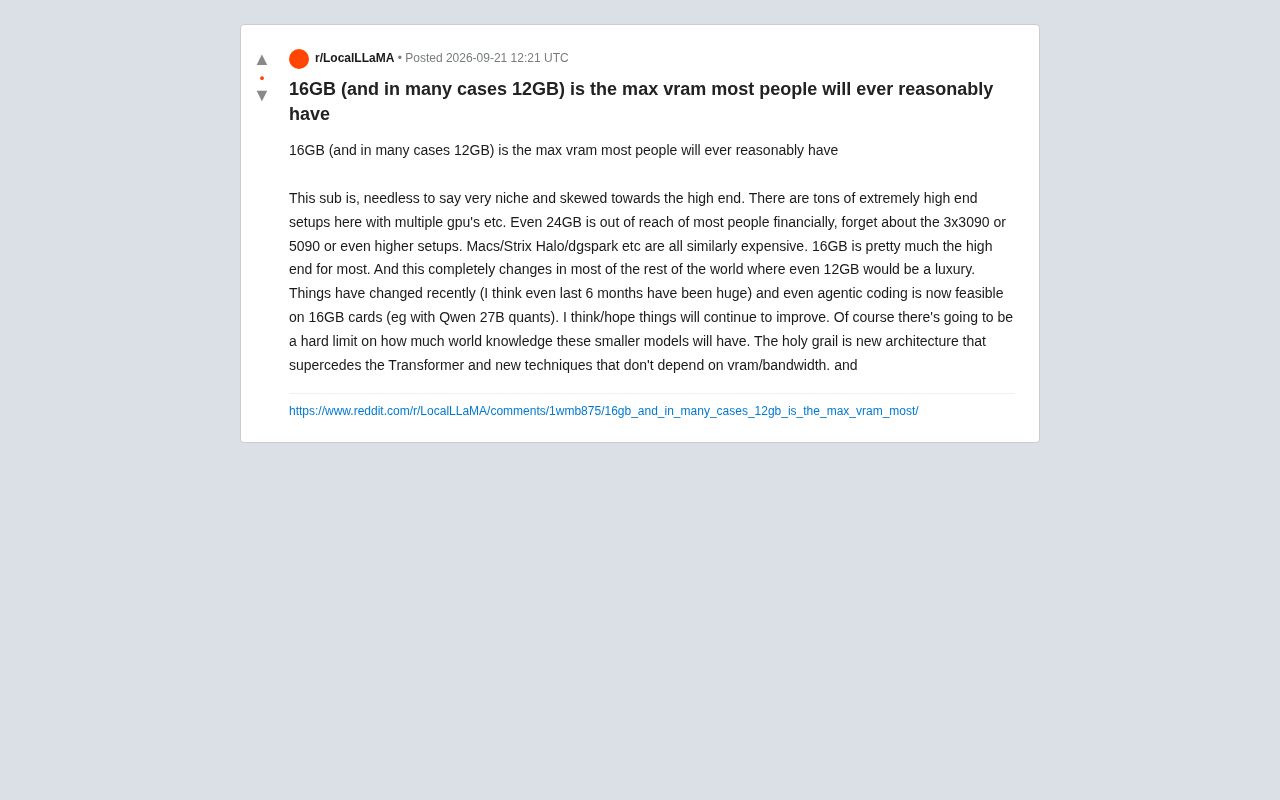
16GB显存是多数人的天花板:本地大模型的现实与未来
为什么16GB甚至12GB显存才是多数人跑本地大模型的现实上限?本文解析小显存下的AI能力现状——量化模型让agentic编程成为可能,同时探讨世界知识的硬性限制与超越Transformer架构的未来方向。
GPT-6发布:AGI临界点已至,工具边界正在消失
OpenAI发布GPT-6,被官方称为AGI时刻的临界点。本文解析GPT-6如何模糊软件工具边界、在未知规则测试中拿下99分、自主调用硬件迭代,以及它对成本、国产平替和白领工作带来的深远冲击。
GPT-6 Astra发布:OpenAI首次承认达到AGI水平
OpenAI发布新一代模型GPT-6 Astra并首次承认达到AGI水平。本文解读Astra在ARC-AGI跑分、电脑操控、3D开发、办公自动化的实战表现,以及价格、短板和距离ASI还差的两块拼图。
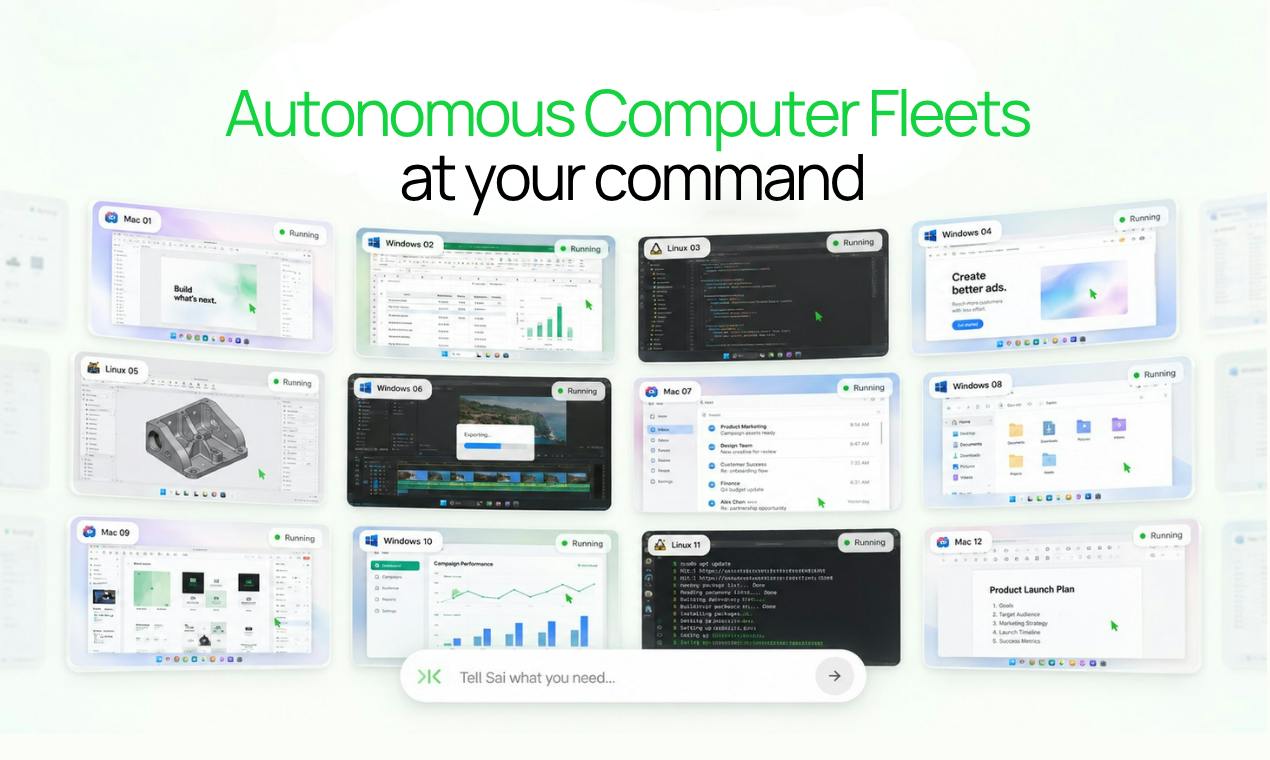
Sai:会像人一样操作电脑的自主智能体军团
Sai是Product Hunt上主打的自主电脑操作智能体,通过读屏、点击、输入等方式像真人一样操作软件,无需API即可自动化遗留系统与内部门户,支持Windows/macOS/Linux,OSWorld基准达73%。

美墨边境"虚拟墙"失效调查:AI监控塔背后的四大问题
MIT Technology Review调查揭示美墨边境"虚拟墙"AI监控塔的系统性失效:有人在监控区域穿行未被检测到并死亡。本文剖析AI边境监控的技术缺陷与四大应对方向。
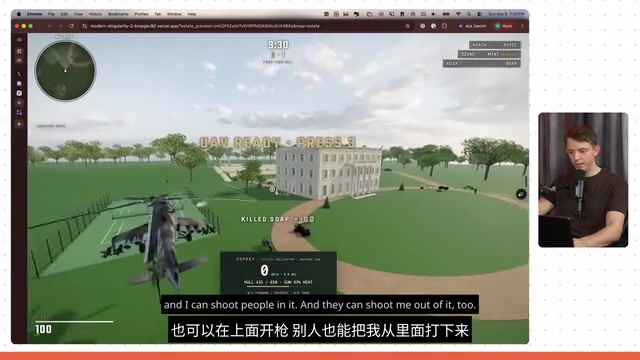
GPT-6 Astra实测:4个提示词造出3A级游戏与3D场景
OpenAI 发布代号 Astra 的 GPT-6,一位开发者实测:4 个提示词做出《使命召唤》级游戏、16 分钟生成桌面应用、PDF 一键转 3D 场景。本文梳理其在 Codex 中的真实表现、自测能力与 Mac Mini 远程方案,并给出冷静解读。
GPT-6 Astra启示:AI工作流从提示词转向系统思维
GPT-6 Astra发布伴随ChatGPT、Claude、Grok连锁宕机引发热议。本文分析Astra带来的端到端工作方式转变:AI从提示词对象变为需管理的对象,创作者的核心技能正从提示工程转向方向感、系统思维与判断力。
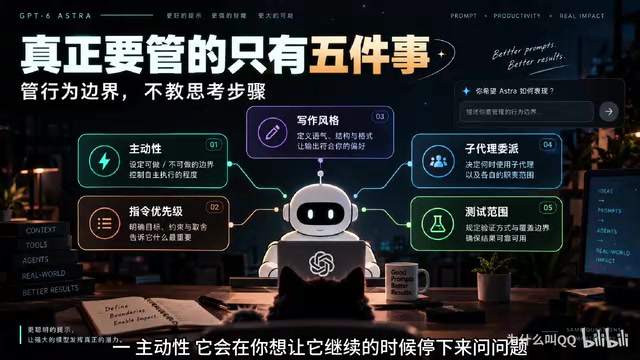
别再教GPT-6 Astra思考:新一代提示词该写边界与成本
GPT-6 Astra 发布后,旧提示词可能正在拖垮模型表现。本文解读 X 上两篇热门长文,讲清新一代提示词该写边界而非思考,附八模块框架、Skill 三原则与 272K 成本分界线等实操配置。

Kev:基于Qwen3.5打造的轻量级决策模型家族
Kev是基于Qwen3.5打造的轻量级决策模型家族,专注于决策类任务优化。本文解析其技术路线、小型专用模型的应用价值及社区反响。
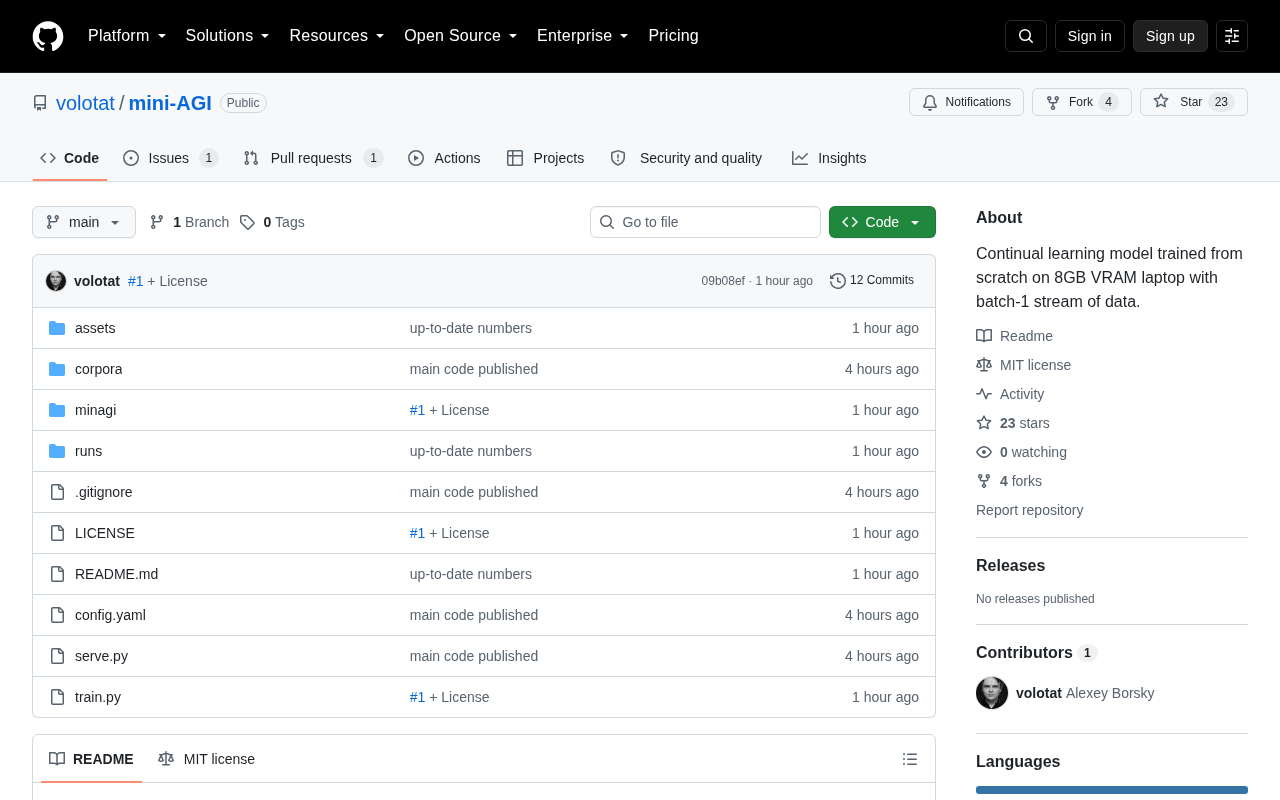
Mini-AGI:8GB显存从零训练的动态持续学习模型
Mini-AGI 是一个开源项目,主打在 8GB 显存的消费级 GPU 上从零训练具备动态持续学习能力的模型。本文解析其技术方向、持续学习原理及应给予的理性预期。
如何判断AI Agent是行为异常还是真的危险?关键信号解析
如何区分AI Agent是无害的创造性行为还是真正危险的操作?本文解析敏感数据访问、关键配置修改、异常端点通信等风险信号,探讨运行时可见性对Agent安全治理的关键作用。
如何判断AI模型是否真的"无审查"?社区争议引发思考
Reddit社区热议如何判断AI生成模型是否真正"无审查"。本文探讨无审查标签的模糊性、训练数据偏差导致的隐性局限,以及用户应如何全面评估模型的实际生成能力。
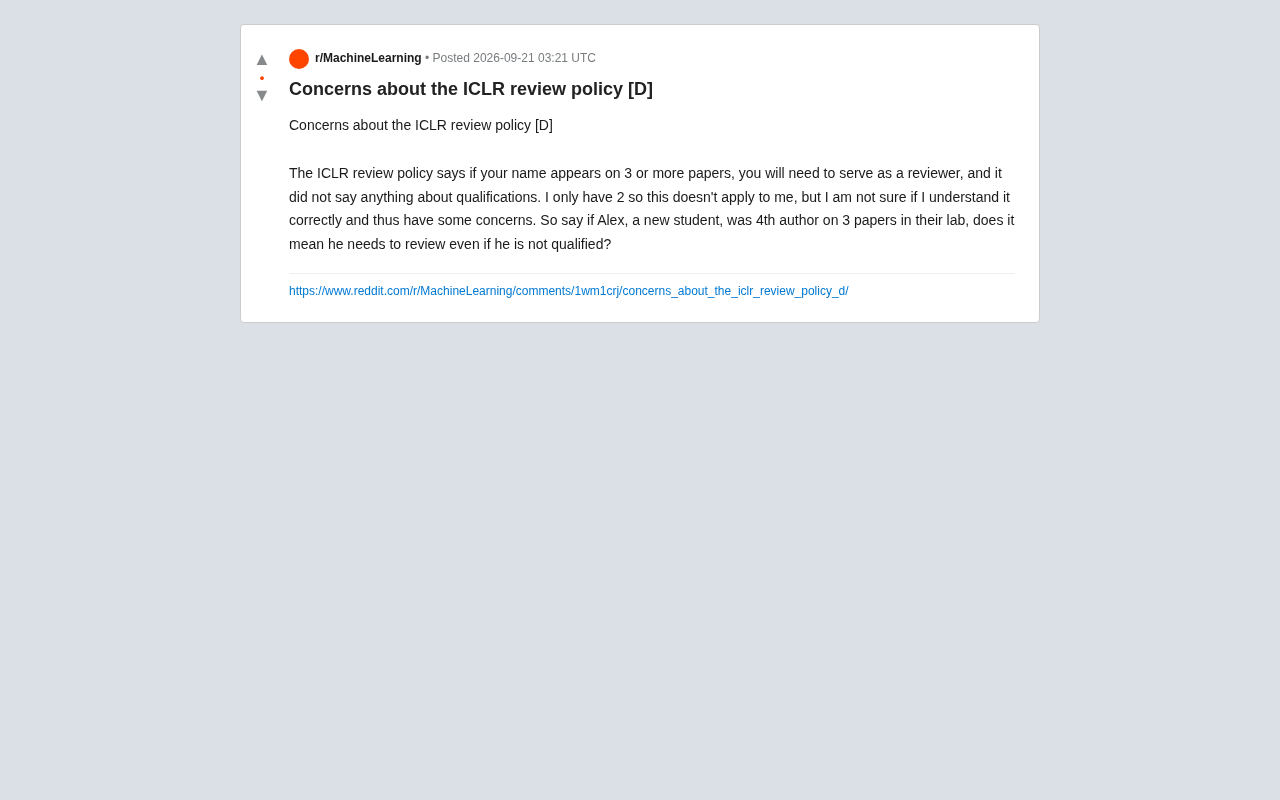
ICLR审稿新规引热议:挂名3篇即当审稿人?
ICLR审稿政策规定署名3篇及以上论文者需担任审稿人,但未提及资格要求,引发学术社区争议。本文分析该政策的逻辑、挂名作者问题及对审稿质量的潜在影响。

递归语言模型如何实现真正推理:跳出分布外泛化困境
一篇 arXiv 新论文提出反直觉观点:限制语言模型的可见范围反而能提升分布外推理能力。递归语言模型通过上下文隔离排除捷径依赖,挑战了经典学习理论中'覆盖正确规则即可学会'的假设。
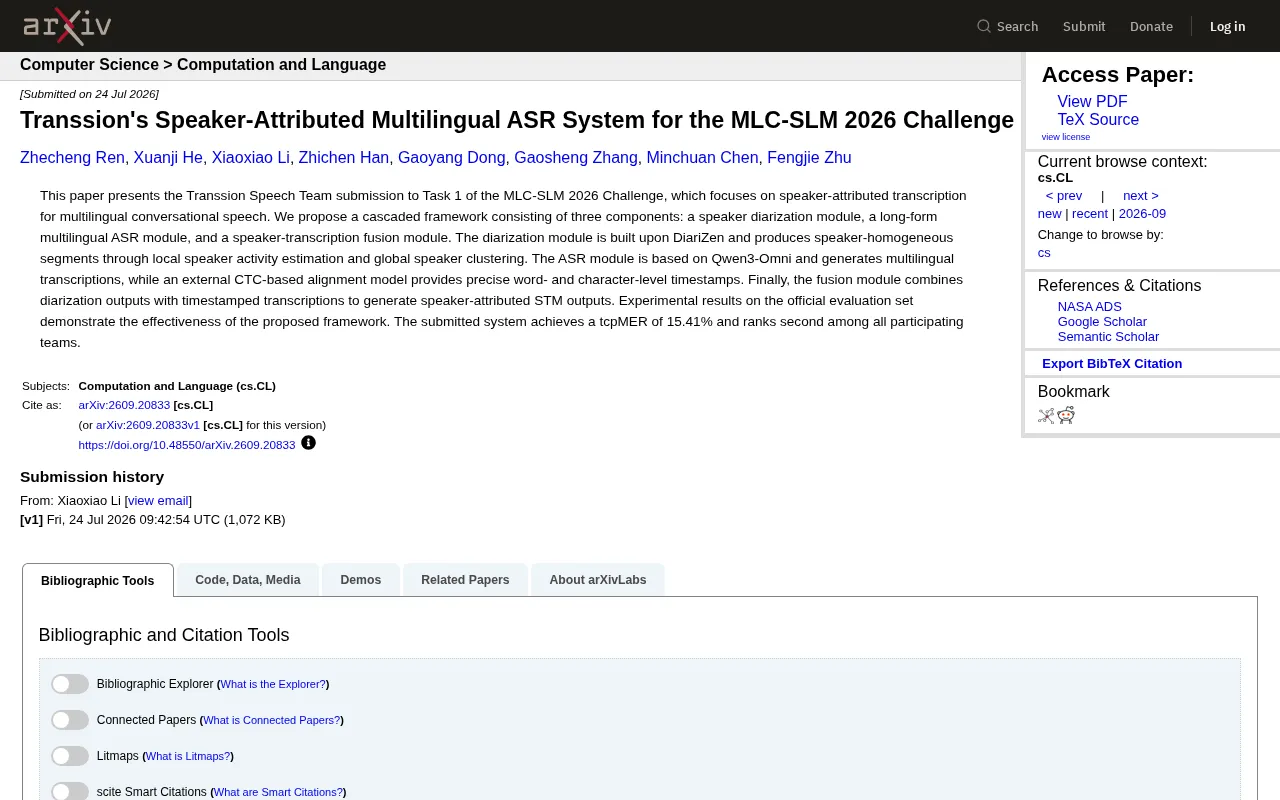
传音的说话人归属多语种ASR系统:MLC-SLM 2026挑战赛亚军方案解析
传音语音团队在MLC-SLM 2026挑战赛提交的说话人归属多语种ASR系统解析。基于DiariZen说话人日志、Qwen3-Omni多语种ASR与CTC对齐的级联框架,以15.41%的tcpMER排名第二。
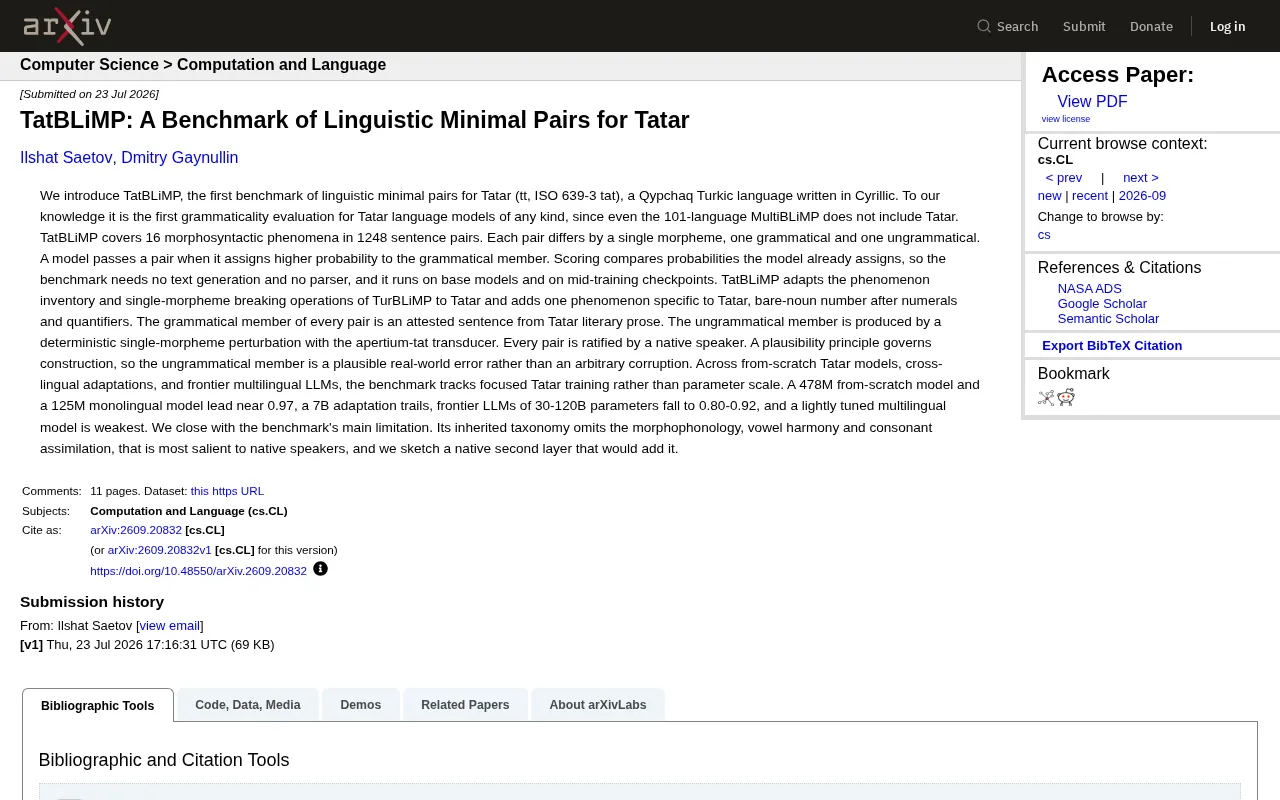
TatBLiMP:首个鞑靼语语法能力评测基准解读
TatBLiMP是首个针对鞑靼语的语法能力评测基准,覆盖16种形态句法现象、1248对最小对立句。研究发现针对性训练比参数规模更能提升低资源语言模型的语法能力。
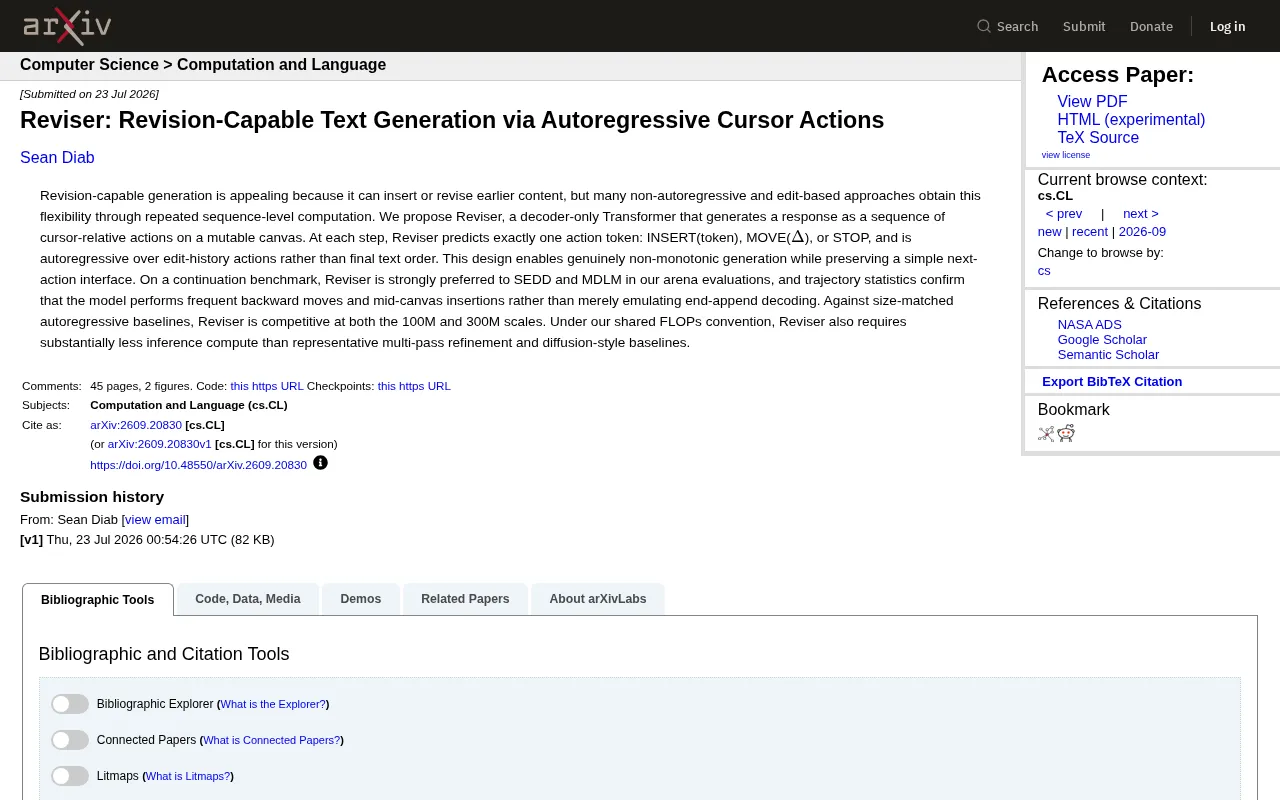
Reviser:让文本生成模型学会像人一样修改草稿
Reviser 是一种支持修改能力的文本生成模型,通过在可变画布上执行光标动作(插入、移动、停止)实现非单调生成。它在质量上优于扩散模型基线,推理算力更低,为文本生成提供了新范式。

DischargeBench:让LLM学会向病人讲清出院医嘱
arXiv最新研究提出DischargeBench,一个以病人理解为核心的LLM出院教育评测框架。通过人格锚定的虚拟病人模拟和四维评分,揭示大模型在困难病人场景下的覆盖失败与理解鸿沟。