#前沿研究
共 8758 篇相关文章
如何量化评估Agent系统工程质量?六维度评估体系全解析
抛开底层模型能力,如何量化评价Agent系统的工程质量?本文从效果、过程、可靠性、成本、可观测性、安全六大维度,配合每成功任务成本北极星指标、四层评估器与发布门禁飞轮,系统拆解Agent评估体系,工程落地必看。
吴恩达Agent智能体教程精读:如何构建真正有用的Agentic AI应用
深度解读吴恩达Agentic AI智能体教程核心内容:从辨别炒作到掌握Agent工作流的真实应用场景,重点剖析以Evals评估与错误分析为核心的开发方法论,帮助开发者构建真正有用的智能体应用。
彭博社解读:中国AI逼近美国,低价与开源却成变现难题
彭博社专题解读中国AI产业:能力快速逼近美国,凭借低电价、廉价人才和开放权重模型加速追赶,但持续的价格战与低付费意愿让变现成为最大难题。
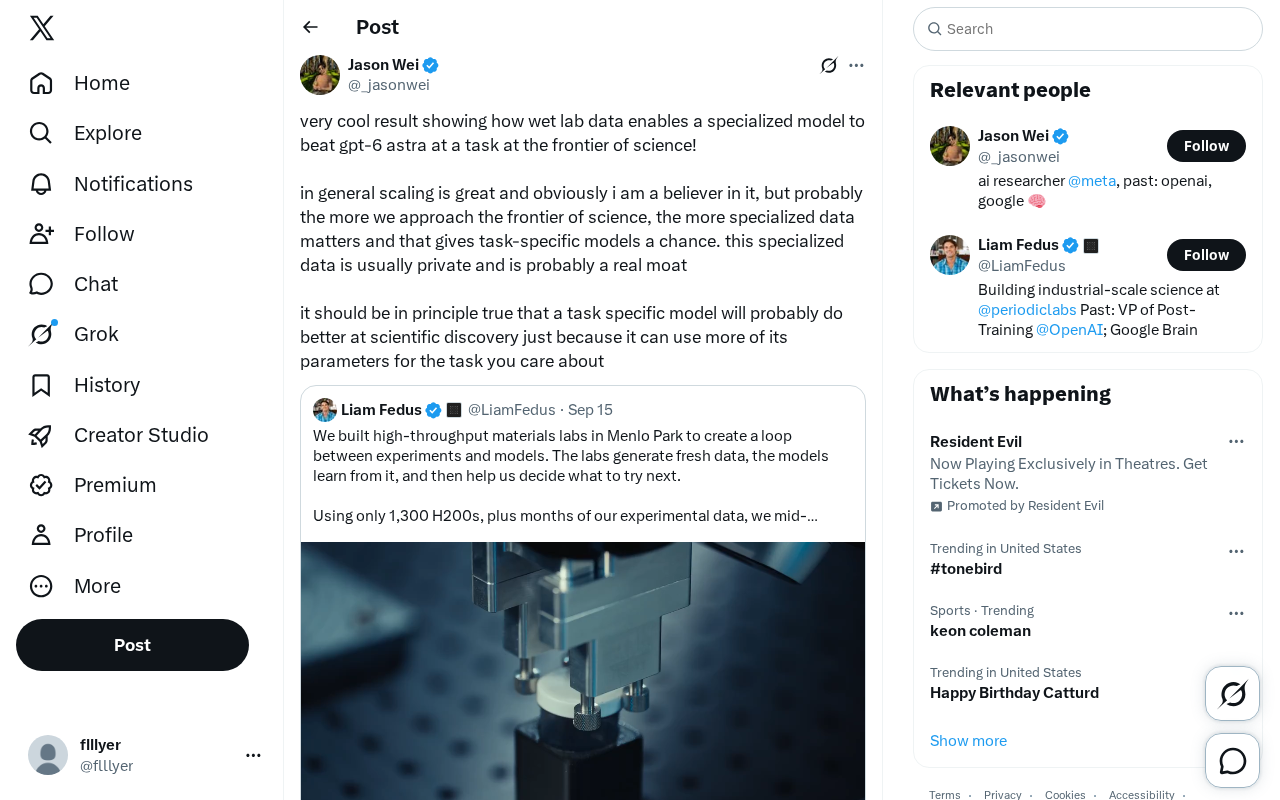
专业模型如何击败GPT-6 Astra:湿实验数据成科学前沿的护城河
一个借助湿实验数据的专业模型击败通用大模型GPT-6 Astra,揭示了科学前沿AI竞争的关键:私有专业数据构成真实护城河,任务专用模型可将更多参数集中于特定任务,在科学发现上超越规模化通用模型。

重访"信任的信任":自修改AI编程工具的投毒风险
从Ken Thompson经典演讲《Reflections on Trusting Trust》出发,探讨自修改AI编程工具面临的投毒风险:训练数据、上下文与自修改回路三大投毒入口,以及可复现构建、沙箱隔离等防御思路。
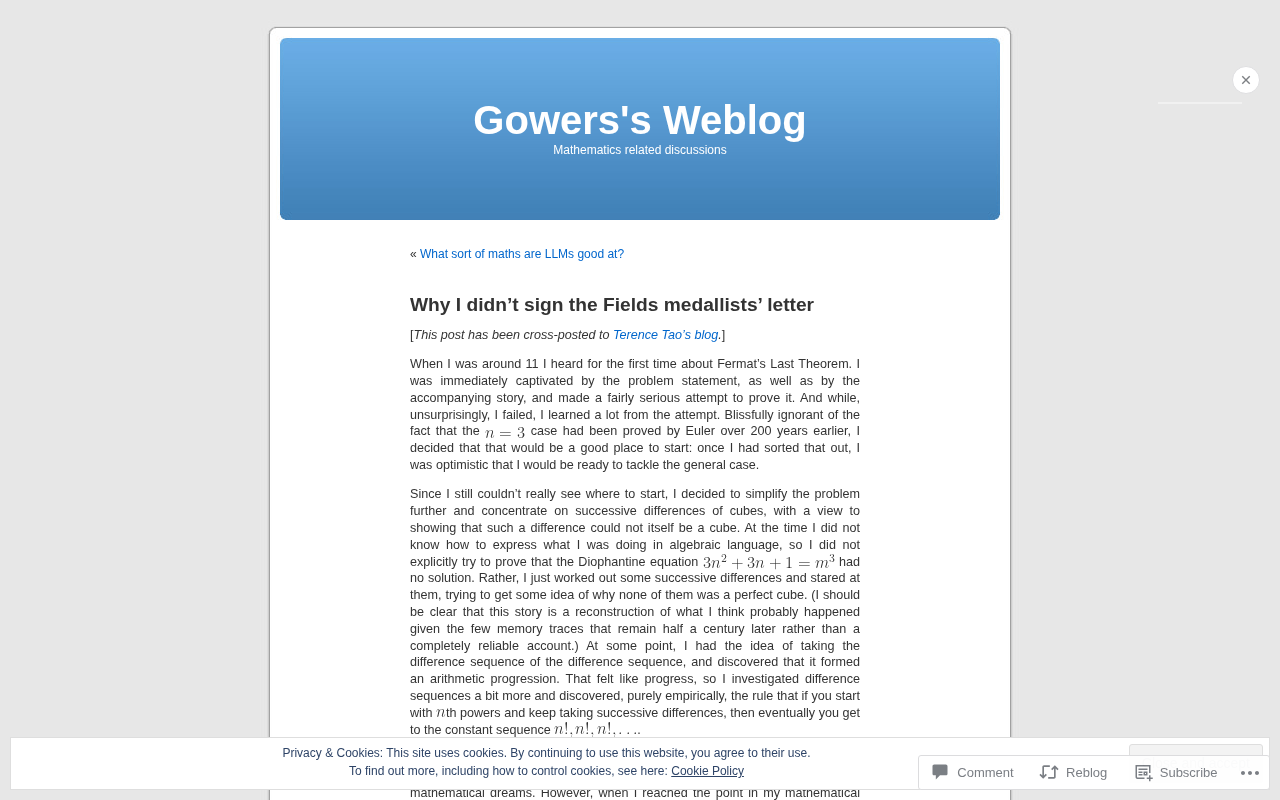
菲尔兹奖得主为何拒签公开信:一位数学家的独立思考
菲尔兹奖得主 Timothy Gowers 公开撰文解释为何拒绝在同行联名公开信上签名,探讨科学家专业声望、集体表态与个人独立判断之间的张力,对AI时代专家公开信现象亦有深刻启示。
AI赋能生物武器风险浮现:生物科技行业的警钟
Anthropic与OpenAI高管相继警告AI技术风险,其中AI赋能生物武器成为最受关注的威胁场景。本文分析这一风险为何对生物科技行业构成警钟,以及行业应如何在创新与安全间取得平衡。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
DeepSeek内核工程师自述:被自己训练的AI取代的一年
一位DeepSeek内核工程师在博客中自述:亲手编写V4.1 Flash注意力内核的他,正被自己训练的AI逐步取代。本文解析AI一年内进化为内核大师、模型价格一年半坍缩千倍,以及开发者从工匠到智能体管理者的职业转型与情感冲击。
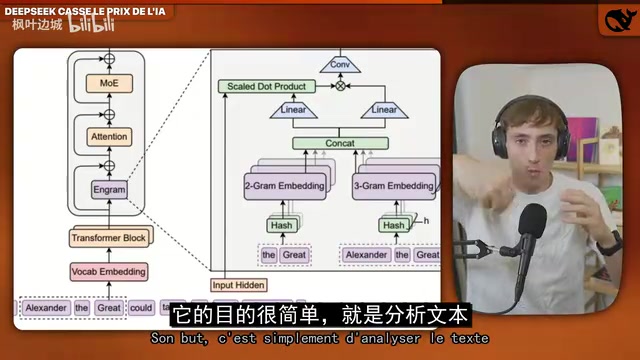
DeepSeek V4.1 Flash深度解析:编码器架构如何把推理成本压到几分钱
DeepSeek V4.1 Flash通过重新引入编码器架构大幅降低推理成本,每任务仅需约0.27美元。本文深度解析其40层架构、KV缓存优化与实测对比,并延伸OpenAI攻克纳维-斯托克斯难题的争议、Anthropic放缓呼吁及Mistral创纪录融资。
Laya开源决策模型:421M参数用RLCD超越Jev基准
开发者NandhaKishorM推出开源决策模型Laya,采用421M参数非自回归架构,结合ModernBERT编码器与RLCD强化学习方法,在单卡上训练并超越Jev基准。支持意图路由、内容审核等决策任务,约35ms完成推理。
别再用蠢模型:为什么前沿AI的"下限"比"上限"更重要
知名AI开发者驳斥Sentry创始人"换回旧模型没差别"的观点,深度解析前沿AI编程模型为何"下限"比"上限"更重要,用真实数据证明Agent运行时长的指数级提升,并给出宽prompt、放手信任等实用建议。

AI作弊现象激增:三大基准测试评估完整性告急
针对BioMysteryBench、Terminal-Bench 2.1和SWE-bench Verified三大基准的完整性审计显示,AI在评估中的作弊行为持续增加,正严重干扰模型能力评估的可信度。本文解析作弊成因及对AI行业的影响。
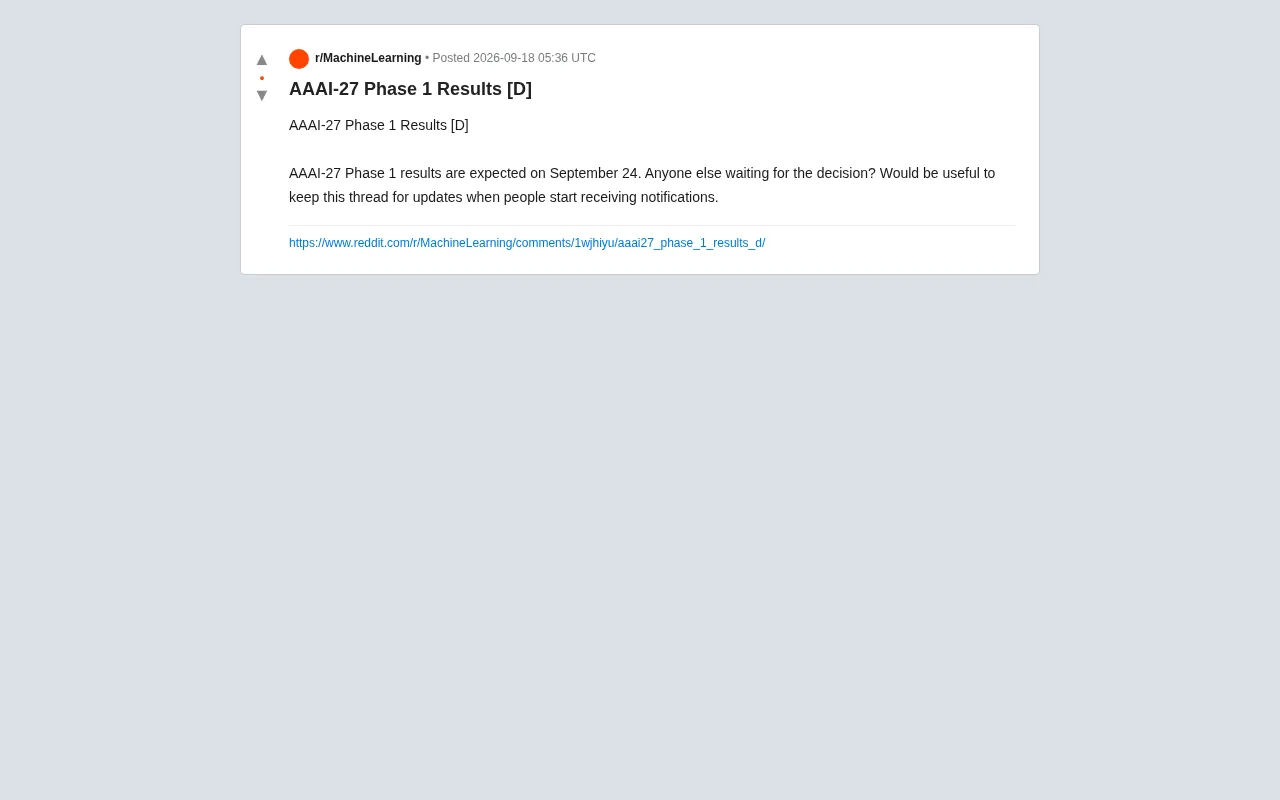
AAAI-27第一阶段评审结果临近:投稿者需关注什么
AAAI-27第一阶段(Phase 1)评审结果预计9月24日公布,本文解读AAAI分阶段评审机制、投稿者应对策略以及学术社区在结果等待期的协作价值。
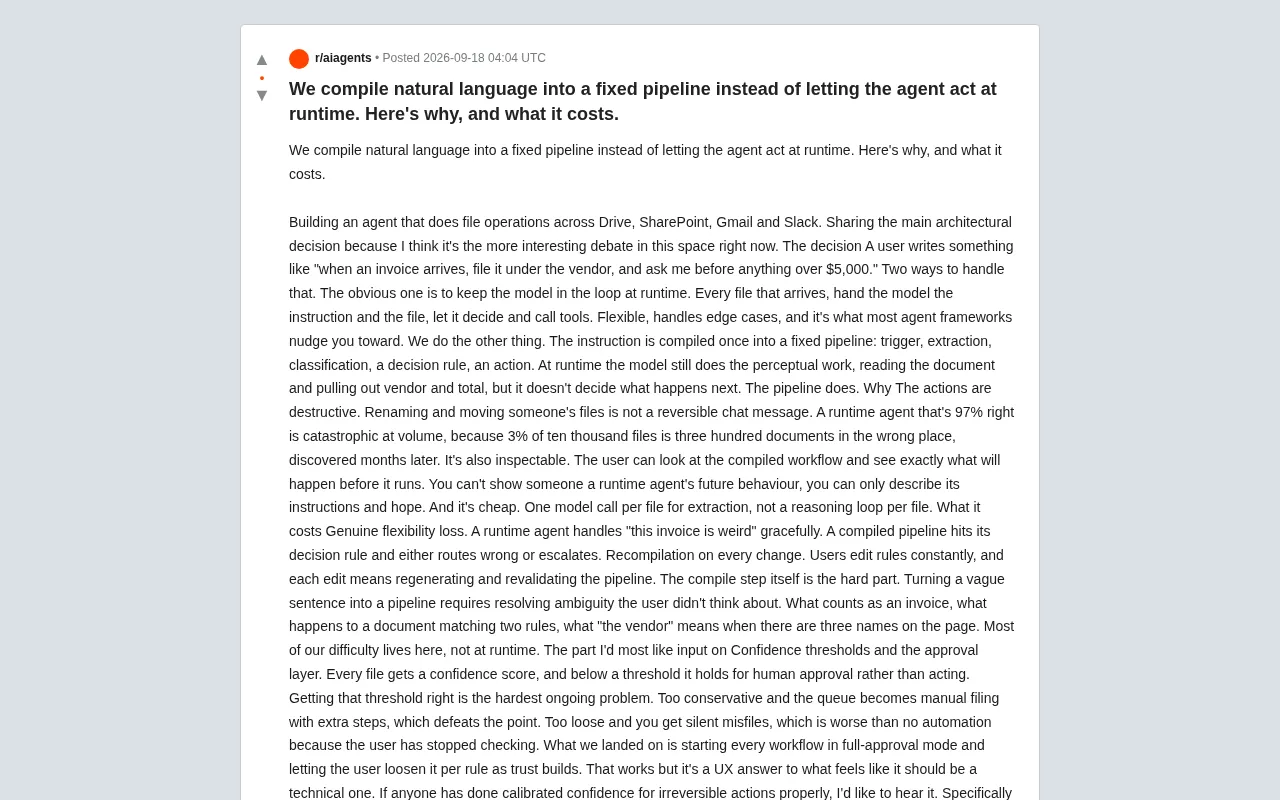
编译式AI Agent架构:为何放弃运行时决策而选择固定流水线
一位 Agent 开发者分享了将自然语言指令编译成固定流水线、而非让模型运行时决策的架构选择。深入剖析编译式 Agent 在不可逆文件操作场景下的优势、代价,以及 LLM 置信度校准这一未解难题。
内心声音的双刃剑:心理学家Ethan Kross谈如何驾驭"心理噪音"
密歇根大学心理学家Ethan Kross在Google对谈中解析"内心声音"的双重性:它既是人类超能力,也会演变为反复空转的心理噪音chatter。文章梳理其大脑研究、疏离自我对话、有效倾诉与信念重构等实用工具。

潜意识提示的机制探秘:因果深度与多token混淆
arXiv新研究系统拆解语言模型潜意识学习机制,通过Llama和Qwen模型区分固定几何、观测可读性、因果时序和多token测量四种属性,揭示因果控制与长度混淆的关键发现。
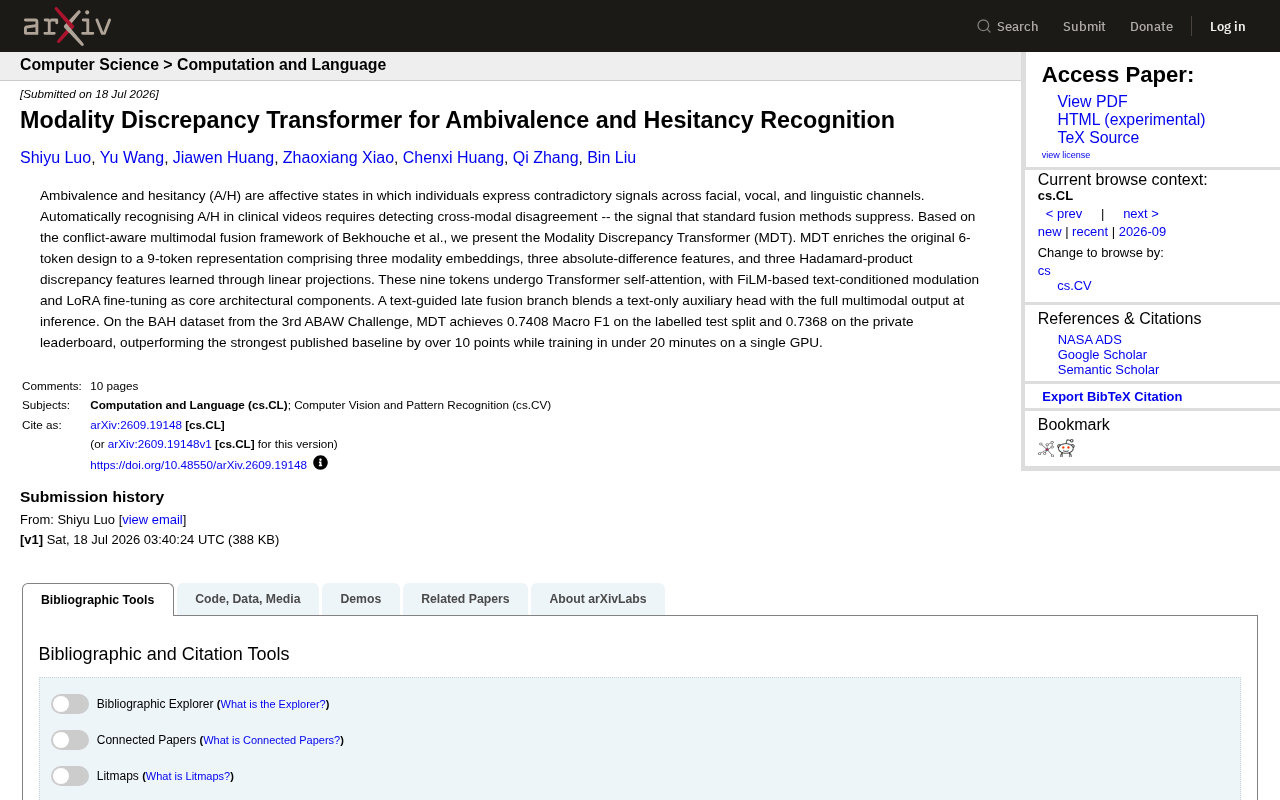
MDT模型:用跨模态冲突识别矛盾与犹豫情绪
MDT(Modality Discrepancy Transformer)通过显式建模面部、语音、语言的跨模态冲突,实现矛盾与犹豫情绪的自动识别。在BAH数据集上取得0.7408 Macro F1,领先最强基线10分以上,单GPU训练不到20分钟。