#前沿研究
共 8867 篇相关文章
长任务AI Agent需要多层反馈循环
LangChain Deep Agents课程提出循环工程框架,将AI Agent的反馈机制拆解为执行循环、验证循环和跨运行改进循环三层,帮助开发者构建在长任务中可靠运行的Agent系统。

Gemma 5 要来了?Reddit 热议谷歌开源模型节奏
Reddit 社区热议 Gemma 5 是否即将发布,讨论聚焦谷歌开源模型节奏、Gemma 与 Gemini 团队关系、预训练进展及社区对发布信号的解码心态。
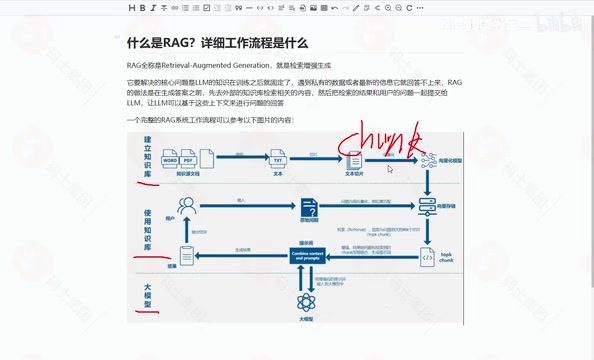
RAG面试必考:一文吃透检索增强生成工作流程
RAG是什么?本文梳理检索增强生成(RAG)的完整工作流程,涵盖离线建库的文档加载、切割、向量化、入库,以及在线阶段的输入改写、向量检索、重排与生成,解析RAG面试高频考点与核心价值。

FDE前沿部署工程师入门指南:从Palantir流派到企业级落地实战
FDE前沿部署工程师是什么?本文基于B站李锦老师的直播课,梳理FDE概念、Palantir本体论与场景驱动两大流派、微调/蒸馏/预训练技术进阶路径,以及企业落地中的预算与效果验证难题,为想走FDE路线的人提供入门参考。

美国财富不平等:一张按比例绘制的图为何引爆讨论
从Hacker News热帖“Wealth Inequality in America drawn to scale”出发,分析按比例可视化财富不平等的冲击力、数据口径争议,以及财富与收入的区别,探讨数据可视化在公共讨论中的价值与边界。

机器人真正的实力:可靠负重行走胜过炫酷演示
Reddit 用户提出,机器人能可靠负重行走比花哨演示更令人印象深刻。本文解析这一观点背后的工程逻辑:可靠性、故障恢复与可重复性才是原型走向实用系统的关键。

Artificial Analysis Intelligence Index v5 解读
解读 Artificial Analysis Intelligence Index v5 的发布,分析这一 AI 模型综合评测指数的版本演进、方法论挑战与开发者选型参考价值。

FlashMap发布:一次草拟16 token,LLM解码提速6.14倍
Polymathic AI 联合普林斯顿、USC ISI 发布 FlashMap 流映射草稿器,单次联合草拟 16 个 token,在 Qwen3-8B 上实现最高 6.14 倍无损加速。本文解析其流映射机制、加速比的实际边界,以及投机解码在部署中需要注意的问题。
Google DeepMind推出Genie 4:原生音频实时世界模型
Google DeepMind 发布 Genie 4 研究预览:实时世界模型加入原生音频、实时对话与文本操控,并由 Gemini 3.8 Flash 在模拟循环内进行事件规划。本文解析其架构变化与研究预览阶段的意义。

AI数学基础:线性代数视频系列解读
Reddit创作者分享《Math for AI & ML》线性代数视频系列,覆盖向量空间、矩阵分解、特征分解与SVD等AI数学基础,本文解读其内容价值与学习路径。

vLLM v0.33.0rc1 修复 DGX Spark 上的 NVFP4 解码测试选择器
vLLM v0.33.0rc1 通过 PR #64107 修复 DGX Spark 平台上过期的 NVFP4 解码测试选择器。本文解析这一 CI 改动背后的低精度量化测试矩阵膨胀、发布分支回迁策略与新硬件适配的隐性风险。
Hillock v1.0:用确定性搜索破解向量检索的幻觉难题
向量搜索的概率性本质导致RAG系统在无法回答的查询上产生幻觉。经过6个月测试,开源项目Hillock v1.0发布,试图在检索层引入确定性判断,让系统明确拒绝不可回答的问题,从源头减少幻觉。

Artificial Analysis智能指数v5大更新:开源与闭源差距拉大,评测可信度遭质疑
Artificial Analysis Intelligence Index 更新至 v5,官方称排名更准确,开源与闭源差距从3分扩大到12分,但60%评测基于私有测试集导致结果无法复现,社区对排名准确性提出质疑。
GPU价格崩盘前兆?小模型与算力过剩的双重挤压
Reddit讨论指出GPU价格可能迎来下跌:小模型推理效率提升、半数数据中心建设停滞、Neocloud债务压力与AI采用不及预期共同作用,算力市场供需正在重新校准。

Discord开放公共服务器内容,搜索引擎可索引
Discord宣布将允许搜索引擎索引可发现服务器中的公开消息,Google等搜索入口将可触达这些社区内容。本文解析这一变化的范围边界、平台动机、隐私争议与对社区运营的影响。

LoRA微调溯源签名:黑盒检测扩散模型变体
论文提出一种黑盒溯源协议,利用图像内在维度作为签名,在开放世界场景下检测在线服务是否使用了扩散模型的LoRA变体,区分基础模型、适应版本与其他模型家族。

TALOR:基于尾坐标校正的即插即用开集测试时适应方法
TALOR 是一种轻量、无需反向传播的即插即用校正模块,利用源分类头几何结构分解主坐标与尾坐标,在开集测试时适应中实现更高精度与更低资源消耗。

TrawMem:把智能体记忆重构为任务导向的角色自适应工作区
TrawMem 提出任务导向的角色自适应工作区框架,将智能体记忆从按相关性检索重构为按任务角色与关系组织。在 LoCoMo 与 MemGallery 上 macro-F1 提升 2.23-3.14 点,同时减少上下文 token 消耗。