#前沿研究
共 8867 篇相关文章
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。

GitHub 上最全 Jailbreak 合集:togg53192-cmd/jailbreaks 深度解析
深度解析 GitHub 热门仓库 togg53192-cmd/jailbreaks:收录 4842 Stars、775 Forks 的越狱提示词合集,单日新增 890 Stars。探讨其内容组织、社区反响及 AI 安全影响。
Papers with Code 开源重生:Apache 2.0 许可下的 AI 研究新枢纽
Papers with Code 以 Apache 2.0 许可证开源重生,采用 FastAPI 和 React 构建,提供公开 API 和 MCP 服务器,旨在社区协作打造 AI 研究论文追踪平台。
拆解Cohere指控:Qwen 3.8 Flash Next真的会偷偷上传数据吗?
Cohere指控Qwen 3.8 Flash Next向阿里URL上传数据,但测试脚本强制预填充2323个token、提示词模糊,触发概率不到十万分之一。本文拆解测试方法漏洞,分析开放权重模型行为评测的方法论问题。
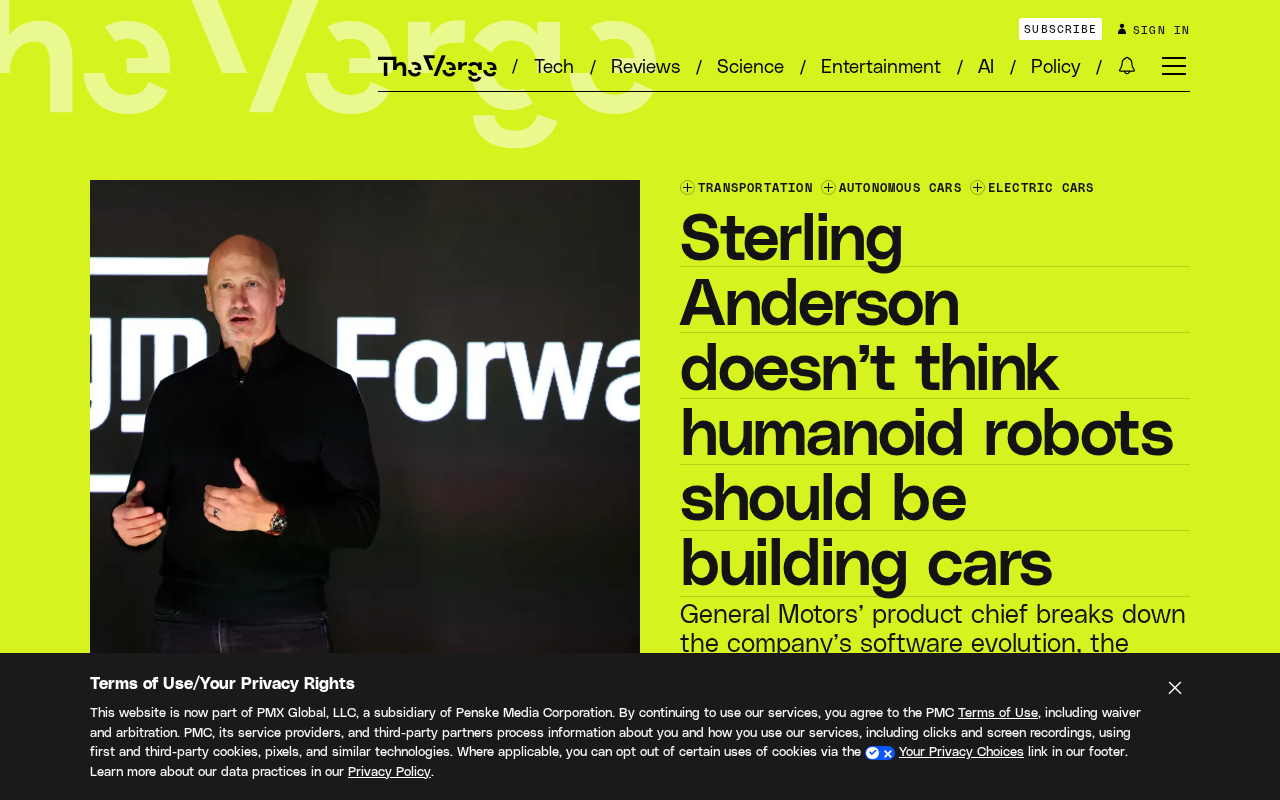
人形机器人不该造车?Sterling Anderson的质疑与通用AI路线
通用汽车公布AI驱动造车路线图之际,Sterling Anderson质疑人形机器人不应被用于造车。本文分析双方观点,拆解AI造车的软件与硬件两条路径,探讨人形机器人在汽车制造中的现实挑战。
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。

大模型Agent科研指南:智能体原理拆解与落地思路
从B站UP主的通俗讲解出发,拆解Agent智能体的核心原理:理解命令、任务拆分、逐步调用大模型。分析Agent依赖规则设计的现实局限,为科研选题提供从规则设计切入的实验落地思路。

Abliterated DeepSeek 推理服务商增至五家
Abliterated DeepSeek 推理服务商已增至五家,Hacker News 社区就此展开讨论。本文解析 abliteration 的技术含义、多服务商出现的成因,以及对开发者在选择、版本一致性和合规风险方面的实际影响。

进化策略的质心解读:一种更直观的几何视角
进化策略(ES)的质心解读:将扰动模型视为粒子、奖励视为质量,ES更新等价于种群质心位移。解释均值减除的几何意义及反对称采样下的简化,提供直观的几何视角。

多语言语音识别扩展:源感知适配与模型合并策略
研究提出基于连接器的语音大语言模型多语言扩展方法,通过SSU-Wanda+TIES合并策略在单目标扩展中平衡新语言学习与源语言保留,多目标扩展中更新合并比递归扩展更稳定。

Jev式System One模型能减少选择偏差吗?结构稳定性遭质疑
一项系统性测试揭示:Jev式System One模型虽准确率稳定,但选项洗牌后累积失败集扩大27%-29%,且不如生成式LLM更具抗偏差优势。投票聚合保护有限,一致同意答案也常出错。
LLM研究报告的“主张平滑”现象:SmoothScore量化评估
LLM研究代理在生成报告时存在“主张平滑”现象,即给出比证据支持的更自信结论。研究者提出SmoothScore量化该效应,并在7系统4数据集上验证代理一致产生更强主张。

原子安全关切:构建网络安全知识的统一语言
一篇最新论文提出原子安全关切(ASCs)概念,试图用有限的基础词汇组合表示网络安全知识,为跨框架的安全概念映射、自动化合规推理和知识表示提供统一语言框架。

非生成模型JEV能否胜任临床试验标准评估?
研究对比非生成模型JEV与Qwen Flash在临床试验标准评估中的表现:JEV在MIMIC-III上宏F1大幅领先,信息不足条件召回率56.3% vs 9.9%,延迟更低、成本降低53%-74%,但需人工验证错误。

LLM评估新框架:自置信度与LLM辅助审计的统计效率
论文提出统一统计框架,分析LLM评估中置信度分层审计与LLM-as-a-judge的统计效率。实验表明校准不佳的置信度仍可支持有效审计,按比例分配显著降低估计误差,而法官辅助评估仅在小部分场景下具备成本优势。

Transformer泛化边界新解:长序列训练为何比多样本更高效
最新研究联合分析Transformer的分布内泛化与长度泛化,发现增加训练长度比增加样本数指数级更高效,为长序列训练策略提供理论依据。
无检索器检索:DecisionRAG用决策模型导航文档
DecisionRAG提出无检索器检索新范式:用决策模型在单次前向传播中联合评估候选分支,沿语料库结构逐层导航,无需任务训练即超越8B重排器的稠密检索,检索仅需0.7-1.8秒。

