#多模态
共 115 篇相关文章
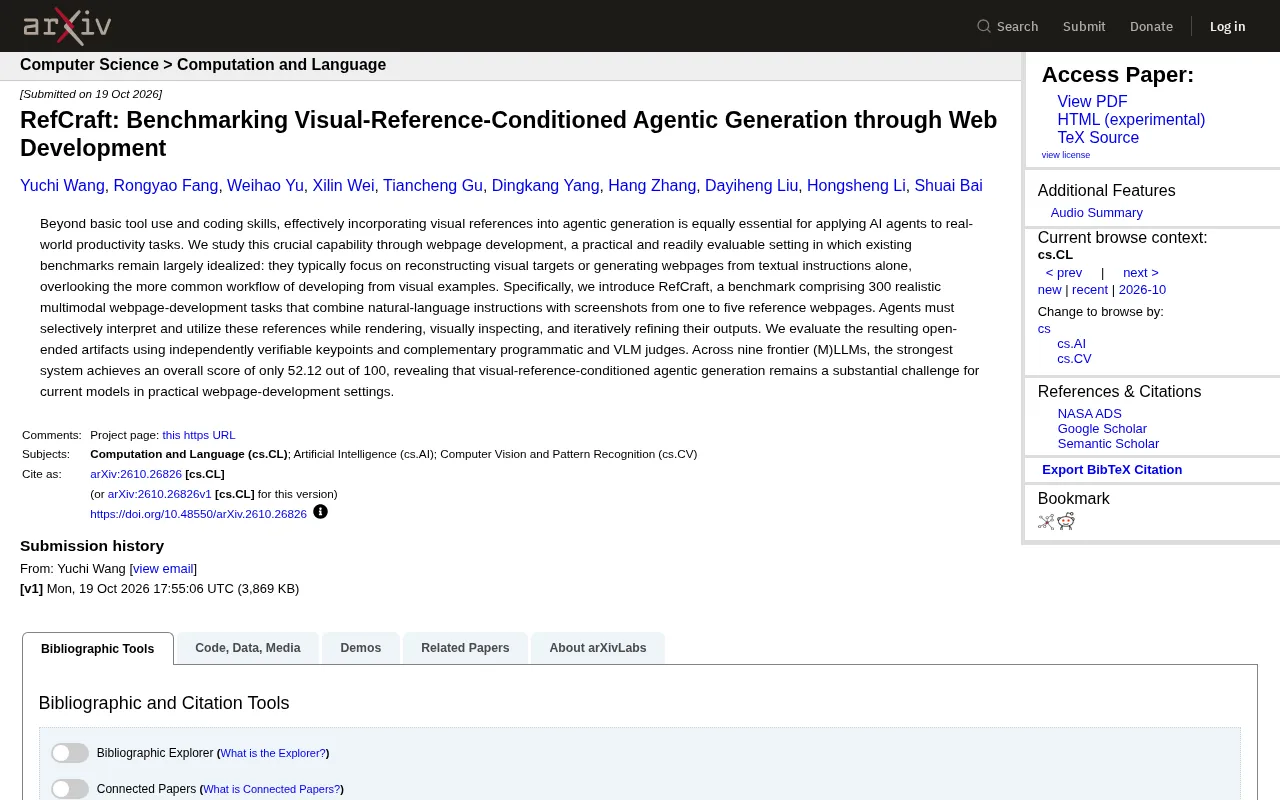
RefCraft基准:视觉参考驱动的AI网页生成仅52分
RefCraft基准包含300个多模态网页开发任务,要求AI智能体结合自然语言指令和参考截图生成网页。九大前沿模型测试中最高分仅52.12,揭示视觉参考条件化生成的挑战。
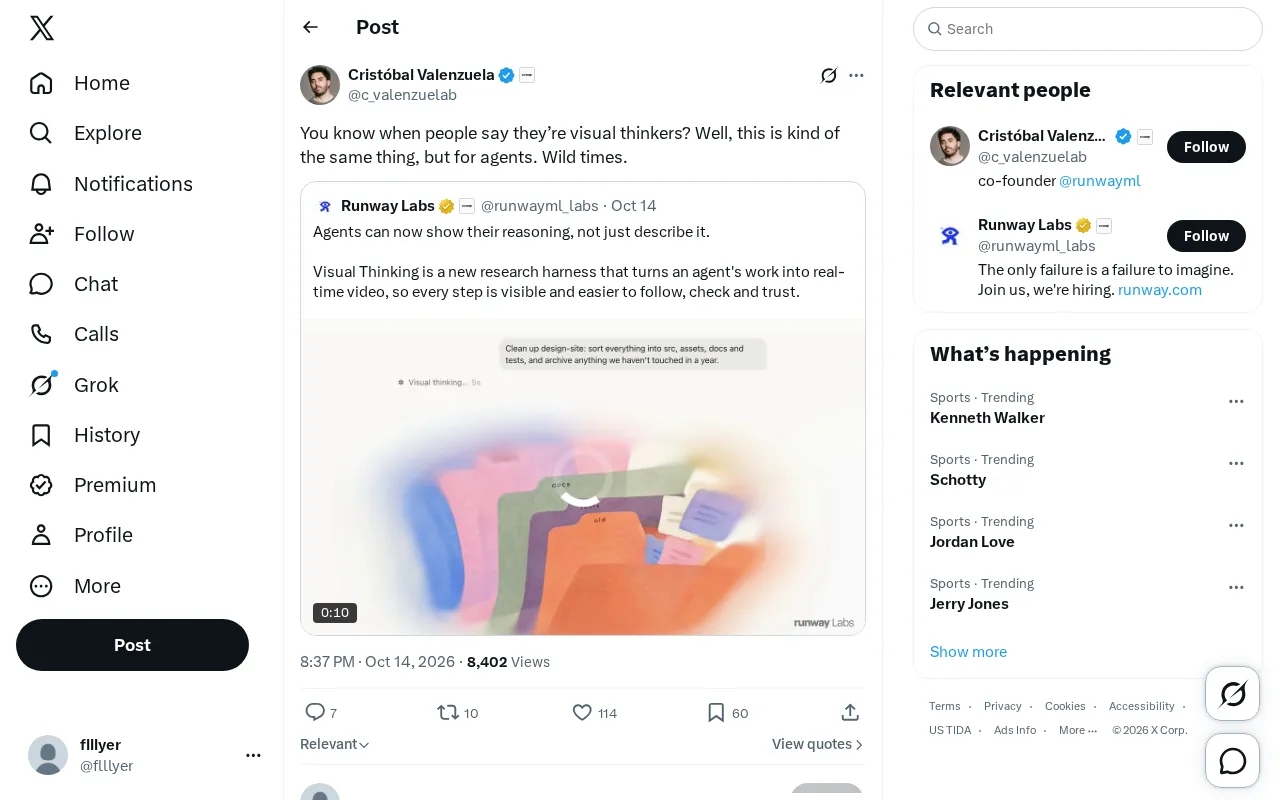
AI代理的“视觉思维”:一场静默的认知革命
AI代理正从文本推理走向视觉思维,像人类一样在内部构建图像来理解和规划。本文解析这一趋势的技术基石、应用前景与可解释性挑战,探讨多模态大模型如何赋予代理空间推理与具身智能能力。

通用视觉模型输出边界框,为什么必须加验证层
通用视觉语言模型可直接返回边界框和目标检测结果,但生产使用前必须验证 schema、坐标和标签。本文基于 Google DeepMind 专家在 Chain of Thought 播客中的观点,给出边界框校验规则、Python 校验代码示例,以及机器人和微调场景下的评测要点。
Elorian Glimpse:会"回看"的视觉模型,推理中主动放大图像细节
Elorian 发布首个视觉模型 Glimpse,推理中可主动回看图像、裁剪区域并运行代码测量,采用视觉草稿空间架构。本文解析其技术原理、每百万 token 0.6 美元的定价策略、数百 GPU 训练传闻,以及截图调试、PDF 图表提取等落地场景与待验证风险。

Hatching (Heraldry):当AI内容创作遇上纹章学排线传统
从Hacker News热议的纹章学排线法(Hatching)出发,探讨视觉编码传统对AI内容创作、多模态转换与可访问性设计的启发,理解约束条件下的语义保真与编码思维。

英伟达开源Nemotron 3.5 Super VL:120B多模态模型专攻智能体
英伟达开源Nemotron 3.5 Super VL多模态模型:120B MoE架构、12B激活参数,支持文本图像文档视频输入与工具调用,单GPU智能体吞吐最高提升5倍,权重训练配方数据集全部开放。

英伟达Nemotron 3.5 Super VL登陆Perplexity
英伟达Nemotron 3.5 Super VL视觉语言模型现已登陆Perplexity,面向Pro和Max订阅用户开放,并通过Agent API向开发者提供。本文解读模型定位、对用户与开发者的实际影响以及多模态分发的行业趋势。

Muse Spark Open登陆vLLM:小模型的大故事
Muse Spark Open模型登陆vLLM推理引擎,集多模态理解、1M上下文、智能体规划、DSpark与跨平台支持于一体。本文解读其技术特性、vLLM集成意义及对开发者的实际影响。
NVIDIA Nemotron 3.5 Super VL:Mamba-MoE混合架构解析
NVIDIA Nemotron 3.5 Super VL 120B A12B 采用 Mamba-MoE 混合架构、RADIO 视觉塔与 NVFP4 四位量化,每 token 仅激活 12B 参数,B200 吞吐达 185 tokens/秒。本文解析其架构、基准表现与部署方案。

P³IBench:视频助手从感知到干预的主动理解评测
P³IBench 是面向真实流式场景的主动视频理解基准,评测日常感知、风险预测与干预三类能力。12 个视频语言模型在响应决策上普遍表现不佳,4B 助手 P³I-Assistant-4B 虽有提升但收益不均,说明主动协助需要精确时机判断与适当克制。

双重视图破解时序推理:TSLM准确率提升近9个百分点
论文提出互补表示设计原则,通过线图和归一化延迟嵌入双重视图提升时间序列语言模型推理能力,TSRBench准确率从44.5%提升至53.2%,大幅超越专用TSLM基线。

OmniVerifier-C1:从二值判断到分级评分,视觉验证器如何重塑生成式世界模型
OmniVerifier-C1 提出分解式分级视觉验证器,把复杂提示拆解为细粒度子问题并给出连续评分,结合解耦式 RL 训练,在文本到图像与迷宫、数独等规则世界建模任务上优于传统二值验证器。

Gemini 4 Argon发布:10个硬核Demo全解析
谷歌Gemini 4 Argon发布,单次可输出100万Token,支持持续推理与独立完成复杂任务。本文深度解析10个官方Demo:从Fortran代码迁移、ADK运行时优化,到桌面赛车游戏、NASA月球任务可视化与实体硬件生成,揭示AI从回答问题转向独立完成项目的关键变化。

SSR框架:让小模型多模态搜索智能体告别冗长推理
SSR框架提出用选择替代生成的多模态推理新范式,让小模型搜索智能体不再生成冗长无效推理,大幅降低推理成本,为资源受限场景提供高效解决方案。

学会回答空间问题,能否提升新视角生成?
论文 Ask4NV 探索 3D 语言理解能否为新视角生成提供互补监督:基于 Mixture-of-Transformers 架构,把相机几何注入 VAE 与 ViT,并通过联合自注意力复用理解特征,实验显示图像质量与几何一致性良好,且跨视角对应与 3D 特征相似度得到改善。
DynThinker:统一静态3D与动态4D空间推理
DynThinker提出统一框架,同时强化静态3D与动态4D空间推理。通过D-EMA约束干扰敏感参数、SDF融合时空先验,在十项指标上取得领先,创开源模型新最优。

多模态基础模型实现等离子体态重建新突破
研究人员提出面向磁重联的多模态基础模型,利用5.5M参数残差3D U-Net从稀疏异构诊断中重建磁场和密度。独立掩码训练实现跨模态补全、超分辨率,0.1%磁场可见度即可大幅提升密度重建精度。

EgoOmniWorld:以自我-动作-世界交互统一第一人称视频理解
EgoOmniWorld 提出 Ego-Action-World 交互循环作为统一原则,用 Node、Edge、Chain、Loop 四种结构重新组织第一人称视频理解评测,包含 24,166 个 QA 组,揭示多模态大模型在交互理解上的结构性短板。

