#多模态
共 115 篇相关文章

EmbeddingGemma 2实测:手机就能跑的多模态检索模型
Google开源的EmbeddingGemma 2把文本、图像、视频、音频映射进同一向量空间,小到能在手机运行。本文解析其架构原理,并通过Colab实测图片、语音、视频、文档的多模态检索效果与短板。

EmbeddingGemma 2 浏览器端图文检索:WebGPU 本地推理实践
EmbeddingGemma 2 将图像与文本映射到同一 768 维向量空间,实现图文检索。开发者借助 WebGPU 推理库 ruNNtime,让图片语义搜索完全在浏览器 GPU 本地运行,兼顾隐私与零部署成本。
MiniCPM-V-4.7-35B-A3B 现身 HuggingFace:MoE 多模态新动向
HuggingFace 平台现身 MiniCPM-V-4.7-35B-A3B 新模型条目,命名暗示其采用总参数 35B、激活 3B 的 MoE 多模态架构。本文解读命名含义与技术趋势,目前模型卡尚未发布。

OpenAI推出Decisions API:毫秒级决策的轻量模型
OpenAI 发布 Decisions API,基于 GPT-6 Luna 模型,让 AI 在毫秒级内完成文本与图像的多选决策,响应低于100毫秒,可用于工单分类、实时视觉动作与机器人控制等低延迟场景。
EmbeddingGemma 2发布:端侧多模态嵌入模型新标杆
Google DeepMind 发布 EmbeddingGemma 2,一款开源轻量级多模态嵌入模型。仅 7.4 亿参数即可在手机端统一处理文本、代码、图像、音频和视频,支持 8K 上下文与离线 RAG,Apache 2.0 许可证商用友好。
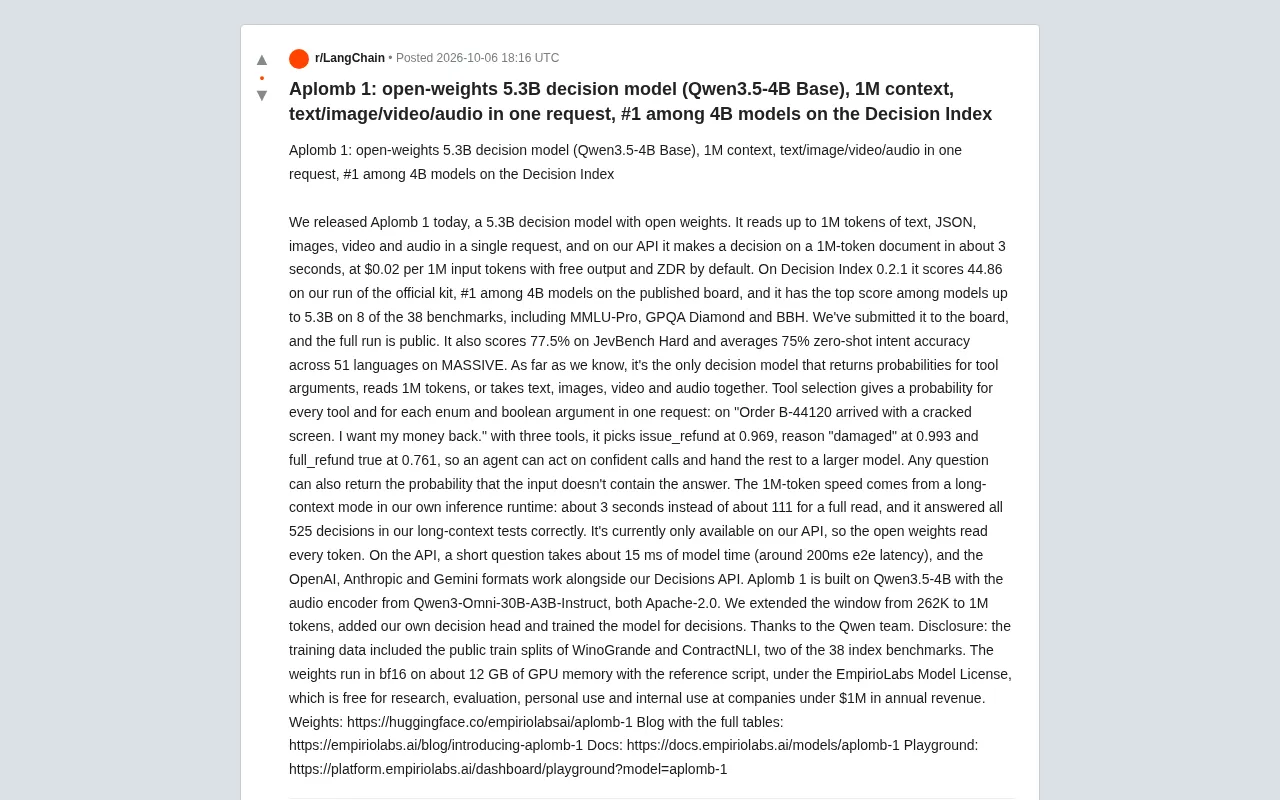
Aplomb 1:53亿参数决策模型,1M上下文四模态输入
EmpirioLabs 发布开放权重决策模型 Aplomb 1,基于 Qwen3.5-4B,仅 53 亿参数却支持 1M token 上下文、文本图像视频音频四模态输入,并为工具调用参数返回概率,在 4B 级别 Decision Index 榜单登顶。

Transformers v5.19.0 发布:EmbeddingGemma 2 多模态嵌入与 MoE 重大变更
Hugging Face Transformers v5.19.0 发布,新增谷歌 EmbeddingGemma 2 多模态嵌入模型,并对 MoE 路由 logits、注意力机制、持续批处理和专家并行引入多项破坏性变更与性能优化。

OctLLM:用八叉树让大模型看懂3D几何结构
arXiv论文OctLLM提出用八叉树作为显式3D语言,通过稀疏八叉树和独立参数分支,让大模型在不牺牲语言能力的前提下理解和生成3D几何,图像生成3D的FID降低17.4%,刷新统一多模态LLM的SOTA。

多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。

DeepSeek 4.1 Flash发布:多模态加持的高速推理模型
DeepSeek 4.1 Flash多模态开源模型发布,支持图像理解、文本处理与编程任务,采用新架构提升推理速度与效率。本文介绍其核心特性及如何通过模型目录与无服务器推理快速体验。
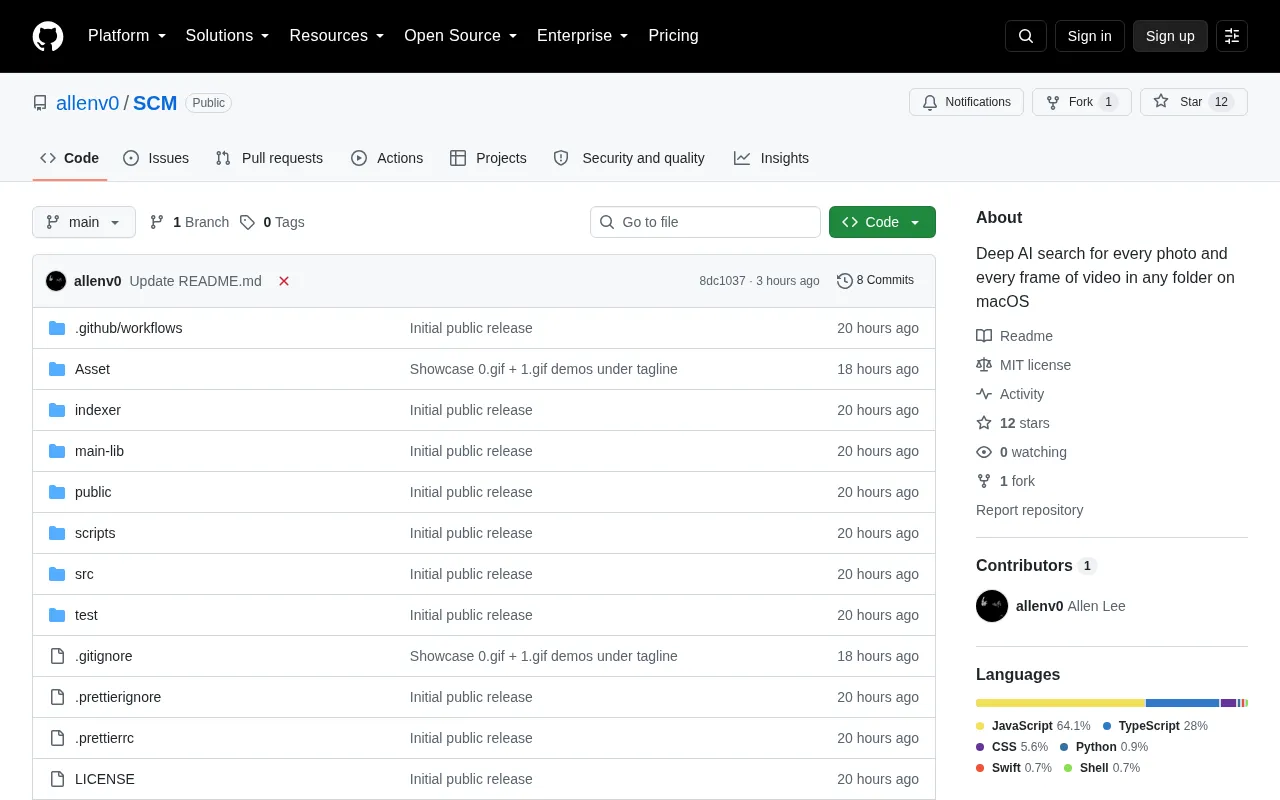
macOS本地AI搜图新尝试:照片与视频逐帧语义检索
一款macOS本地AI搜索工具亮相Hacker News,支持对每张照片和视频每一帧进行语义检索。本文解析其逐帧检索的技术逻辑、本地化隐私优势及早期阶段的局限。
GLM 5.3 Flash 上线 Serverless 训练 API:支持视觉与文本微调
GLM 5.3 Flash 现已登陆 Serverless Training API,面向所有用户开放,支持视觉与文本双模态微调。该模型在智能体编程、文档分析和工具调用等基准上表现优异,且服务成本低,适合智能体应用开发。

Transformers 5.18.0 发布:四款新模型加持多模态与说话人分离
Hugging Face Transformers 5.18.0 正式发布,新增 Nemotron 3 Diarization、NemotronH Omni、HyperCLOVAX Vision V2 和 GTE 四款模型,涵盖语音分离、多模态推理与文本检索,同时带来六项破坏性改动及分布式、量化能力增强。

Opus 5.5 用一镜到底动画将人类史浓缩为24小时
Claude Opus 5.5 据称以一镜到底方式生成动画视频,将人类历史浓缩为24小时并配原创音乐。本文分析AI多模态端到端创作能力的意义与需审慎看待之处。

Wity-1推理决策模型:介于全推理与零推理之间的新思路
新模型Wity-1自称为推理决策模型,介于纯决策模型JEV与完全推理LLM之间,只推理到答案达成即停止,并声称在四项基线与Image JEV Bench上领先。本文解析其技术思路并保持审慎评估。
CO₂Jump:解决文图联合生成不一致的自纠正采样方法
Google、DeepMind 与石溪大学联合提出 CO₂Jump 采样方法,通过文本置信度与跨模态注意力解决文图联合生成的不一致问题,支持自纠正且无需额外训练,在图像编辑、迷宫、数织任务上表现优异。
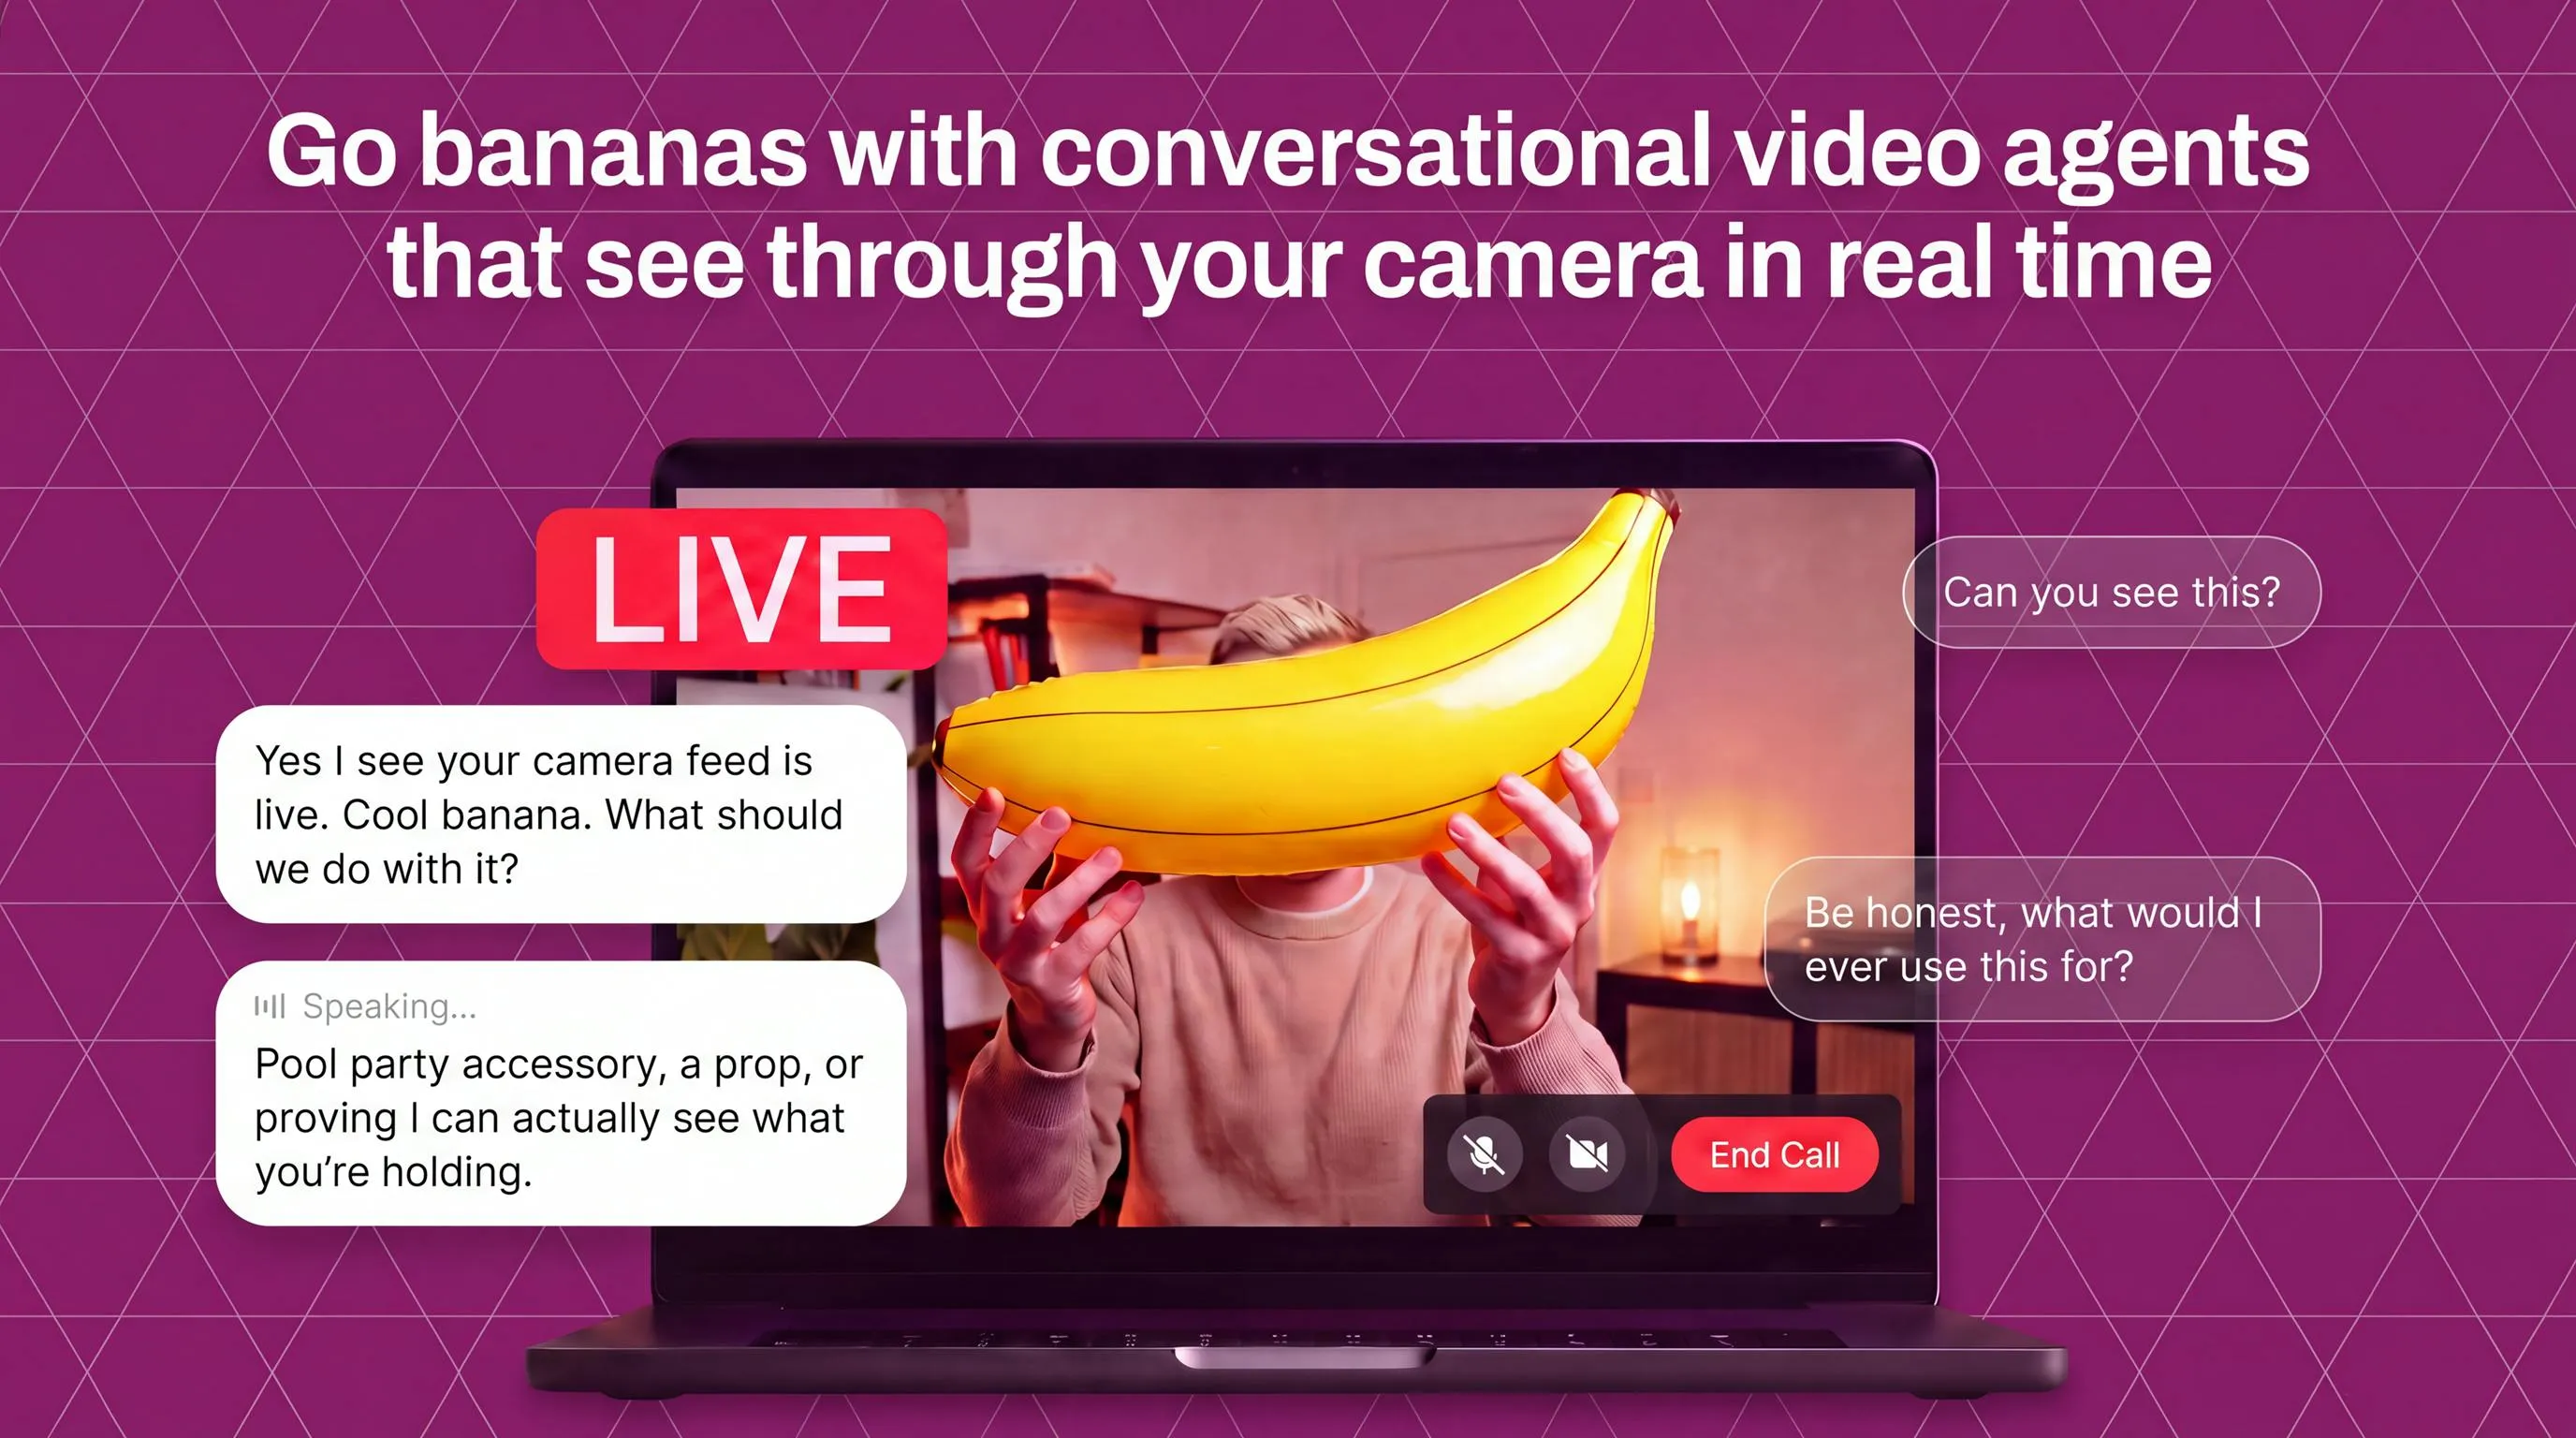
Eclatira:可嵌入任意技术栈的对话式视频AI智能体
Eclatira 是一款登上 Product Hunt 榜单的对话式视频AI开发者工具,提供语音到语音、实时视觉及跨栈执行能力,支持自定义API、MCP和3000+应用集成,帮助开发者快速构建多模态视频智能体。

视觉大模型入门指南:从预训练到下游任务全解析
视觉大模型入门系统教程:解析预训练与下游任务适配两大板块,梳理从BERT到GPT-4V的大模型演进,讲解LLM、VLM分类及从通才到专才的迁移学习路径,附学习前置要求与算力建议。