#多模态
共 123 篇相关文章

SSR框架:让小模型多模态搜索智能体告别冗长推理
SSR框架提出用选择替代生成的多模态推理新范式,让小模型搜索智能体不再生成冗长无效推理,大幅降低推理成本,为资源受限场景提供高效解决方案。

学会回答空间问题,能否提升新视角生成?
论文 Ask4NV 探索 3D 语言理解能否为新视角生成提供互补监督:基于 Mixture-of-Transformers 架构,把相机几何注入 VAE 与 ViT,并通过联合自注意力复用理解特征,实验显示图像质量与几何一致性良好,且跨视角对应与 3D 特征相似度得到改善。
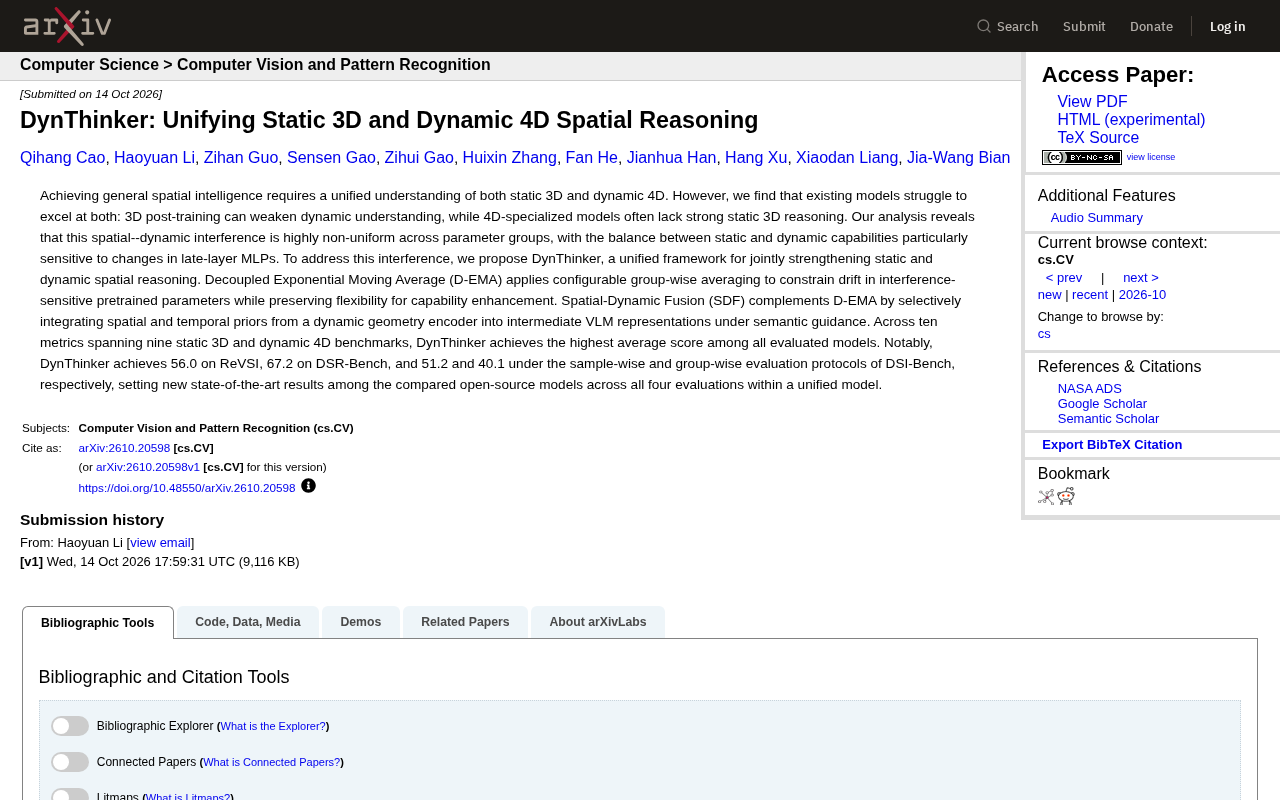
DynThinker:统一静态3D与动态4D空间推理
DynThinker提出统一框架,同时强化静态3D与动态4D空间推理。通过D-EMA约束干扰敏感参数、SDF融合时空先验,在十项指标上取得领先,创开源模型新最优。

多模态基础模型实现等离子体态重建新突破
研究人员提出面向磁重联的多模态基础模型,利用5.5M参数残差3D U-Net从稀疏异构诊断中重建磁场和密度。独立掩码训练实现跨模态补全、超分辨率,0.1%磁场可见度即可大幅提升密度重建精度。

EgoOmniWorld:以自我-动作-世界交互统一第一人称视频理解
EgoOmniWorld 提出 Ego-Action-World 交互循环作为统一原则,用 Node、Edge、Chain、Loop 四种结构重新组织第一人称视频理解评测,包含 24,166 个 QA 组,揭示多模态大模型在交互理解上的结构性短板。

LLM读取工程图纸:准确率从50%到95%的实战复盘
建筑自动化公司Nebulae用LLM读取工程图纸IO清单,准确率从50%提升到95%以上。本文拆解他们的人机协作工作流:多视图输入、结构化输出、领域few-shot示例和人工检查点设计。

用 LangChain 构建多模态 AI 客服:图文语音一次搞定
基于 LangChain 构建多模态 AI 客服 Agent 的完整教程:用图文和语音消息排查 App 报错,涵盖 Base64 编码、thread_id 对话记忆、模型媒体支持边界与隐私注意事项。

FastBench:流式VLM能否感知高动态真实视频流?
FastBench 是面向高动态真实视频流的流式VLM评测基准,包含306个QA对与人工标注证据区间。最强模型 Gemini-3.5-Flash 仅得 50.7%,揭示稀疏采样下快速事件感知的严重短板,并提出免训练基线 ProactiveFrame。

WOVEN:用视觉转移推理重构多模态LLM世界模型训练
WOVEN 论文提出视觉转移推理是多模态大模型的共享短板,构建 36,076 条三维标注样本,评测 38 个前沿 MLLM,并给出可按推理操作选择训练数据的配方。

Google EmbeddingGemma 2:轻量级多模态嵌入模型开源
Google DeepMind 开源 EmbeddingGemma 2 多模态嵌入模型,740M 参数支持文本、代码、图像、视频、音频统一检索,端侧运行文本模式仅需 191MB 内存,MTEB Code 分数从 68.76 提升至 78.68,Apache 2.0 许可。

TrailLens Audio:用本地Gemma 3打造离线自然观察助手
TrailLens Audio 是一款开源徒步伴侣应用,基于本地运行的 Gemma 3 4B 和 Kokoro 82M 实现离线物种识别与语音讲解,并通过 Pocket Quest 功能引导用户放下手机、重返自然。本文解析其技术栈与设计理念。

Decision 3.0开源发布:0.6B-27B多模态决策模型登顶双榜
vLLM Semantic Router团队开源发布Decision 3.0多模态决策模型家族,参数从0.6B到27B,支持文本、图像和视频输入,在Jev Decision Index文本与视觉双榜登顶,Apache-2.0协议可商用。

AI研究前沿综述:自蒸馏推理、稀疏专家与机器人世界模型
本期AI/ML研究综述解读自蒸馏空间推理、MoE稀疏专家服务端剪枝、长上下文高效建模与机器人视觉-语言-动作架构等前沿进展,涵盖SpatialOPSD、SlimWise、LOOM等多项代表性论文。

SpatialASM:让视觉语言模型学会主动空间想象
SpatialASM 提出可扩展框架,通过训练时空间模拟将主动空间心智化(ASM)能力内化进视觉语言模型,在七个基准、四种骨干模型上提升空间推理表现,同时保留通用视觉能力。

带视觉能力的Jev:文档图像理解的新可能
Reddit社区讨论了一个带视觉能力的新模型,可直接理解文档图像并给出校准结果,在发票核对、合同签名审查等场景潜力巨大。本文解析其价值与局限。

一条推文背后的AI叙事:当算法学会讲述"寻找爱情"的故事
一条关于"缪斯寻找爱情"的推文背后,是AI叙事内容兴起的缩影。本文从截图碎片还原这个民谣式故事,并分析叙事型AI、多模态创作与情感表达的趋势。

Meta重返开源:30B模型Muse Glimmer单张24G显卡可跑
Meta重返开源,推出30B参数的开放权重模型Muse Glimmer,单张24GB显卡即可运行,采用Apache 2.0许可证,支持多模态与推测解码加速。海外博主实测其编程、建模与前端设计能力,带你了解这款亲民本地大模型的真实表现。

OpenAI 推出 Decisions API:让 AI 在毫秒间做决定
OpenAI 推出 Decisions API,基于 GPT-6 Luna 运行,可在毫秒级完成文本与图像的智能决策,支持销售线索分流、车道判断、机器人控制等场景,速度较传统推理提升近十倍。
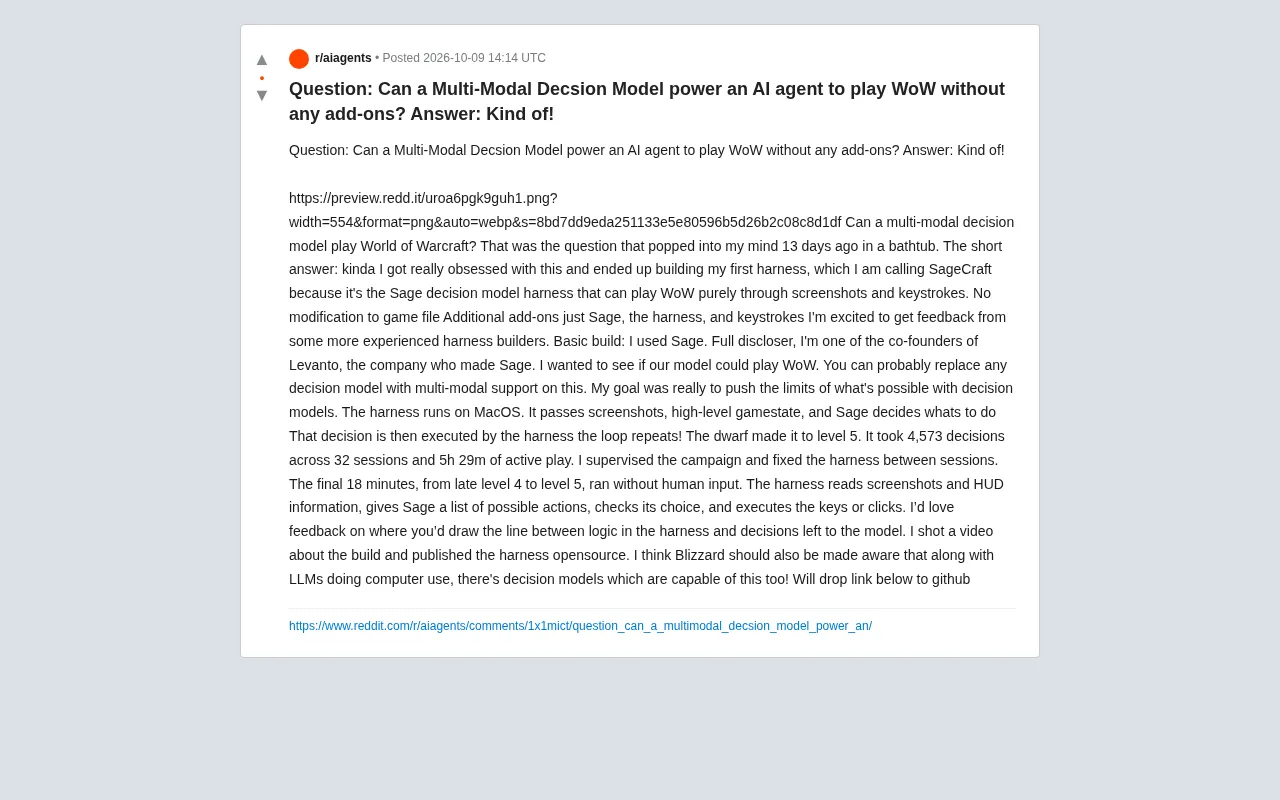
多模态决策模型能否驾驭魔兽世界?SageCraft的开源实验
开发者用多模态决策模型Sage构建开源框架SageCraft,仅靠截图和键盘操作玩《魔兽世界》,不装插件不改游戏文件。实验历时5小时29分、4573次决策将角色升至5级,并探讨了AI agent中harness逻辑与模型决策的边界问题。

SPLIT-RL:分阶段训练破解视觉语言推理的能力归因难题
arXiv新论文SPLIT-RL提出分阶段视觉语言推理训练方法,通过能力解耦与Claim-Level Advantage细粒度优势,在Qwen3-VL与InternVL3.5上使准确率提升1.4-6.1点,同时改善感知与推理双能力。