#大语言模型
共 302 篇相关文章

分词边界的代价:压缩效率与预测质量的量化博弈
arXiv 最新论文量化分词边界的压缩代价:英文维基上边界规则使 token 数增加 28.3%-36.8%,BPE 比无约束下界高 10.9%。研究还发现压缩与预测偏爱不同词典,并提出边界许可证机制,仅放宽 10% 词表即可恢复绝大部分压缩收益。
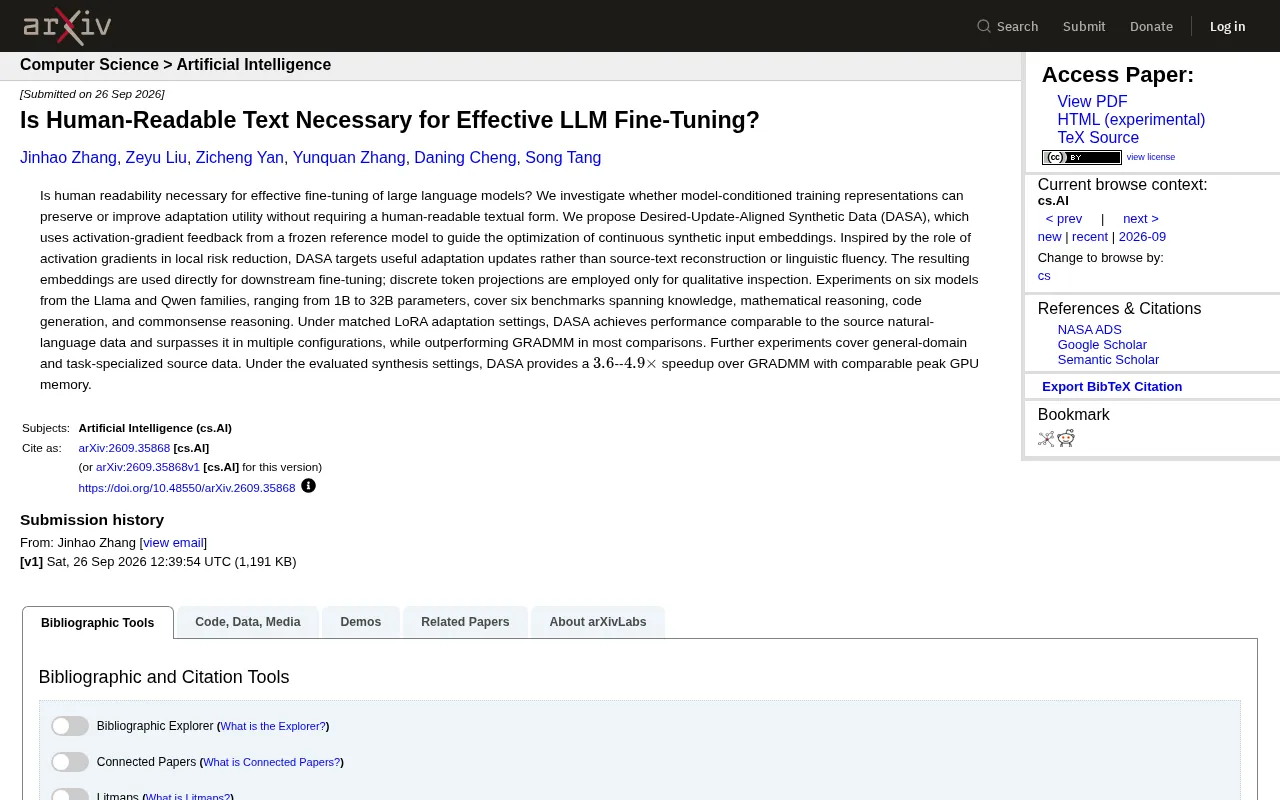
微调LLM还需要人类可读文本吗?DASA给出否定答案
arXiv新论文提出DASA方法,通过激活梯度反馈优化连续合成嵌入用于LLM微调,无需人类可读文本。在Llama和Qwen共6个模型上,性能追平并超越自然语言数据,较GRADMM提速3.6-4.9倍。

Claude Sonnet 5.5实测:性能飙升成本骤降的商业甜点级AI
Anthropic低调发布Claude Sonnet 5.5,编程基准从10.3%飙升至70.6%,速度提升30%、成本降低30%,定价仅Opus一半。本文深度解读其编程能力、知识工作表现、成本优势与安全防护。
GPT-6.1 Sol发布:性价比大幅提升的近旗舰级模型
OpenAI在DevDay推出GPT-6.1 Sol,主打以五分之一价格实现接近Astra旗舰的智能。开发者Simon Willison通过"骑自行车的鹈鹕"测试给出初步观察,分析这款主打性价比的新模型。

GPT 6.1 Sol 发布引发热议:素材有限下的初步观察
OpenAI 官网发布 GPT 6.1 Sol 引发 Hacker News 热议,短时间获 294 赞和 200+ 评论。本文梳理已知信息、社区反应与命名策略背后的考量,并提供理性评估新模型的方法。

白宫押注AI聊天机器人:America.gov能否破解政府迷宫?
美国政府推出America.gov,试图用AI聊天机器人简化公民办事流程。但大语言模型的幻觉问题在高风险的公共服务场景中带来严峻挑战。本文分析这场公共AI实验的机遇与风险。

RAG流水线到底败在哪:检索还是生成?
RAG 流水线效果不佳,问题到底出在检索还是生成?本文剖析两个阶段的典型失败模式、诊断方法与分层评估策略,帮助团队精准定位 RAG 系统瓶颈并对症优化。
Google的世纪失误:发明TPU与Transformer却输给小团队
Google发明了TPU和ChatGPT背后的Transformer架构,却因战略误判被ZAI、Moonshot AI等小团队反超。本文分析这场AI竞赛中巨头失误的深层原因与行业启示。
从「大肥鱼面试」段子看大模型的能力边界
B站「大肥鱼给用户做面试」段子以拟人化AI「豆宝」的形式,调侃大模型答案不稳定、拟人化命名等特征,并通俗解释了Transformer核心的注意力机制。本文借梗解析大模型能力边界与AI娱乐化传播的两面性。
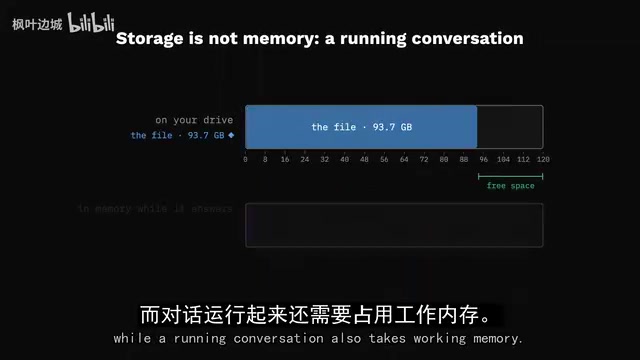
Qwen3 Flash Next本地实测:142 tokens/s的私有编程助手怎么搭
海外博主实测Qwen3 Flash Next本地运行跑出142.6 tokens/s。本文详解从Unsloth安装、编程任务实操到推测解码与MTP多token预测的完整搭建思路,教你打造私有的本地代码修复助手。

一句"不要猜测"让AI幻觉从71%降至20%
一项实验显示,在提示词中加入"Do not guess"(不要猜测)能将AI编造的虚假声明从71%降至20%。本文解析AI幻觉的成因、提示工程的低成本价值,以及对AI评测体系的启示。
SRBench:用大模型自动化系统综述筛选的基准框架
论文提出 SRBench 基准框架,含 4.5 万条标注数据、覆盖 32 项二次研究,专门评估大语言模型在系统综述筛选中的表现,并配套 PromptSR 提示实验工具,解决类别不平衡带来的评估失真问题。
SignTrace:用自然语言描述动作,反向查询手语词汇
SignTrace 是一套面向中文手语词典的自然语言反向检索系统,用户只需描述动作即可找到对应手语词汇。系统整合 LLM 词典增强、七通道检索与候选重排,在基准测试中 Hit@1 达 94.0%,MRR 高达 0.9540。
假评论检测综述:从预训练模型到大语言模型的攻防演进
一篇覆盖211篇文献的假评论检测综述,从信息融合视角梳理了从预训练语言模型到大语言模型的技术演进,分析了多源证据融合、主流基准测试的局限,以及对抗生成、跨域迁移、可解释性等六大开放难题。
冻结BERT中的AI文本检测神经元:稀疏探测与激活修补揭秘
一项arXiv最新研究通过稀疏探测和激活修补,在冻结BERT编码器中定位驱动AI文本检测的关键神经元,发现不到1%的神经元即可支撑检测,并揭示指令微调模型在BERT第12层留下的独特足迹。

大模型真的理解上下文吗?知识图谱评估框架给出新答案
大模型真的理解上下文还是仅靠模式匹配?一项基于知识图谱的评估框架提出 S3KG 混合相似度度量,融合结构与语义信号,在九大基准上 F1 最高提升 7.6 分、AUROC 达 0.973,为 LLM 上下文理解评估提供新工具。
噪声警务音频难题:预训练ASR伪标签方法的机遇与边界
最新 arXiv 论文系统评估伪标签方法在噪声警务音频(BPC)上适配 Whisper、Qwen3-ASR 的效果,揭示内部置信度指标失灵,并提出 LLM-as-a-judge 过滤与跨模型伪标签两大新范式。

AI的快思考与慢思考:元认知如何提升机器推理能力
借鉴卡尼曼《思考,快与慢》的双系统理论,探讨AI的快思考与慢思考模式,以及元认知如何让大语言模型学会评估自身推理、优化算力并减少幻觉。