#开源工具
共 11983 篇相关文章

Vercel AI SDK 发布 @ai-sdk/xai 5.0.6 补丁更新
Vercel AI SDK 发布 @ai-sdk/xai 5.0.6 补丁版本,同步升级 provider 与 provider-utils 依赖。本文解析这次更新内容、xai Provider 在生态中的定位及开发者升级建议。

@ai-sdk/zai 1.0.4 发布:Vercel AI SDK 依赖更新解析
Vercel AI SDK 的 @ai-sdk/zai 发布 1.0.4 补丁版本,同步更新 provider、openai-compatible 等核心依赖。本文解析此次更新内容、依赖关系及对开发者的实际影响。

Vercel AI SDK 发布 @ai-sdk/zai@3.0.16 补丁更新
Vercel AI SDK 发布 @ai-sdk/zai@3.0.16 补丁更新,同步升级 provider、openai-compatible 等底层依赖。本文解析本次更新内容及其对开发者的实际影响。
从素材看:25行Python实现Jev的技术信号
Hacker News 上一条「用25行Python实现Jev」的技术分享,本文基于有限素材分析这类极简代码实现的社区现象,并说明其信息缺口与验证方式。

vLLM v0.30.1rc0发布:新增AMD MI355 NVFP4与MoRI内核支持
vLLM 发布 v0.30.1rc0 候选版本,新增对 AMD MI355 加速卡的 dense NVFP4 量化内核与 MoRI 内核镜像支持,进一步扩展 ROCm 生态下的大模型推理能力。
AI标准之争:为何实验室之外的人应拥有话语权
一条关于AI治理的提议引发热议:AI实验室之外的人应拥有真正话语权,标准应防止权力集中、保护开源竞争,并让各国比较证据、从失败中学习。本文解析这一AI安全标准提议的核心逻辑与现实意义。
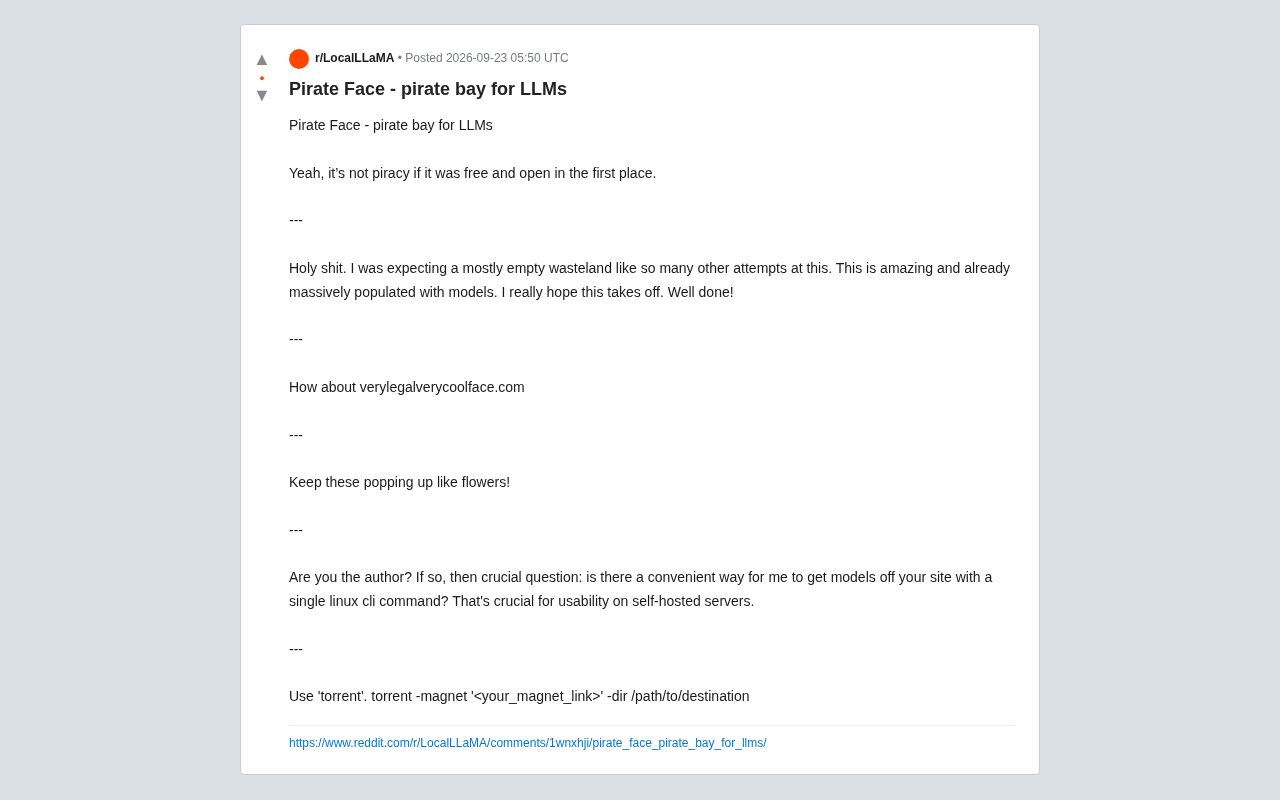
Pirate Face:为开源大模型打造的"海盗湾"式分发平台
Pirate Face 是一个类似海盗湾的开源大模型去中心化分发平台,基于磁力链接和 P2P 技术共享免费开放模型,支持命令行下载,适合自托管部署场景。本文解析其定位、社区反响与技术逻辑。
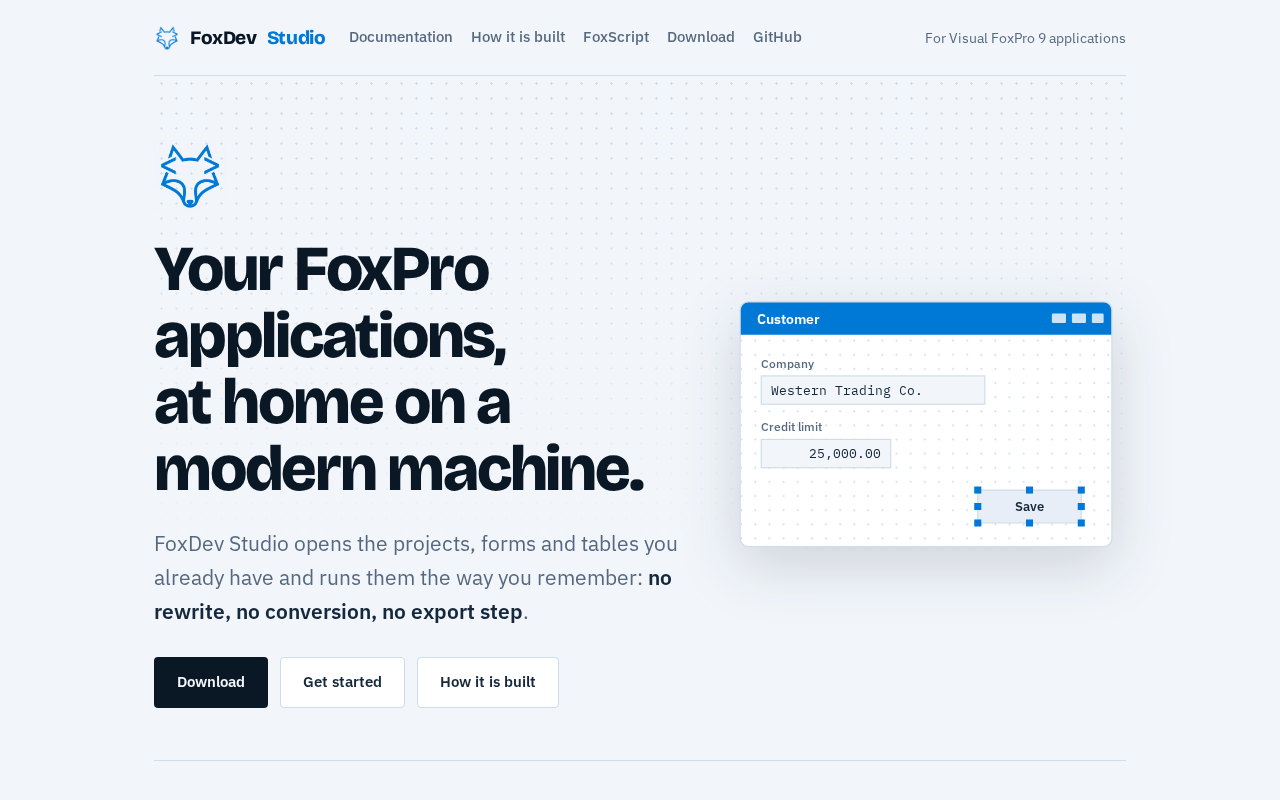
微软已弃用的FoxPro复活:Rust重写编译为WASM
微软2007年已停止更新Visual FoxPro,但一个开源项目用Rust重写运行时并编译为WASM,让这门旧语言复活。它对照原版vfp9.exe校验,突破2GB表限制,兼容旧版32位.fll插件,并新增lambda、JSON和HTTP服务器。
AI安全喧嚣之下,企业真正关心的挑战是什么
在AI安全争论主导舆论的当下,企业真正关心什么?本文解析Anthropic的三轴度量方案、算力权力集中的监管争议,以及企业在网络安全与自有模型上的现实选择。
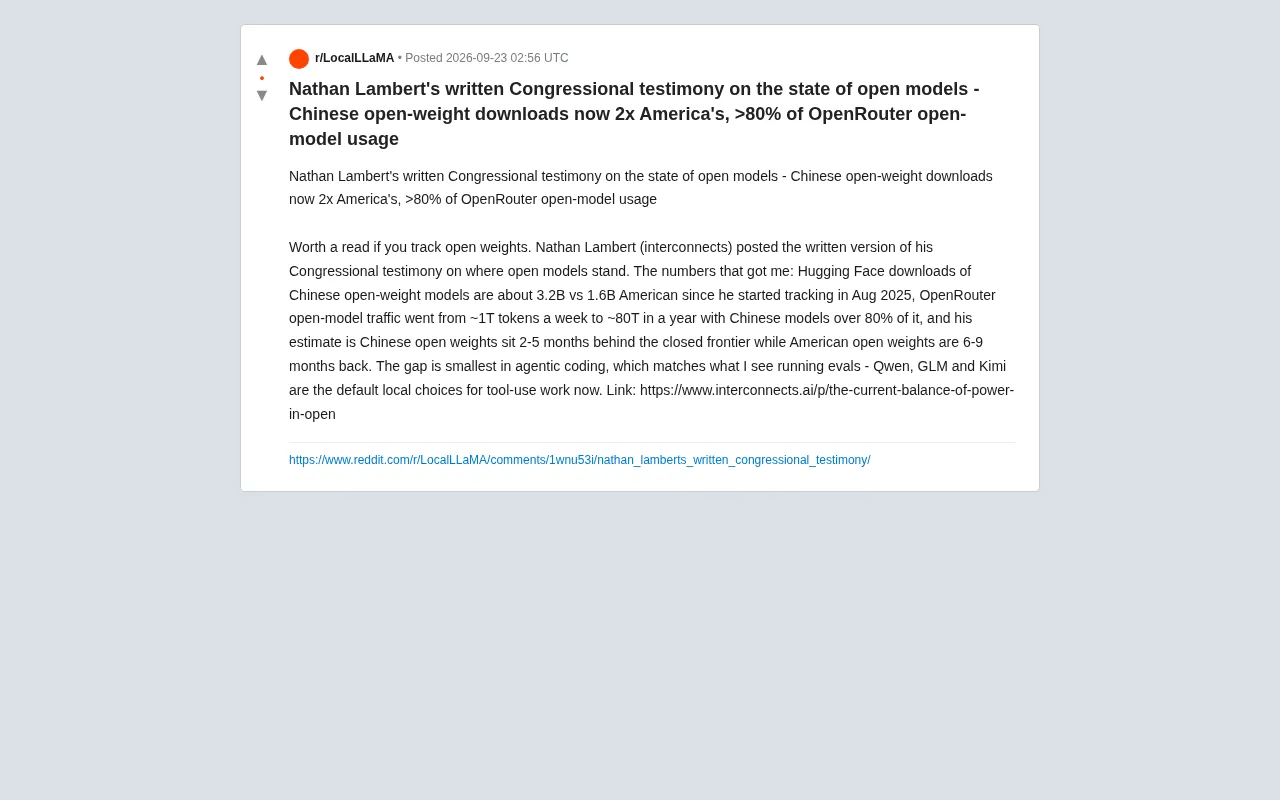
中国开源模型下载量已达美国两倍:解读Lambert国会证词
Nathan Lambert提交国会的开源模型证词显示:中国开源权重模型下载量已达美国两倍,OpenRouter开源流量占比超80%,技术滞后差距全面领先美国开源阵营,智能体编程领域Qwen、GLM、Kimi成默认选择。
OpenWiki 真能提升输出质量吗?一场社区讨论的深度解读
OpenWiki 真能提升输出质量吗?本文围绕一则 Reddit 社区讨论,剖析成本节约与质量提升的区别,并给出评估这类开源知识协作工具的实用方法。
x402协议详解:AI Agent自动付费的真相与被忽视的陷阱
x402协议是复用HTTP 402状态码、让AI Agent按请求用加密货币付费的开放协议。本文拆解其完整支付流程、Cardano与RippleX的生态进展,并揭示TRM Labs数据背后AI占比过低、结算不等于交付两大关键陷阱。
开源权重之争升温:AI监管背后的利益博弈
伊利诺伊州设立AI内阁引发开源AI社区担忧。本文解析开源权重之争的核心矛盾、监管俘获质疑以及闭源API厂商与开源模型间的利益博弈,帮助读者理性看待AI监管走向。
检索片段训练法:406M小模型在会议摘要上媲美1.2B系统
arXiv 新论文提出检索片段训练法,让 406M 参数的会议摘要模型在 QMSum 上媲美 1.2B 系统,参数量仅三分之一、显存不到一半。文章解析其统一评测框架、消融分析与对小模型部署的实践启示。
同量不同答:语言模型的数值表征不变性缺陷
arXiv 最新研究检验语言模型的数值表征不变性:同一数值以小数、分数、科学计数法等不同形式书写时,模型答案是否一致。研究揭示大部分「失败」实为评测器解析缺陷,并发现 Mistral Small 4 在单位换算中存在数量级级别的系统性错误。
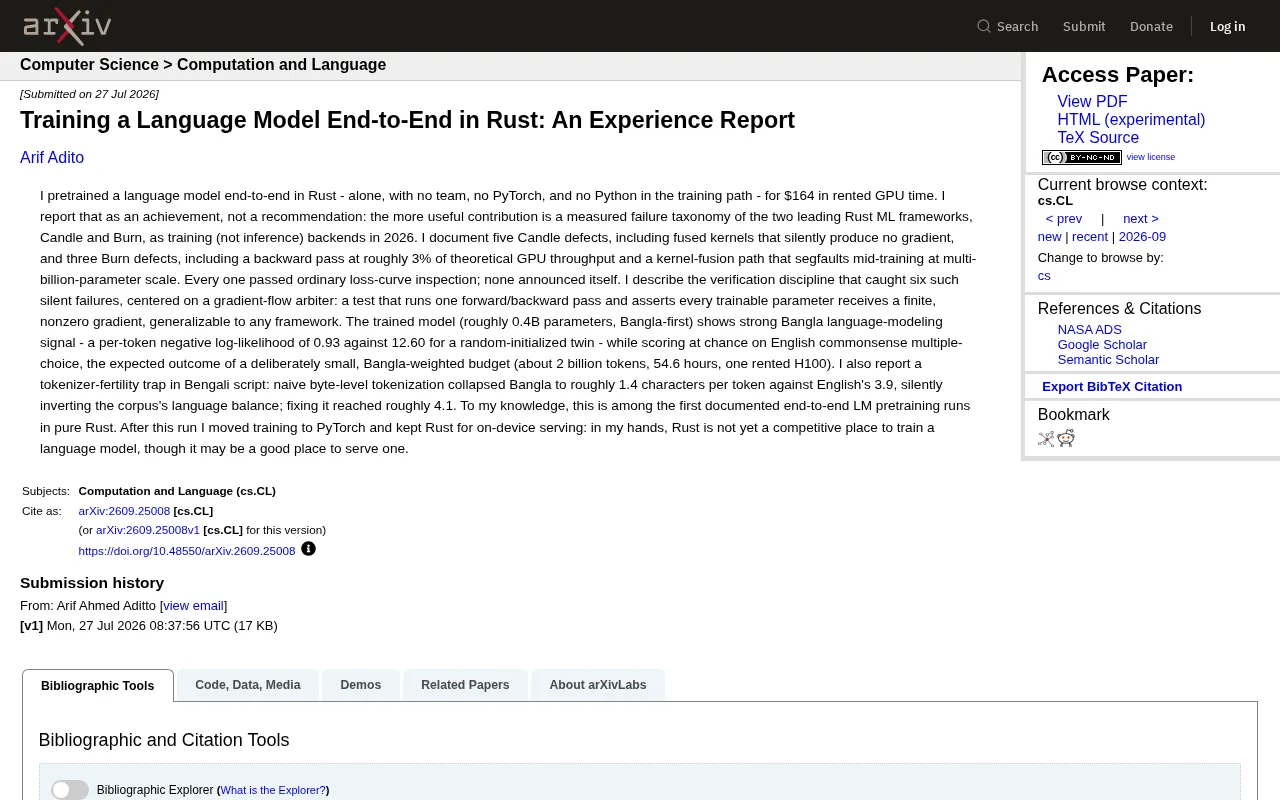
用纯Rust训练语言模型:164美元实验背后的框架陷阱
一位独立研究者仅花164美元,用纯Rust(无PyTorch、无Python)端到端预训练了一个4亿参数的孟加拉语模型。报告详细记录了Candle和Burn框架作为训练后端的多个静默缺陷、梯度流验证方法及孟加拉语分词陷阱。
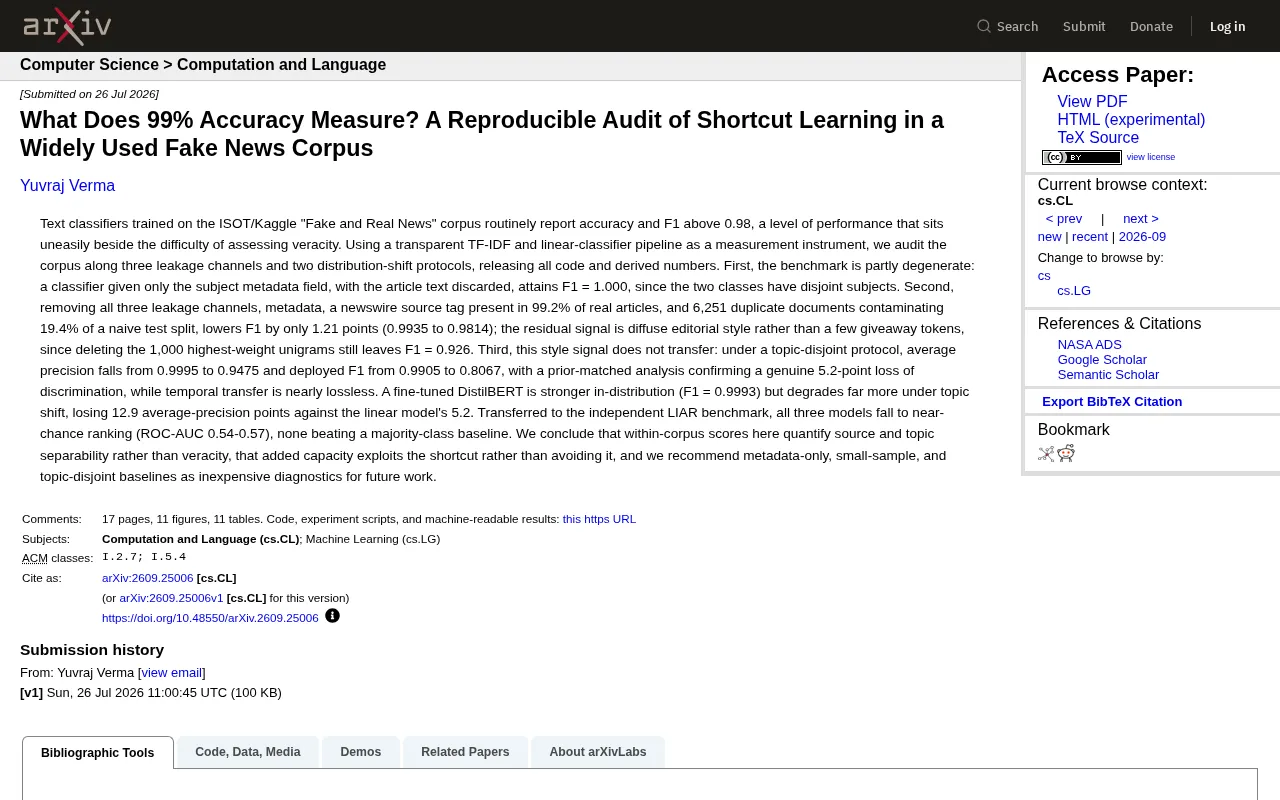
99%准确率的真相:假新闻数据集中的捷径学习审计
一项可复现的审计揭示,广泛使用的假新闻语料库上 99% 的准确率实际测量的是新闻来源与主题的可分性,而非真实性。研究通过泄漏通道分析、主题偏移测试和跨数据集验证,暴露了捷径学习问题。
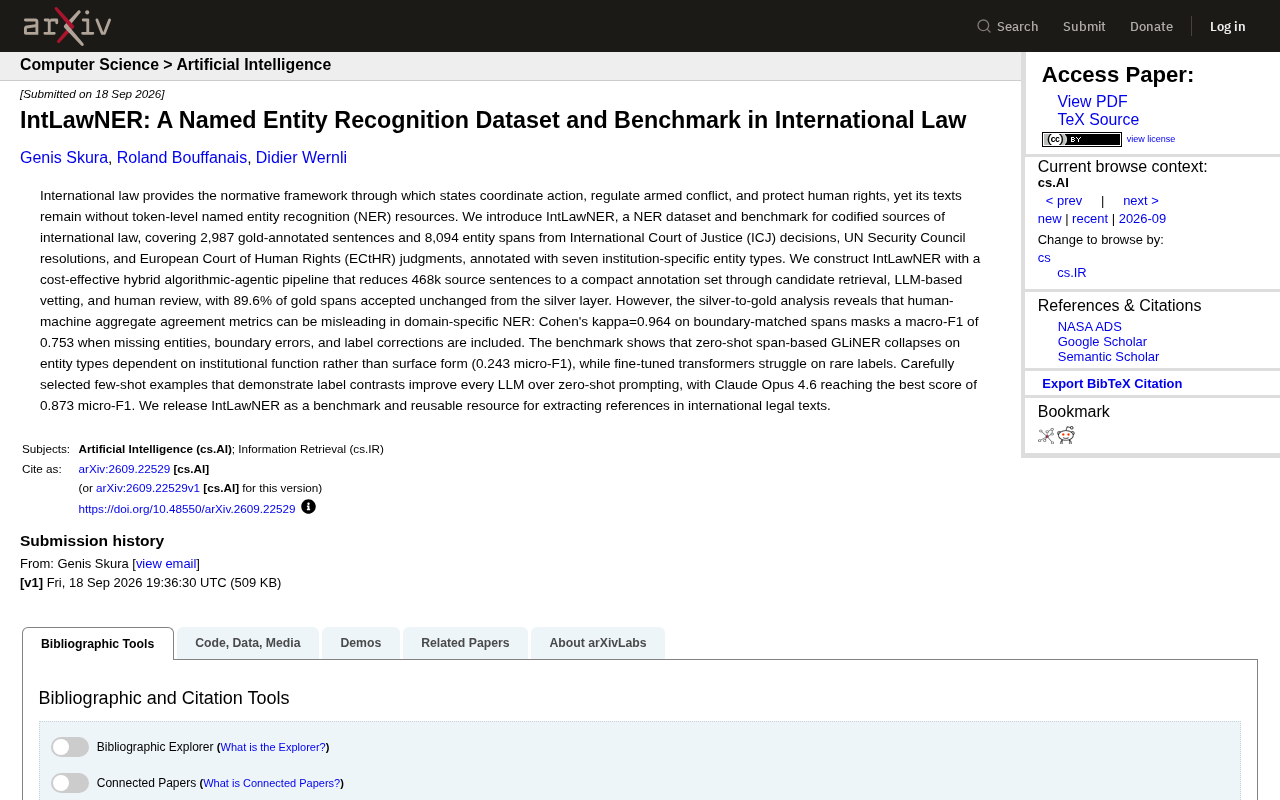
IntLawNER:国际法领域首个命名实体识别数据集与基准
IntLawNER 是首个面向国际法的命名实体识别数据集与基准,涵盖 ICJ、联合国安理会与欧洲人权法院文本,揭示领域 NER 中的评估陷阱,Claude Opus 4.6 取得最佳表现。