#开源工具
共 11852 篇相关文章

LLM直接读写神经网络权重:权重空间编程改写AI研发范式
权重空间编程让LLM直接读写神经网络权重,将自动研究从递归自我改进循环中移除,可编辑Qwen权重减少推理循环;同时涉及DeepSeek超级智能体原型与GDPx基准。

飞机噪音成定位器:OSINT新技术曝光隐私漏洞
研究者Colsto展示了一种OSINT新技术:通过分析视频中微弱的飞机噪音,结合公开的ADS-B航班数据,可精确定位拍摄位置。本文详解其原理、隐私风险与防护方法。

状态空间模型的对角等价:检索秩与选择性扩展新解
深入解读状态空间模型的对角等价分类,分析 MIMO 检索秩设计、HybridMamba 混合架构、H100 GPU 内核训练加速与内存权衡,以及召回实验与语言模型损失的落差。

混合检索+NLI+开源LLM做科学论断验证,融合规则为何反而掉分?
一项科学论断验证实验构建了2035条论断基准,比较混合检索、NLI基线与Llama 3.1、Qwen3、Mistral三个开源LLM。Qwen3的Macro-F1达0.7937领先,而保守的NLI+LLM融合规则反而使性能下降,错误分析显示分歧常导致正确的LLM预测被推翻。
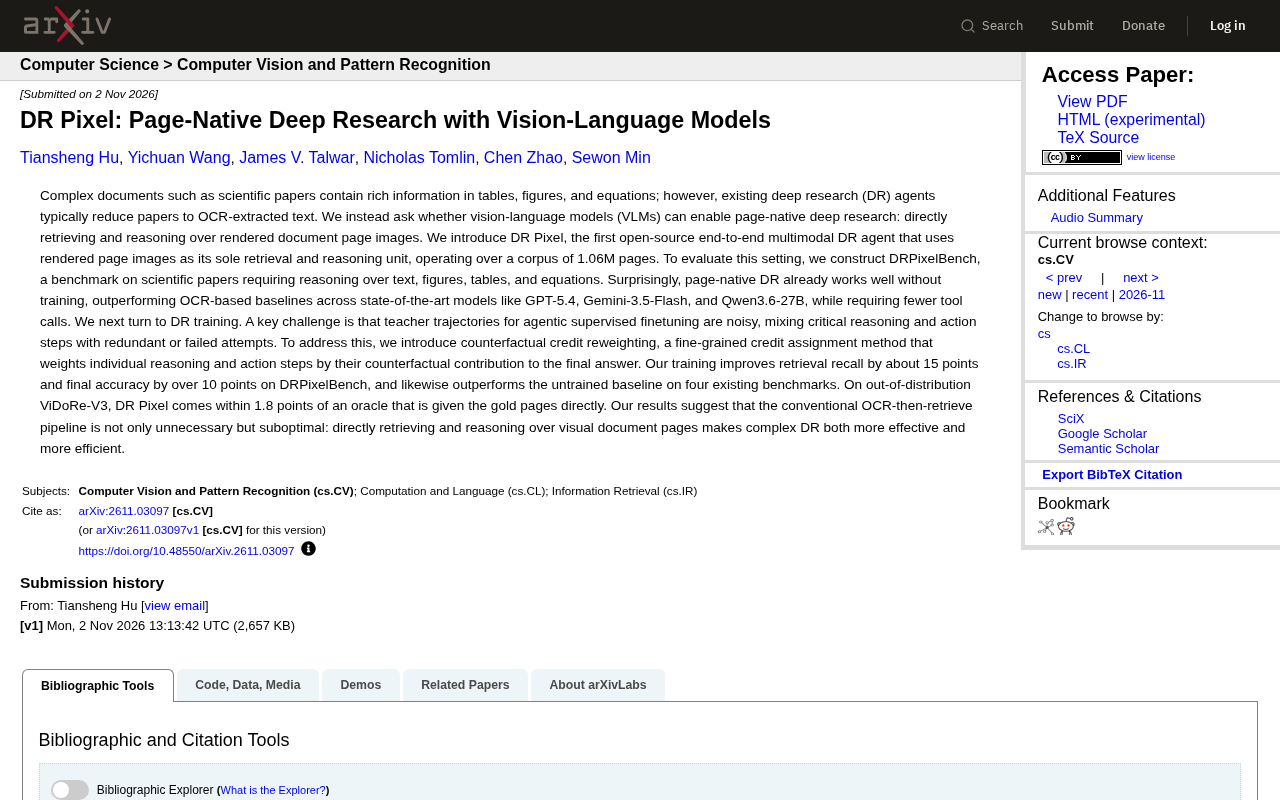
DR Pixel:绕开OCR,让视觉语言模型直接“阅读”页面图像做深度研究
DR Pixel 是首个以页面图像为唯一检索与推理单元的开源多模态深度研究智能体,在106万页语料上运行,零训练即超越OCR基线,并通过反事实信用重加权训练将检索召回提升约15个百分点。

SPTA:让学生前缀教会老师如何指导
SPTA提出两阶段方法:先用RLVR训练老师适应学生生成的前缀,再进行标准OPD。实验表明其在数学推理上优于标准OPD和任务级RLVR老师,解决了教师侧分布错配问题。

DepthGraft:分层KV重建如何成为深度模型的结构正则化利器
DepthGraft提出分层KV共享架构,通过跨层KV重建实现结构正则化,缓解深度模型信息稀释。在16B MoE模型上MMLU-Pro提升7.0%,KV缓存减少约三分之一。
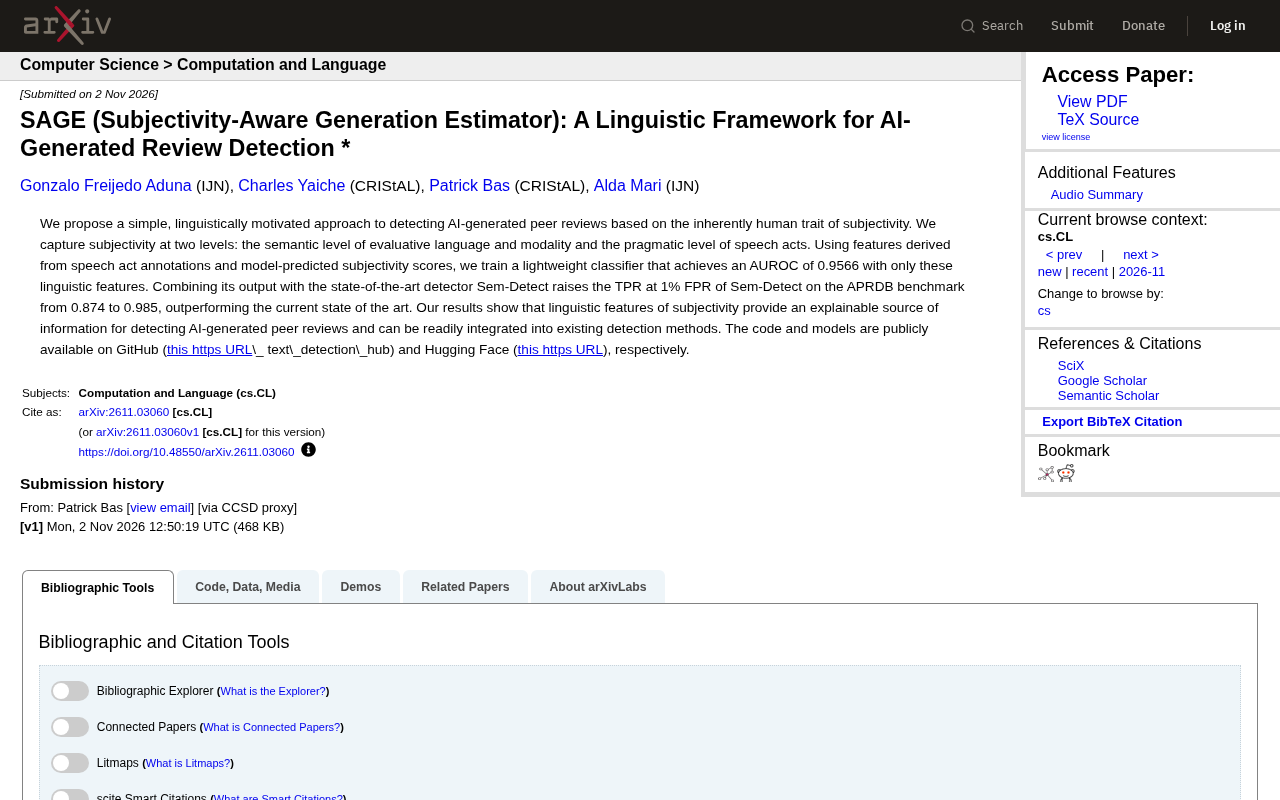
SAGE框架:用主观性语言特征检测AI生成审稿意见
SAGE框架利用主观性语言特征检测AI生成的同行审稿意见,仅用轻量级分类器即达到0.9566 AUROC,与Sem-Detect结合后在APRDB基准上实现1% FPR下TPR 0.985,超越现有最优水平。

floci:免费轻量的AWS本地模拟器新选择
探索floci:一款用Java编写的免费轻量AWS本地模拟器,GitHub获28k星,旨在替代LocalStack。了解其核心特点、适用场景及与LocalStack的对比。

AI+Playwright打造闲鱼监控利器:ai-goofish-monitor解析
GitHub开源项目ai-goofish-monitor基于Playwright与AI实现闲鱼多任务实时/定时监控与智能分析,配备后台管理UI,帮助用户从海量商品中高效筛选心仪产品。本文解析其核心架构、功能特点与适用场景。
从零实现XGBoost回归:5天手写代码,精度媲美sklearn
开发者用5天时间从零实现XGBoost回归算法,精度与sklearn几乎相同但速度稍慢。本文分析实现难点、精度对比及对机器学习学习者的启示。

PARC:面向端侧多模态Agent的并行对齐剪枝与轮次感知上下文复用
PARC研究提出并行对齐结构化剪枝与轮次感知KV缓存复用,解决端侧多模态Agent的核心分区失配与缓存膨胀问题。七核部署下视觉编码器延迟降低11.4%,解码吞吐提升23.8%,精度无回退。

开源大模型背诵圣训全翻车:3万次回答无一对得上原文
一项双语基准测试用3万次回答考察五个开源大模型对六大圣训集的逐字回忆能力,结果显示0%的回答达到词汇与语义双高保真,阿拉伯语表现反而更差。研究主张高风险文本任务必须采用检索增强生成而非参数化记忆。

AVID:首个5T fMRI听觉诱导视觉想象解码基准数据集
AVID是首个面向听觉诱导视觉心理想象解码的5.0特斯拉fMRI训练级数据集,含约67小时九名参与者记录,提供场景级与受控双子集及解耦源图像一致性与语义对齐的标准化评估协议,基线显示当前重建流程仍有限但可保留场景级语义。

BasisKV:低秩KV缓存压缩如何同时优化张量并行通信与关键页路由
BasisKV提出低秩KV缓存压缩新方法:将Value压缩与输出投影绑定以削减张量并行通信,并复用Value潜变量预测Key路由,在8卡张量并行推理下实现最高1.42倍端到端加速。

扩散模型成员推理新方法LoFIT:局部条件拟合检测训练数据
论文提出LoFIT方法,通过分析条件预测偏移中的方向性信号实现扩散模型成员推理。无需梯度,仅前向查询,在四个数据集上优于基线,微调早期即可区分成员。
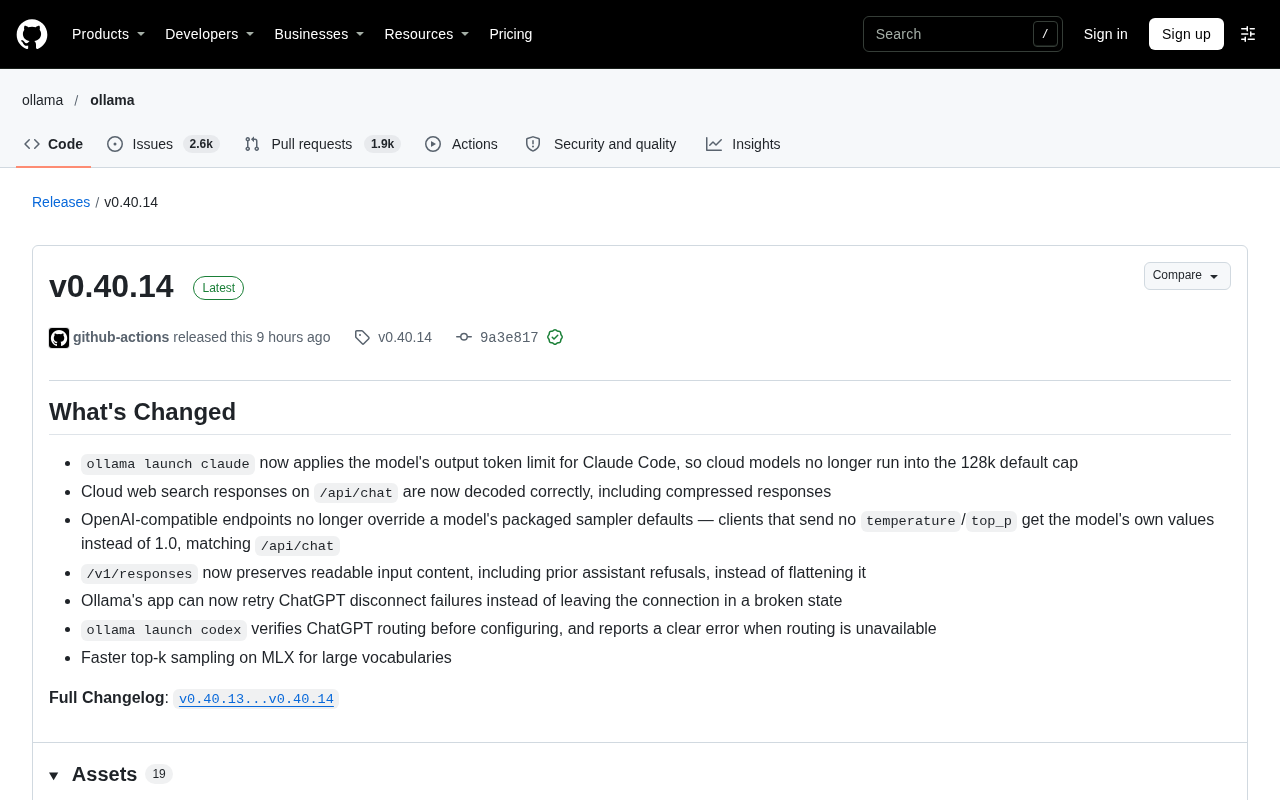
Ollama v0.40.14 更新:修复云模型输出限制与采样默认值
Ollama v0.40.14 发布,修复云模型在 Claude Code 中的 128k 输出上限问题,OpenAI 兼容接口不再覆盖模型采样默认值,并改进 /v1/responses 输入保留与 ChatGPT 连接重试。
LangGraph 集成 VLM:让图像回答更精准的实战思路
介绍如何用 LangGraph 编排 VLM 视觉语言模型处理图像问答,拆解输入解析、视觉提取、生成与校验节点,分析提示词设计、状态管理与重试策略,帮助开发者从图像中获得更稳定准确的回答。

