#强化学习
共 167 篇相关文章
KnowGPO:用知识分组重塑搜索智能体信用分配
KnowGPO提出按智能体已获得的知识条件分组来分配信用,在多轮搜索中超越结果奖励与过程监督基线3.8到4.2个点。本文解析其知识状态表示、架构组件、矛盾数据处理缺口、攻击面与工程落地边界。
单机自博弈强化学习击败《魔兽争霸III》疯狂AI
开发者仅用一台台式机,通过自博弈强化学习训练小模型,成功击败《魔兽争霸III》疯狂AI。Reddit社区热议其完成度与效率,为个人开发者提供新思路。
多智能体强化学习中的交互介导非平稳性挑战
Reddit讨论帖探讨多智能体强化学习中的交互介导非平稳性,分析其来源、传统方法局限及适应策略,包括元学习、分层学习和图神经网络等方向。

4B模型RL训练实测:能否追上27B大模型?
实测用开源RL环境在双DGX Spark上训练Qwen3.5-4B:只训练边缘任务可追回与27B模型超一半差距,但GRPO机制决定收益有天花板,蒸馏加RL组合效果最佳。
共享神经渲染器让AI智能体4轮学会新游戏
AgentGarten 研究显示,共享神经渲染器让视觉强化学习智能体仅需4轮即可学会新游戏,而传统方法需数百万轮。本文解析捉迷藏实验中的策略涌现、效率提升原理,以及视觉保真度与基线对比等局限。
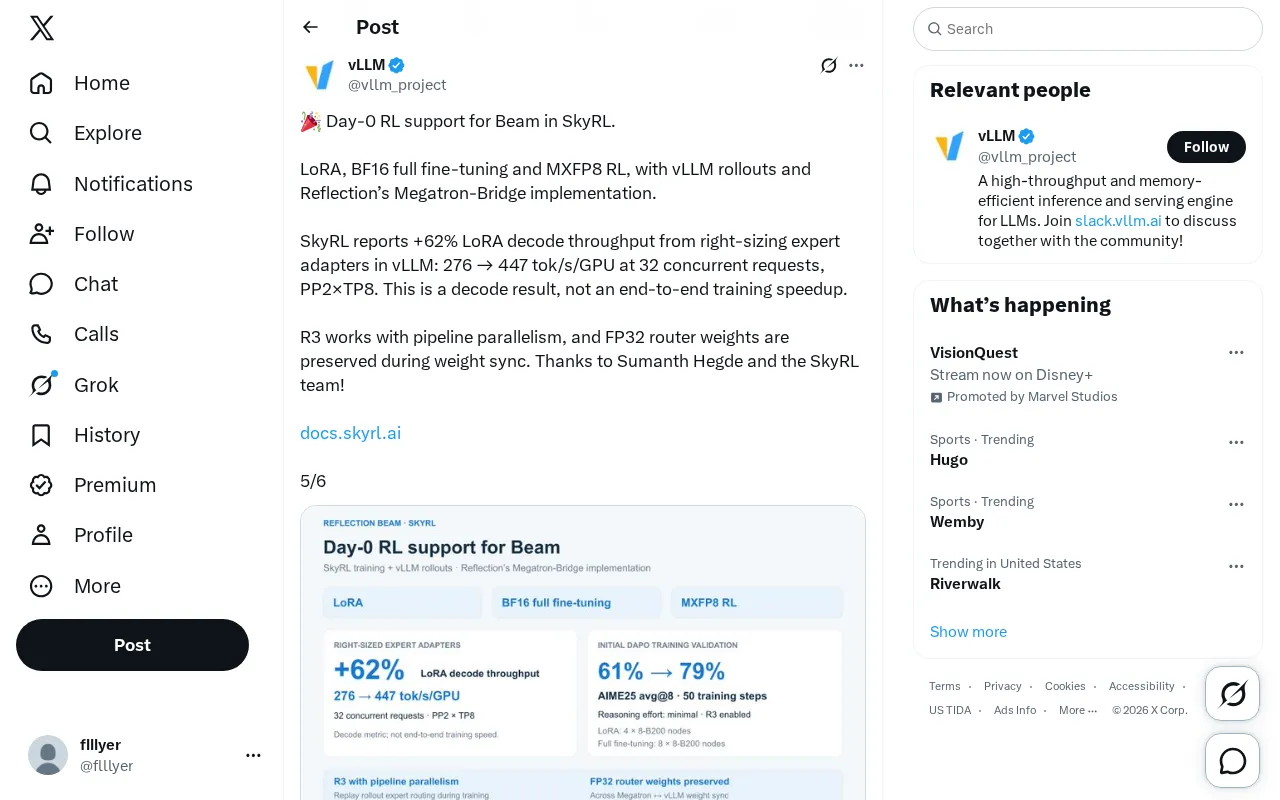
SkyRL实现Beam Day-0强化学习支持,LoRA解码吞吐提升62%
SkyRL 宣布对 Reflection 的 Beam 模型实现 Day-0 强化学习支持,覆盖 LoRA、BF16 全量微调与 MXFP8 RL,结合 vLLM rollout 和 Megatron-Bridge,LoRA 解码吞吐提升 62% 至 447 tok/s/GPU。
混合智能体通关暗黑破坏神I:钢铁侠模式抵达第9层
混合AI智能体在暗黑破坏神I钢铁侠模式下抵达地下城第9层。项目采用算法+强化学习混合架构,包含CNN+LSTM注意力机制、装备评分公式和奖励塑形迭代,开发者分享了完整的技术实现与当前瓶颈。
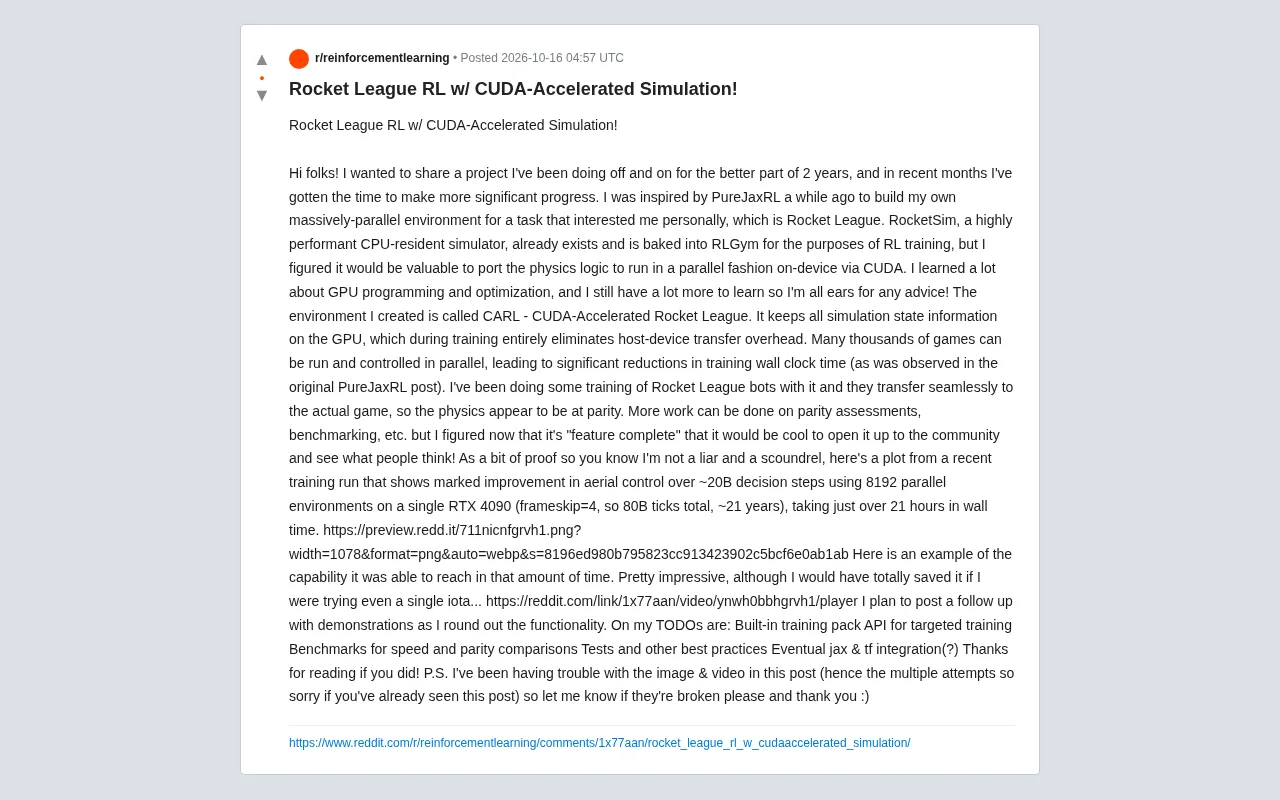
CUDA加速的火箭联盟RL模拟器:单卡RTX 4090训练20B步
开发者用CUDA将火箭联盟物理模拟搬到GPU,实现CARL并行环境,单张RTX 4090上8192环境并行训练,21小时跑完20B决策步,机器人可无缝迁移到真实游戏。

让LLM智能体不再跑偏:全新Steering Agent监督框架
论文提出Steering Agent监督框架,通过快慢双路径与强化学习联合训练,解决LLM智能体与多智能体系统在长程任务中的目标漂移问题,并验证其跨任务泛化与可控干预频率。
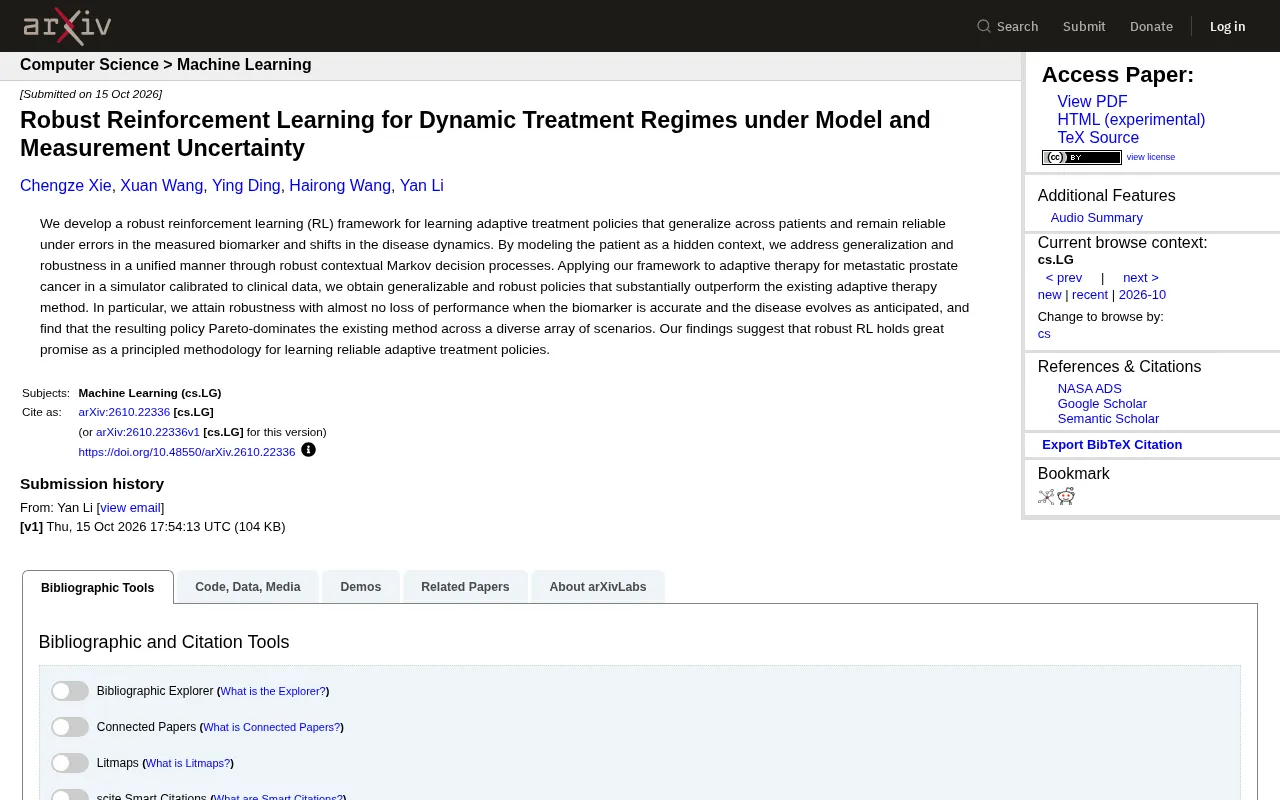
鲁棒强化学习破解动态治疗方案不确定性难题
研究者提出鲁棒强化学习框架,通过鲁棒上下文MDP统一处理动态治疗方案中的模型与测量不确定性,在前列腺癌模拟器上帕累托支配现有方法,且几乎不损失性能。
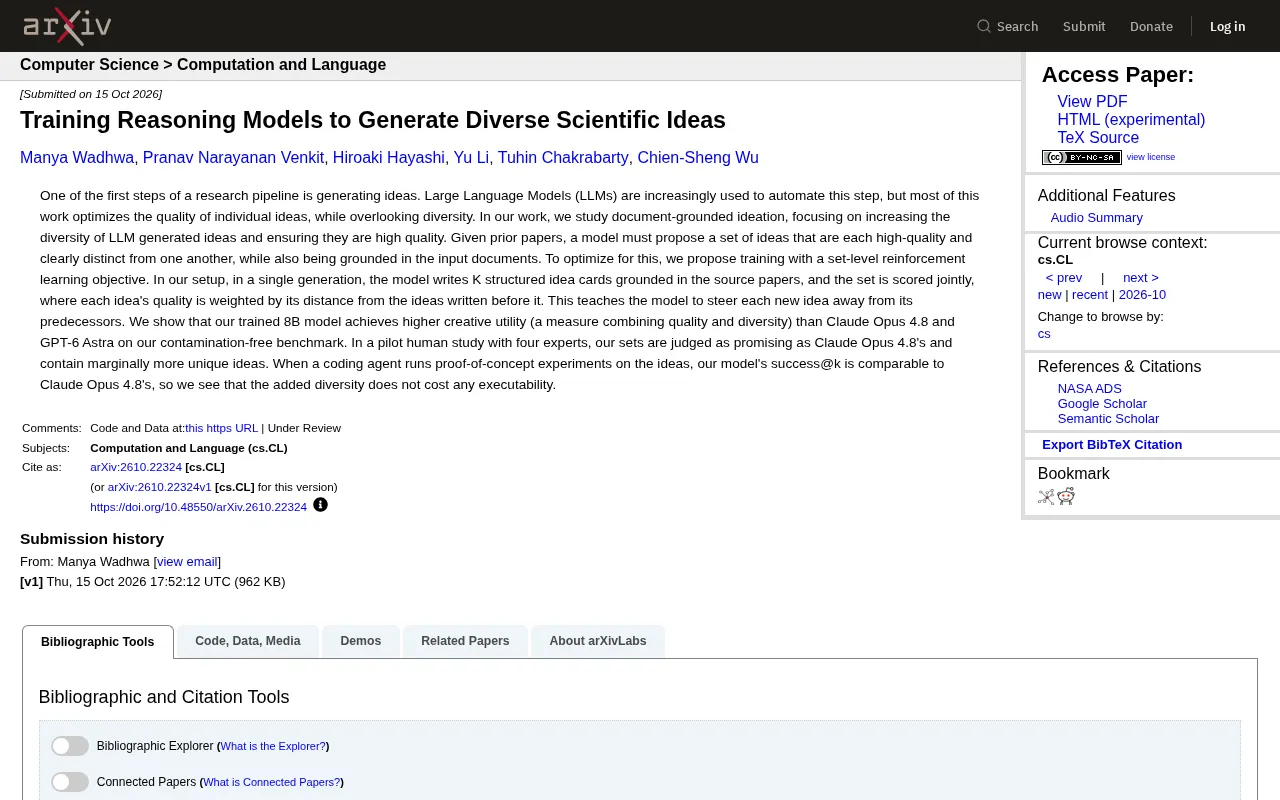
用集合级强化学习训练LLM生成多样化科研想法
一篇新论文提出用集合级强化学习训练LLM生成多样化科研想法,通过让每个新想法远离前文来提升多样性。8B模型在创意效用上超过Claude Opus 4.8和GPT-6 Astra,且不牺牲可执行性。
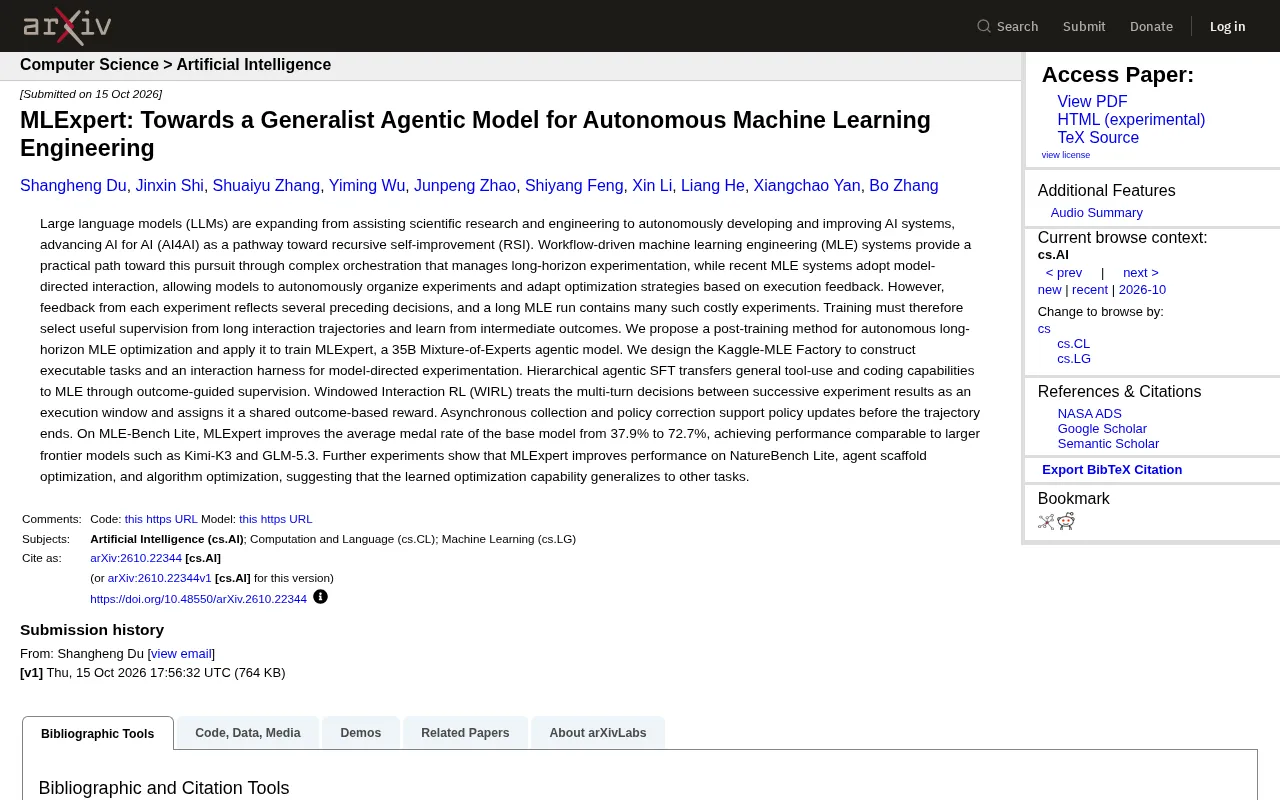
MLExpert:35B智能体模型让机器学习工程自主化
MLExpert是一种35B混合专家智能体模型,通过分层SFT和窗口化交互强化学习WIRL,在MLE-Bench Lite上将奖牌率从37.9%提升至72.7%,探索AI4AI自主机器学习工程路径。
用PPO智能体让AI跑《神庙逃亡》:手机端实测最远16782米
开发者用PPO强化学习智能体玩《神庙逃亡》,通过Frida直接读取游戏内存并调用游戏方法操作,自建C++无头模拟器6分钟训练1000万步,真机14次实测中位数4736米、最远16782米,GitHub已开源。
用PPO智能体打造模拟器,手机版神庙逃亡被AI攻克
Reddit开发者用PPO强化学习智能体构建手机模拟器,成功攻克《神庙逃亡》。本文拆解其技术链路:视觉输入、策略推理、动作映射与奖励反馈,分析PPO在实时跑酷游戏中的适用性与工程挑战。
稀疏奖励只是借口:Agent评估的真正瓶颈是作者成本
长周期Agent评估只能用稀疏奖励?本文分析为何密集评分的真正瓶颈是作者成本而非计算成本,并介绍Tev提出的从世界规格渲染环境、让进展作为副产品自动产生的方法。
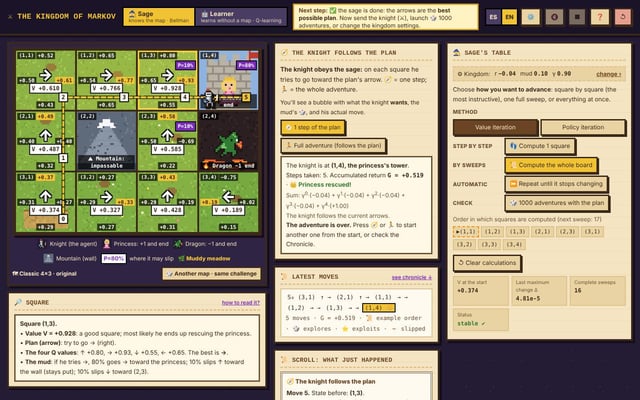
像素风MDP模拟器:交互式学习强化学习核心算法
Markov Kingdom 是一个像素风交互式 MDP 模拟器,帮助学习马尔可夫决策过程与强化学习核心算法,包括 Bellman 方程、价值迭代、策略迭代、Q-learning 和 SARSA,完全免费开源。
MFG:多轮反馈引导的分子优化新框架
MFG框架通过强化学习训练LLM利用多轮反馈进行多目标分子优化,在GeLLM³O上实现81.50%相似性约束成功率,为AI辅助药物设计提供新思路。
复制不等于落地:ASC 破解长文 RAG 的忠实度奖励漏洞
新研究揭示长文 RAG 的忠实度奖励会被"复制"行为钻空子,模型靠粘贴原文拉高分数而非真正落地。论文提出 Authored-Sentence Credit(ASC),将奖励从答案级下放到句子级,在四个模型、五个语料上同时降低错误率并提升支持句数量,且回答质量不输基座模型。