#强化学习
共 167 篇相关文章
 前沿研究
·5 分钟
Cursor Composer 2分布式RL训练技术解析
深度解析Cursor如何通过分布式强化学习训练Composer 2模型,涵盖异步流水线设计、MoE数值对齐、全球权重同步、在线离线RL协同等核心技术细节,揭示AI编程工具从应用到基础模型的转型路径。
阅读全文 →
 行业洞察
·3 分钟
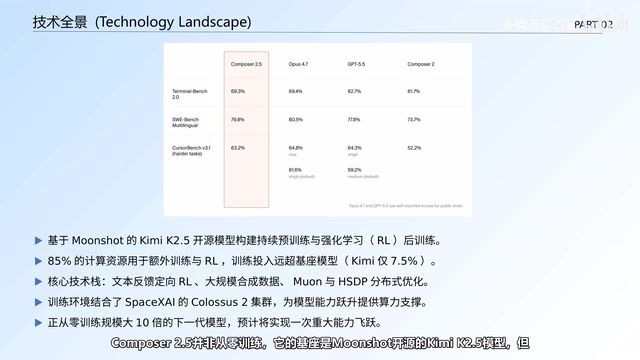
Cursor Composer 2.5深度解析:1/10成本比肩Claude Opus 4.7的编码能力
Cursor自研Composer 2.5模型通过大规模强化学习后训练,以1/10成本实现与Claude Opus 4.7、GPT 5.5比肩的编码能力。本文深度解析其文本反馈强化学习、合成数据生成等核心技术创新及Benchmark实测数据。
阅读全文 →
 行业洞察
·3 分钟
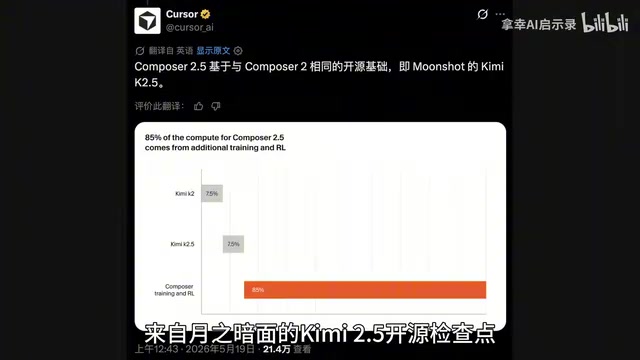
Cursor Composer 2.5深度解析:开源模型1/10成本叫板Claude 4.7
Cursor发布Composer 2.5,基于开源模型Kimi K2.5实现与Claude 4.7 Opus持平的编程能力,成本仅为十分之一。深度解析三大技术突破、AI自主学会逆向工程的安全隐患,以及与SpaceX AI百万H100算力合作的战略布局。
阅读全文 →
 深度解读
·5 分钟
DeepSeek V3.2深度解读:DSA稀疏注意力、强化学习与Agent三大突破
深度解析DeepSeek V3.2与V3.2 Special两款新模型,详解DSA稀疏注意力机制如何加速长文本处理、强化学习计算量达预训练10%、1800种环境的Agent任务合成流水线,附实测体验与GPT-5、Gemini 3.0 Pro对比。
阅读全文 →
 深度解读
·8 分钟
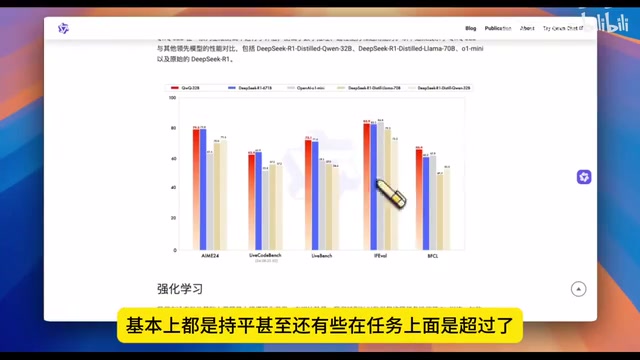
阿里QwQ-32B开源:32B参数如何媲美671B的DeepSeek R1
阿里开源推理模型QwQ-32B仅用32B参数,在多项基准测试中媲美甚至超越DeepSeek R1满血版(671B)。本文深度解析其两阶段强化学习训练策略、性能对比数据,以及强化学习带来的能力涌现现象,揭示小参数模型以小博大的核心秘密。
阅读全文 →
 深度解读
·8 分钟
强化学习驱动AI推理进化:从模仿者到真正的思考者
深入解析强化学习(RL)、自我博弈(Self-Play)和验证机如何协同驱动大语言模型推理能力进化,帮助AI从模仿人类逻辑的SFT阶段跃迁到具备自主深度推理的System 2思维模式。
阅读全文 →
