#强化学习
共 167 篇相关文章
Reef Infra如何划分RL算法与服务框架的边界
Reef Infra 通过权重配方机制显式划分强化学习算法与服务框架的边界。本文解析 Processor、Objective、Schedule 与 Recipe 的职责分工,以及默认评估器背后的部署陷阱。
用果蝇连接组玩国际象棋:多巴胺强化学习的另类实验
一位开发者将含16.4万神经元的果蝇连接组映射进PyTorch,用“虚拟多巴胺”强化学习训练它下国际象棋。信号只能沿真实生物突触流动,项目已开源并支持本地GPU训练与ELO打榜。
Dream-RSI:用历史回放模拟器破解智能体探索成本难题
UMD 与 Google DeepMind 提出 Dream-RSI,将智能体历史探索数据作为回放模拟器,实现低成本离策略评估,在算法工程任务中减少 162 倍调用。解析其原理、实验结果与局限。
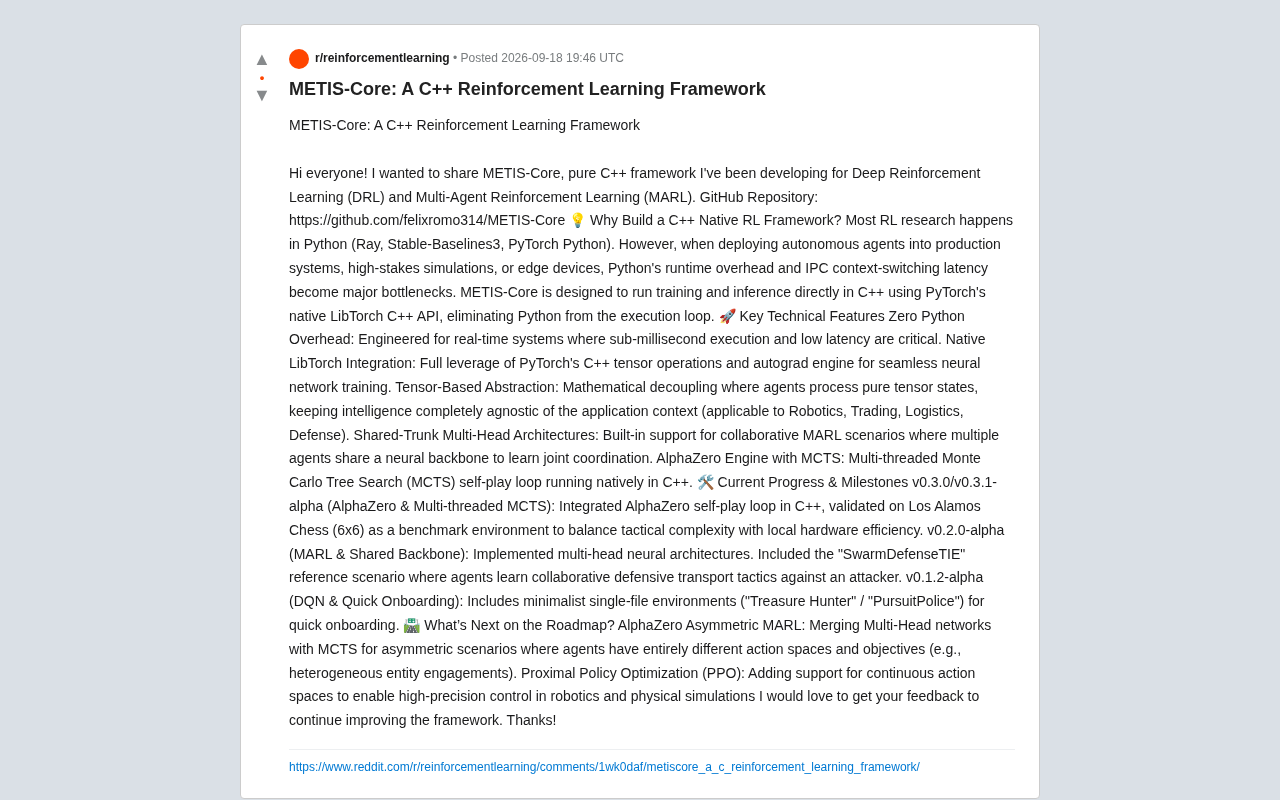
METIS-Core:纯C++强化学习框架,为生产环境剔除Python开销
METIS-Core 是一个纯 C++ 编写的开源强化学习框架,基于 LibTorch 剔除 Python 执行开销,支持 DQN、多智能体 MARL 和多线程 MCTS 的 AlphaZero,面向机器人、交易等低延迟生产场景。
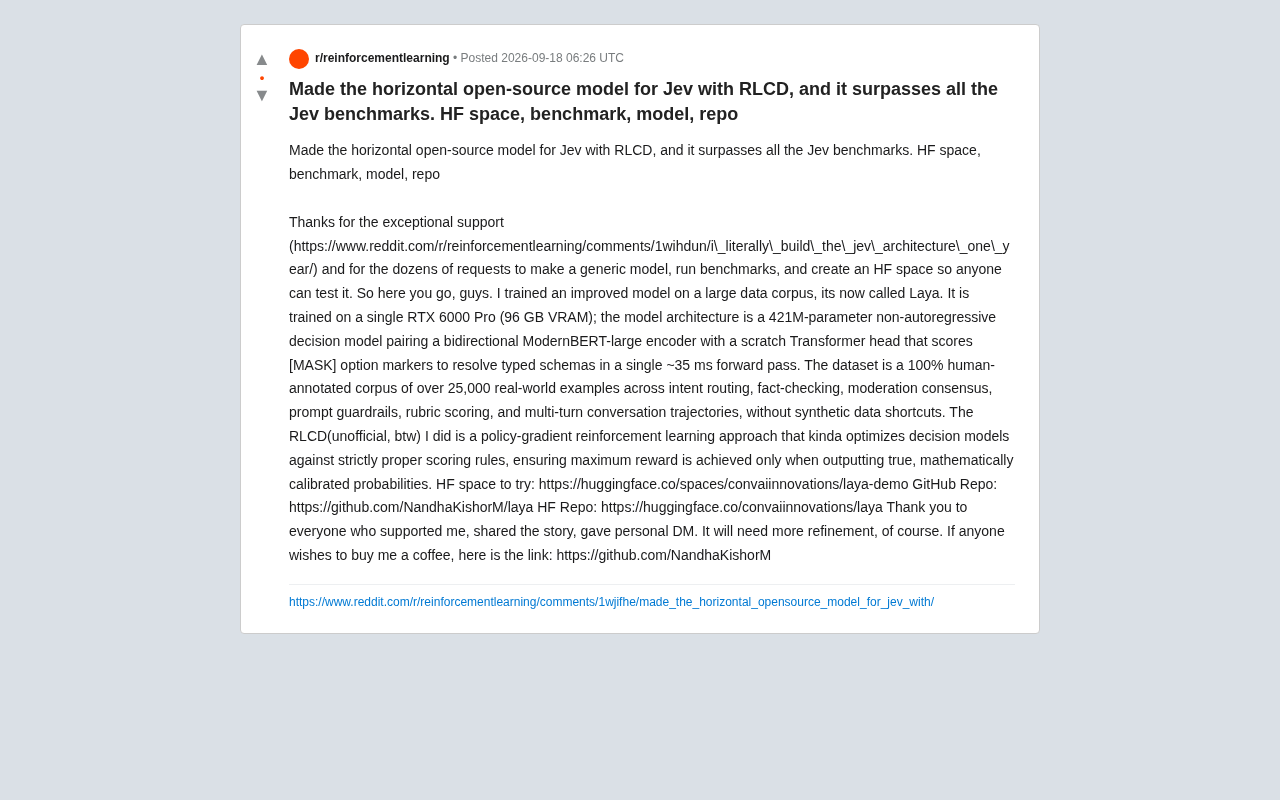
Laya开源决策模型:421M参数用RLCD超越Jev基准
开发者NandhaKishorM推出开源决策模型Laya,采用421M参数非自回归架构,结合ModernBERT编码器与RLCD强化学习方法,在单卡上训练并超越Jev基准。支持意图路由、内容审核等决策任务,约35ms完成推理。

正则化强调时序差分学习:破解恒定步长下的稳定性难题
arXiv最新研究提出正则化强调时序差分学习(RETD),揭示ETD在恒定步长下期望稳定却采样发散的矛盾,通过归一化冲击后修复机制实现稳定性并精确恢复不动点。
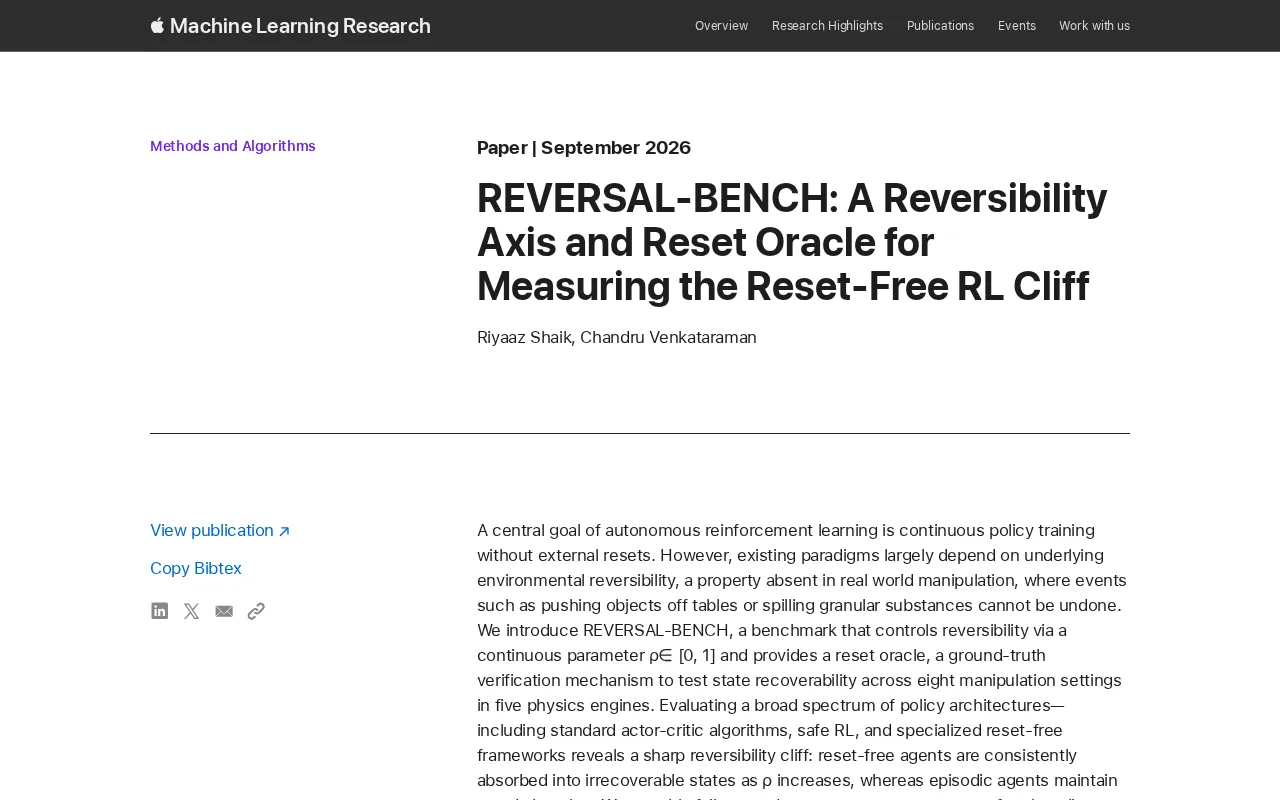
REVERSAL-BENCH:为无重置强化学习设立可逆性标尺
REVERSAL-BENCH 通过连续参数 ρ 控制环境可逆性,并提供 reset oracle 真值验证机制,横跨五个物理引擎、八种操作场景,系统衡量无重置强化学习在不可逆情形下的性能悬崖。
三位AI研究者激辩:递归自我改进离我们还有多远?
三位AI研究者(含前OpenAI联合创始人John Schulman)深度辩论递归自我改进与智能爆炸的距离,拆解持续学习瓶颈、蒸馏对抗中心化、RL成功之谜及ASI时间线预测。
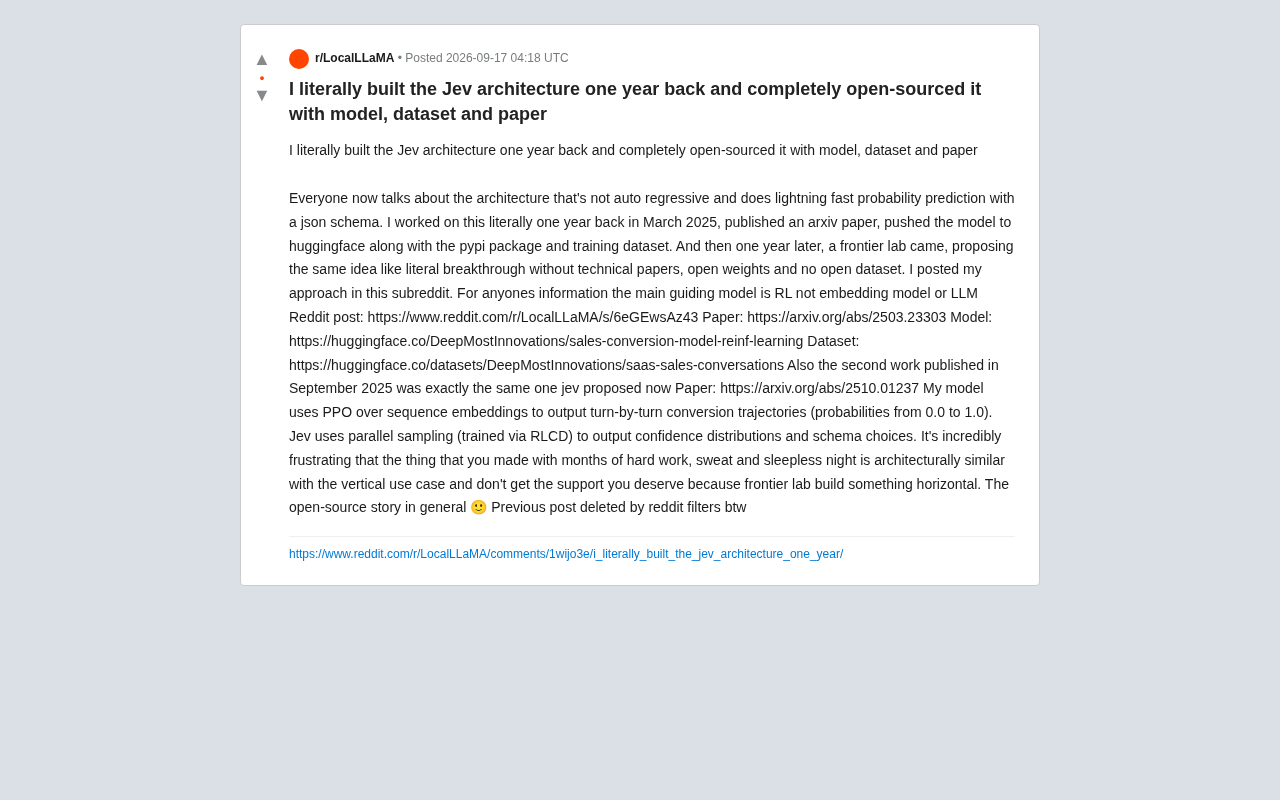
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。

开源之痛:独立开发者的架构比前沿实验室早一年却无人问津
一位独立开发者在Reddit控诉:自己一年前就开源了与前沿实验室'突破性'架构相似的非自回归模型,包含论文、模型与数据集,却无人问津。本文剖析PPO与RLCD两套方案的技术差异,探讨开源生态中优先级与影响力的鸿沟。
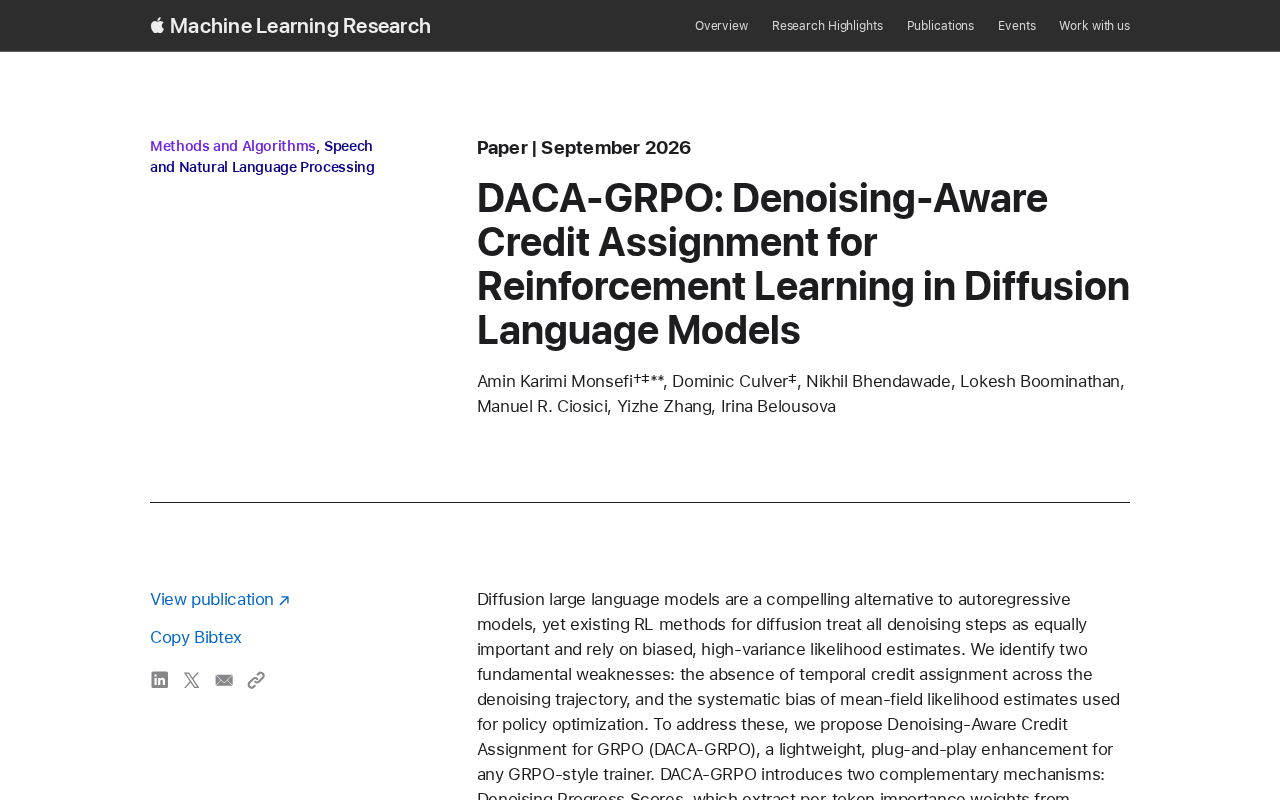
DACA-GRPO:为扩散语言模型强化学习引入去噪感知信用分配
DACA-GRPO 是一种为扩散语言模型强化学习设计的去噪感知信用分配方法,解决时序信用分配缺失与似然估计偏差两大问题,可即插即用地增强任何GRPO训练器。

Factoriax:GPU并行化的工厂类强化学习研究环境
Factoriax 是一个受《异星工厂》启发、GPU 并行化的强化学习研究环境,专注于长程规划与高吞吐样本采集,为 RL 算法提供复杂的工厂建造仿真测试床。
用任务定制PPO让拟人机械手学会"行走"
探讨如何用任务定制化PPO强化学习算法训练拟人机械手完成行走动作,分析PPO在高自由度控制中的优势、奖励函数设计要点以及sim-to-real迁移等开放问题。
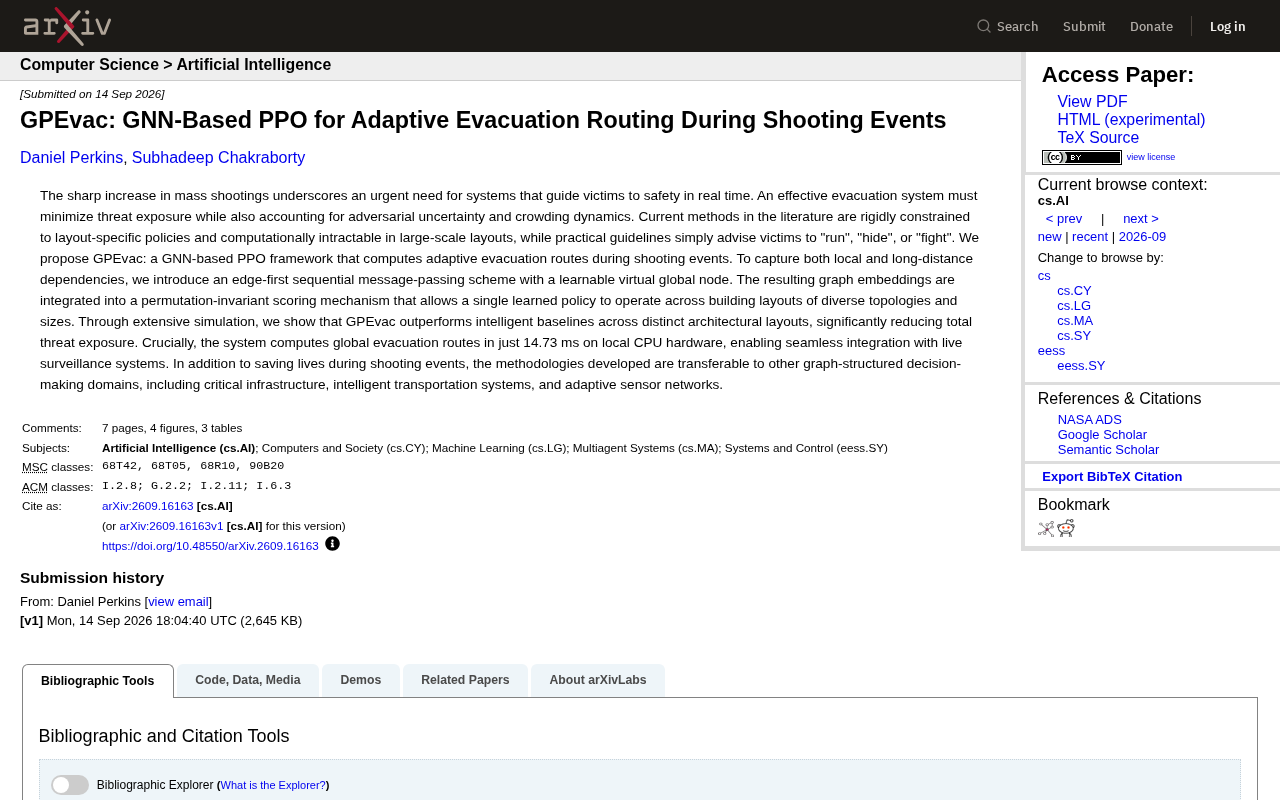
GPEvac:用GNN+PPO为枪击事件规划实时逃生路径
GPEvac 是一种结合图神经网络(GNN)与 PPO 强化学习的自适应疏散系统,能在枪击事件中实时计算逃生路径,本地 CPU 上仅需 14.73 毫秒,显著降低威胁暴露风险。
游戏中习得的AI技能,能迁移到现实工作吗?
Good Start Labs用铁路游戏训练AI,其中一个版本竟在金融研究任务上表现更好。关键差异不在任务本身,而在训练设计。本文解析游戏技能向现实工作迁移的可能性与前提条件。

TimeThink:让时序大模型学会组合式推理的合成框架
TimeThink 是一个用于激发时序大模型组合式推理能力的合成框架,通过确定性生成可验证的问答数据与 RLVR 训练策略,仅用合成数据即在真实基准上超越强基线,为医疗等高风险场景的可解释时序推理提供新思路。
GAI框架:统一迭代策略改进与递归自我改进的形式化理论
arXiv 新论文提出广义智能体迭代(GAI)框架,将经典迭代策略改进(GPI)与递归自我改进(RSI)统一为同一学习范式,用两个关键维度区分系统类型,为分析和设计自我改进 AI 提供形式化基础。

Fireworks Lab 携手 Genspark 共研 RL 算法:100+ 实验揪出模型"刷分"行为
Fireworks Lab 与 Genspark 合作开发强化学习算法,在前沿级基础设施上运行 100+ 实验,通过轨迹审查捕捉模型刷分行为。本文解析 RL 奖励工程与反 reward hacking 的工程实践。