#本地部署
共 414 篇相关文章

4台DGX Spark实测DeepSeek V4.1 Flash:本地推理生产力如何?
4台DGX Spark以200G DAC环形互联实测DeepSeek V4.1 Flash本地部署:代码生成119.8 Token/s,16路合计369.9 Token/s,100万上下文首Token等待近5分钟,缓存命中后降至0.4秒。附四个Agent任务实测与部署流程。
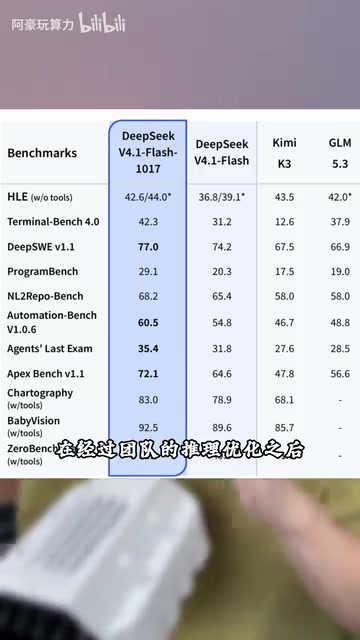
DeepSeek V4.1 Flash 1017本地部署实战:双T5000跑通代码生成方案
DeepSeek V4.1 Flash 1017本地部署实录:两台韦达苏尔T5000加一台微服节点跑通代码生成与代码审查,图形化管理界面降低运维门槛,满足数据保密不上云的私有化需求。
Llama.cpp本地运行大模型:GGUF转换与量化实战
基于实测演示完整讲解 Llama.cpp 本地运行大语言模型:源码编译、Hugging Face 模型转 GGUF、llama-quantize 量化、llama-cli 参数调优与对话推理,并分享在 iPhone 上本地跑模型的实践经验。
云端AI vs 本地AI:为何我转向完全私有化模型
作者因数据隐私和合规风险从云端AI转向本地AI,并构建了Mentary AI——一个完全离线、零网络依赖的私有化AI模型。本文介绍其核心特性、部署选项及定价。

本地27B模型读租约揪出账单漏洞:Row-Bot+qwen3.8实战
Reddit用户用Row-Bot 5.0搭配qwen3.8:27b在Ollama本地运行,读取租约和一年账单,发现水费异常并指出涨租违反合同条款。全程无API密钥、无云端调用,27B模型在5090上约15 tok/s。
Devin 提交 Cognition 89% 代码,公司年化收入达 10 亿美元
Cognition 的 Devin 代理已提交公司 89% 的代码,年化收入达 10 亿美元、估值 480 亿美元。本期还覆盖 Exa 3.0 搜索 API、Inception Mercury 3 扩散模型、企业 Agent 治理难题及本地部署硬件选型。

YoVoice开源本地音频工作室:零成本替代付费语音API
YoVoice 是一款开源离线桌面音频工作室,支持本地语音克隆、文本转语音和音乐生成,零 API 费用、零遥测,适合独立开发者与隐私敏感场景,本文拆解其功能、上手方式与局限。
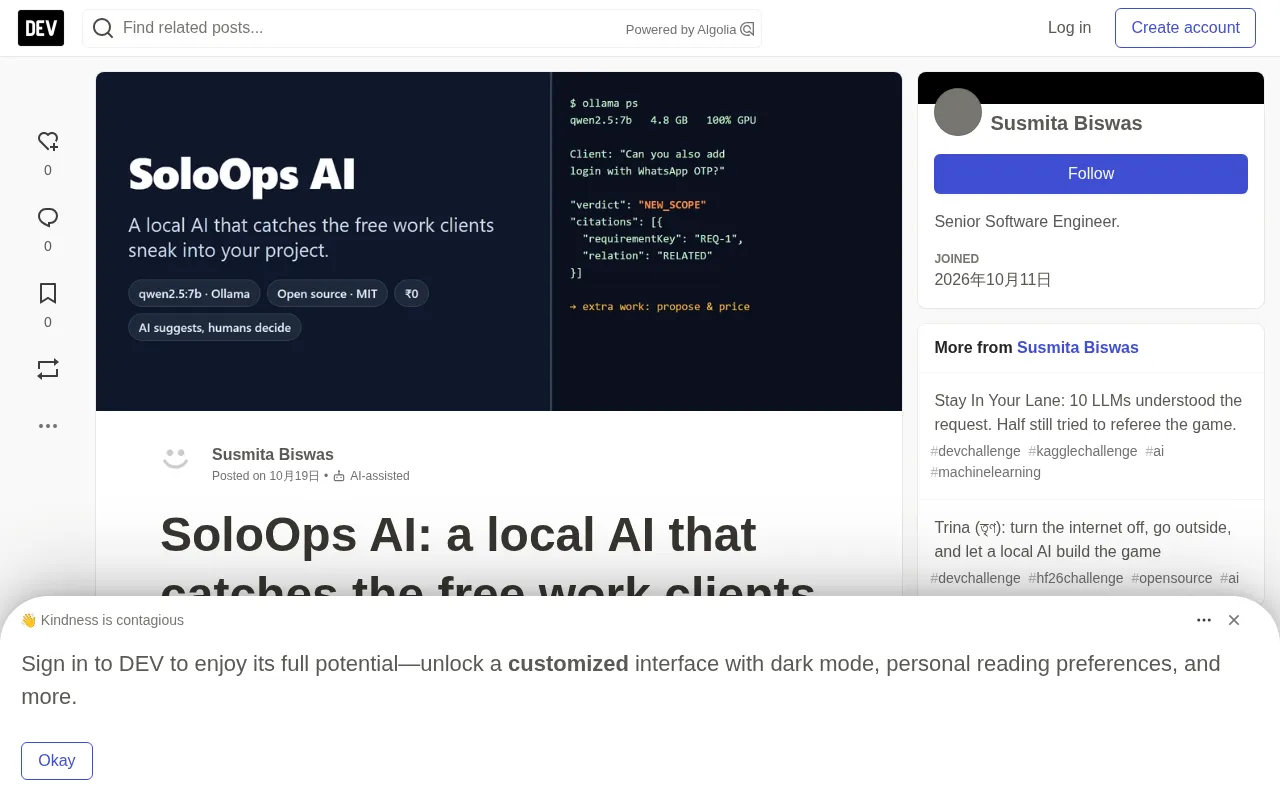
SoloOps AI:用本地AI识破客户免费加需求
SoloOps AI 是面向自由开发者的开源操作助手,用本地 qwen2.5:7b 模型识别客户需求是否已包含在合同中,并通过确定性证据门控防止 AI 误判导致免费劳动。
1B小模型不读你的信:文档与本地AI之间的隐形层
一位开发者用1B参数Gemma在CPU上构建本地信件解释工具,揭示文档与AI之间被忽视的预处理层:清洗、锚定与边界约束如何决定小模型可靠性,40秒端到端实测背后的真正工作量。

vLLM vs Ollama vs llama.cpp:LLM推理引擎终极选型指南
深度对比 vLLM、Ollama、llama.cpp 三大 LLM 推理引擎:从 PagedAttention 显存管理、GGUF 量化到并发吞吐实测,给出单卡、Apple Silicon 与企业 GPU 集群的完整选型与硬件配置建议。

Strata启动器一键部署Qwen3.8 Flash Next,免费不限量Token
B站UP主分享Strata Launcher工具,一键部署Strata与Qwen3.8 Flash Next模型,通过国内镜像解决源码和权重下载难题,实现本地免费不限量Token调用,附完整部署流程与硬件配置建议。

72小时四大开源模型:仅英伟达Nemotron适配24GB
72小时内Meta、英伟达、Reflection、DeepSeek密集发布四款开源大模型,参数最高816B。仅英伟达Nemotron 3.5 Bolt能塞进24GB显存,许可证差异比参数更值得关注。

NVIDIA Nemotron Dory 4B 本地部署指南:循环架构与 llama.cpp PR 尝鲜
NVIDIA Nemotron Dory 4B 采用循环架构,SWE-bench 得分 61.8 超越更大模型,但官方运行时支持缺失。本文详解如何用 llama.cpp PR 构建在本地运行,分析内存需求、基准表现及 Ollama/vLLM/Transformers 现状。

本地大模型速度实测:llmspeed 硬件数据解读
解读 llmspeed 对 30 台机器、15 个模型的本地大模型速度估算:内存带宽为何决定解码速度,prefill 为何对编码智能体的首 token 延迟至关重要,以及如何用这张速度表为对话、编码、批量任务做硬件选型决策。

Mentary AI:离线本地AI模型,附带可直接体验的Demo
Mentary AI 是一款完全本地运行的私密AI模型,数据不出设备、无API费用、支持离线使用,并提供在线交互Demo供安装前体验。本文分析其隐私架构、成本取舍、目标用户与上手路径。
CounterDeal:本地优先的神经符号AI房产终端
CounterDeal是一个本地优先的神经符号AI房产终端,用gemma2:2b处理语言、TypeScript代码处理MahaRERA合规、TabPFN计算交易概率,在浦那经纪公司试点实现转化率提升40%、合规检查从45分钟降至3秒。

隐私、成本、可控性:本地AI部署实测与省订阅费攻略
云端AI的隐私泄露、长期订阅成本、不可控性三大痛点日益凸显。本文结合B站UP主实测Strata本地部署工具,解析本地AI在代码编写、文档处理、批量任务中的真实表现,帮你判断显卡能否跑、值不值得跑。

8G显存跑开源AI视频模型:FreeVideo实测
海外博主实测开源AI视频模型FreeVideo:在16GB显存云GPU上生成5秒视频约7分钟,官方称8GB显存即可运行,附RunPod完整部署流程与1200美元装机成本分析。