#AI编程
共 9366 篇相关文章
MCP 是什么?让 AI 接入所有工具的开放标准
MCP(Model Context Protocol)是让 AI 应用统一接入各类工具的开放标准。本文解析 MCP 的 Host、Server、Client 三角色,Tools、Resources、Prompts 三构建块,一次工具调用的完整链路,以及在 n8n 中的双向用法与安全风险。
MCP图解:AI Agent如何连接你的应用
MCP图解:AI Agent如何连接你的应用
从电商客服机器人场景出发,图解MCP(Model Context Protocol)如何解决AI应用与外部工具的M×N集成困境,对比REST API直连的缺陷,解析Tools/Resources/Prompts三大原语、Host-Client-Server三层架构、stdio与streamable HTTP传输,以及认证授权、凭证管理与prompt injection防护要点。
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
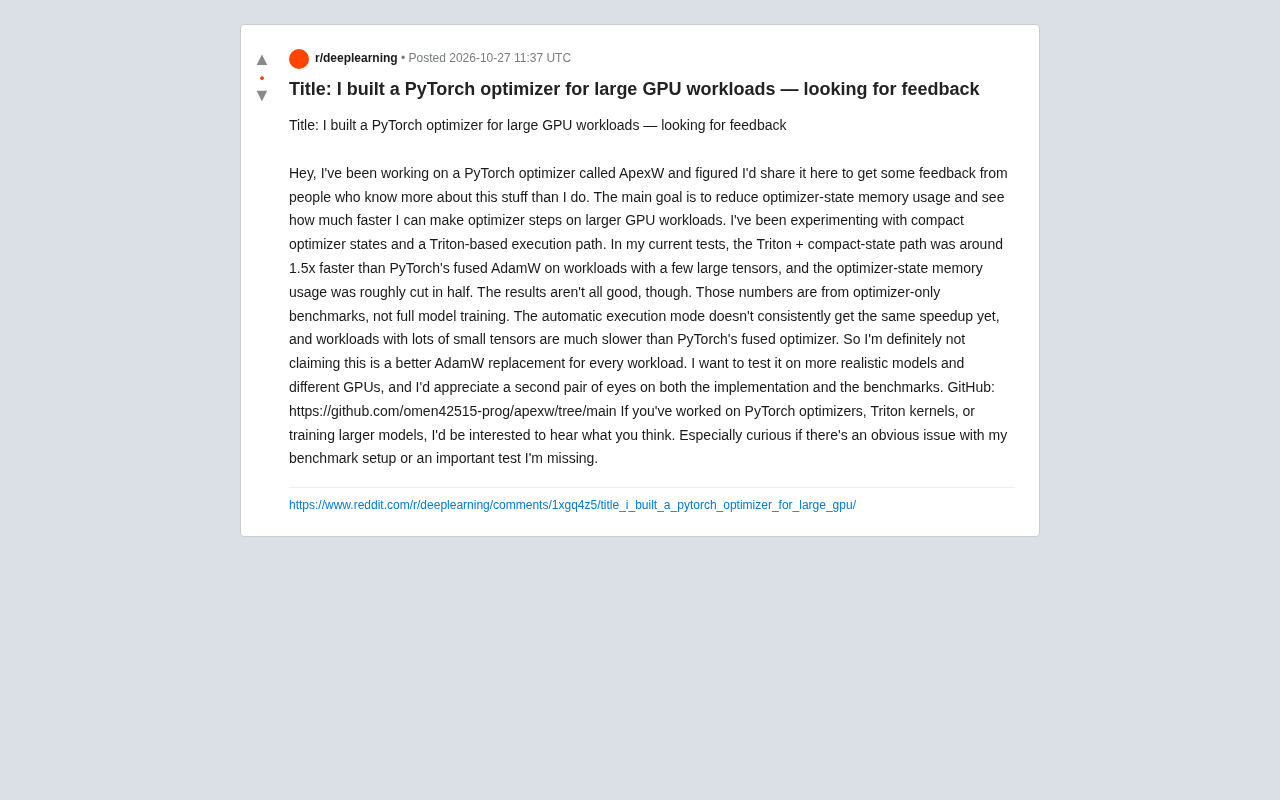
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。

B站最全AI大模型应用开发课:认知决定成败
B站《AI大模型应用开发》课程第一课精华:为什么学大模型要先改变认知?解析AGI时间表、AI产品制造者能力模型、大模型落地现状与技术选型,核心心法是“把AI当人看”。

Gemini API CLI:给AI Agent的多模态工具,但小心账单
Gemini API CLI 是 Google 为编码 Agent 推出的命令行工具,支持图像、视频、音乐和字幕生成。工具免费但模型收费,视频约每秒 10 美分,Agent 可自主花钱,开发者需设计预算控制。

CrewAI多智能体开发实战:从入门到API服务封装
基于B站实战教程,系统讲解CrewAI多智能体开发全流程:Agent/Task/Process核心概念、Anaconda与One API/Ollama环境搭建、官方案例跑通、FastAPI封装对外API服务,并对比GPT-4o mini、千问Max与Llama 3.1的实际效果差异。
免费Agentic编程工具实战:让Java Web开发效率翻倍
Vodden agentic编程工具包完全免费,包含MCP文档服务器、Skills规范库、Agent Tools确定性检查和DevLoop构建验证闭环。实测显示全套工具可让AI编码代理通过基准测试,耗时减少约30%,token减少约20%。本文拆解各组件功能、实测数据与安装方式。

REVA:单次前向传播实现实时漏洞检测,速度提升250倍
REVA提出一种实时漏洞检测新方法:通过预计算威胁模型、静态分析与调用图注入上下文,并用探针读取LLM内部表示,在PrimeVul上达到60.0%准确率,与agent式检测器VulTriage持平,速度却快250倍以上。

AI能直接产出结果,学习还有意义吗?
Reddit热议:AI能直接产出结果,学习还值得吗?本文从判断力、提问质量、纠错能力三个角度分析,指出学习重心正从记忆技法转向理解原理,会用AI的人分两种——把AI当答案机还是当陪练。

AI时代的人月神话:布鲁克斯法则还成立吗
AI编码助手时代,布鲁克斯的人月神话还成立吗?Hacker News讨论揭示:AI提升个体产出效率,但团队沟通成本和代码审查瓶颈并未消失。本文分析布鲁克斯法则在AI时代的变与不变,并给出团队管理建议。
RAG还有未来吗?AI工程师的5年技能规划
从Reddit社区讨论出发,分析RAG技术的未来走向、LangChain等框架的定位,以及AI工程师在未来5-6年应重点积累的检索、评估、系统设计等保值技能,为入门者提供务实的职业规划参考。

“AI技能”在2026年真的一文不值吗?
Hacker News 讨论帖提出“AI技能在2026年一文不值”,本文拆解这一命题:操作层技能正被工具迭代抹平,但系统集成与判断力反而更稀缺,笼统唱衰缺乏解释力。

从零学强化学习:一份实战笔记与开源实现分享
一位开发者分享从零学习强化学习(RL)的笔记系列,首篇1页RL基础已上线,涵盖核心术语与数学直觉,后续将发布从零实现和实验。适合RL初学者参考的学习路线与资源。
用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

选择性平局学习:偏好优化中伪相关的新解法
本文介绍Selective Tie Learning:通过理论分析选择影响最大的平局数据,以更少数据减少偏好优化中的伪相关,实验覆盖对数线性策略、神经网络和大型语言模型,并探讨其实际应用与局限。
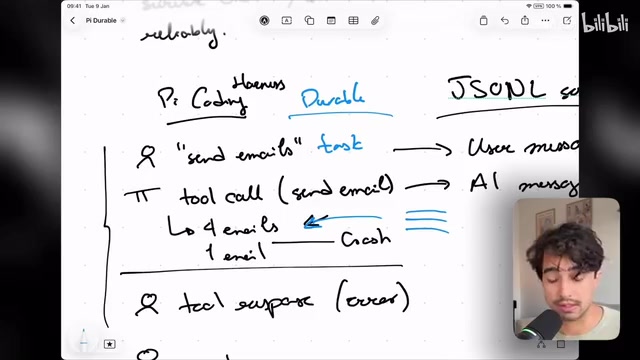
Pi Durable详解:为始终在线Agent构建持久化运行框架
深入解析Pi Durable智能体运行框架:如何通过检查点和SQLite持久化让Agent在崩溃后自动恢复,与Pi Coding Agent的核心差异,Harness层架构定位,以及用本地小模型搭建始终在线智能体的完整实战演示。