#DeepSeek
共 344 篇相关文章

DeepSeek成"蓝色大肥鱼":AI人格反差为何走红
推特X热贴称西方大模型输出带"阴郁感",唯独DeepSeek像"蓝色大肥鱼"。本文解析这一梗的起源、西方模型紧绷感的成因,以及AI人格化反差走红背后的产品启示。

让DeepSeek自己操作浏览器给形象投票,结果出乎意料
B站UP主让DeepSeek自己操作浏览器给官方形象投票,AI不仅完成了投票还给出了自己的解释。这场趣味实验展示了AI Agent操作能力与产品人格化趋势,一起看看DeepSeek会怎么选。

DeepSeek Harness开源:一切皆插件的Agent框架实战入门
DeepSeek Harness(DSH)开源Agent框架实战入门:一条npx命令即可安装,主打「一切皆插件」的架构理念,支持DeepAgent与Skill编排,本文梳理其安装方式、设计思路与五大核心要点。

DeepSeek Orb开源:把Harness改成悬浮球,一键接管电脑
B站UP主基于DeepSeek V4.1魔改官方开源Harness,做出悬浮球形态的桌面agent「DeepSeek Orb」,支持一键唤起、接管鼠标键盘操作电脑,并采用双轨agent架构让后台干活、前台待命。项目已在GitHub开源,支持Windows和Mac。
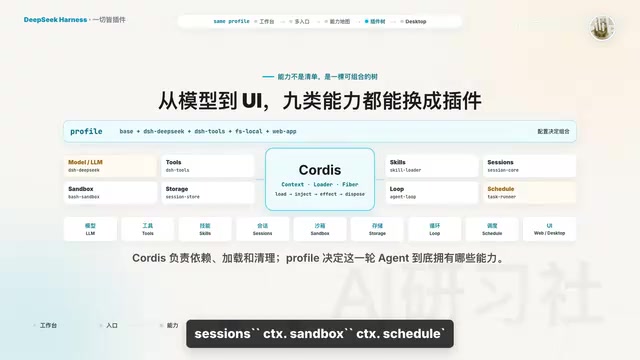
DeepSeek Harness 深度解析:Agent 运行时与插件开发指南
深度解析 DeepSeek Harness 开源 agent 运行时:agent=model+harness 架构、Cordis 插件生命周期、如何手写工具插件,以及 Electron 桌面版 v0.1.7-rc.2 的更新与安全边界。

用DeepSeek+Python Turtle库间接生成图片:一次有趣的实验
DeepSeek 本身不能生成图片,但通过让它编写 Python Turtle 库的绘图代码,就能间接「画」出图案。本文解析这一实验的思路、实现方法与效果局限,并探讨其背后的模型工具调用理念。
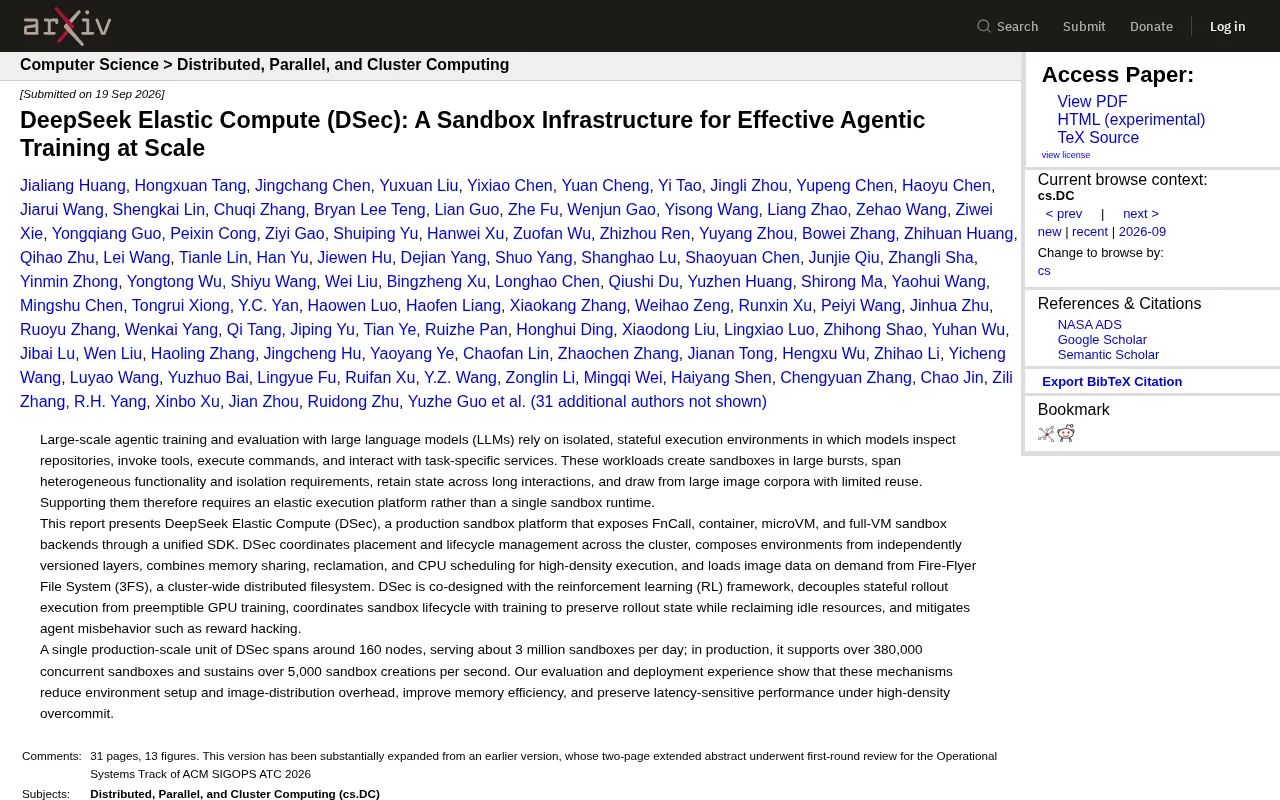
DeepSeek Elastic Compute (DSec)登陆Hacker News热榜
DeepSeek Elastic Compute (DSec)论文登上Hacker News热榜,获186点赞。本文梳理该弹性算力方案的话题背景、行业意义与关注焦点,探讨大模型算力效率优化趋势。

DeepSeek Browser Use实测:AI自主充值并开发票
B站UP主实测 DeepSeek Browser Use,一款让 DeepSeek 模型自主操作浏览器的开源中间件。实录展示AI完成账号充值10元和自动开发票全过程,涵盖服务启动、登录、扫码支付、表单填写等环节。
从DeepSeek看基模创业:颠覆式创新为何独立发生?
对话栾宇深度解析DeepSeek等基础模型创业的成功逻辑:为何颠覆式创新独立发生、懂技术的领导者为何关键、战略定力与决绝投入如何决定成败。

海外工程师实测五大开源模型:DeepSeek Flash封神,GLM Flash夺冠
海外工程师基于真实agentic工作流实测五大开源模型:Kimi K3、DeepSeek Pro、GLM 5.3、DeepSeek 401 Flash与GLM 5.3 Flash。DeepSeek Flash基准超Opus 5,GLM Flash夺冠,附跨实验室混搭实战技巧。
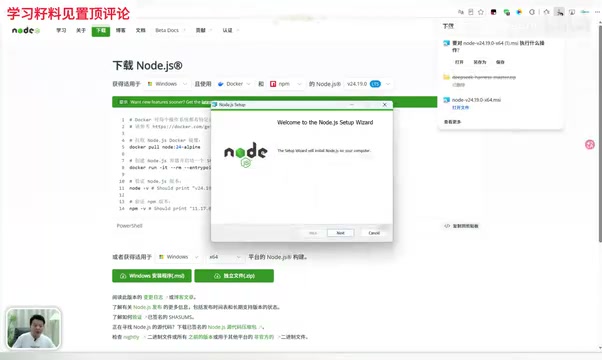
DeepSeek Harness入门:Node.js环境配置与环境变量设置详解
DeepSeek Harness零基础安装教程:详解Node.js环境安装、npm验证、环境变量配置全过程,教你把插件包挡在C盘之外,为大模型办公自动化打好基础。
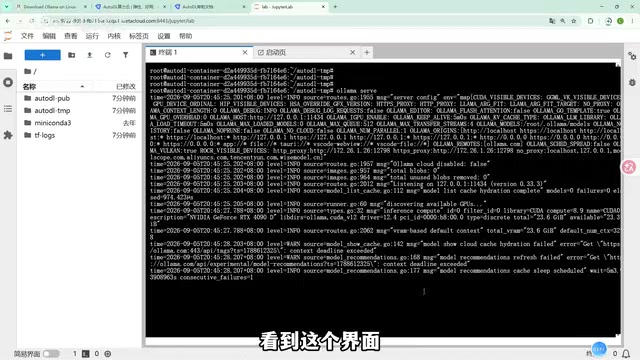
DeepSeek本地部署实战:Ollama+API调用完整教程
手把手教你用Ollama在本地或云服务器部署DeepSeek大模型,涵盖硬件配置选型、模型下载命令,以及Ollama官方库、requests、OpenAI兼容接口三种API调用方式,小白也能轻松上手。

DeepSeek Harness入门:Node.js环境安装与配置全指南
DeepSeek Harness 零基础入门教程:详解 Node.js 环境安装、npm 配置与系统环境变量设置全流程,避开 C 盘占满、路径中文等常见坑,为搭建 AI 智能体框架打好基础。

DeepSeek V5爆料:开源模型剑指Astra,多方新模型混战在即
海外博主爆料DeepSeek V5将对标GPT-6 Astra与Fable 5.1,Kimi K3.1、Anthropic Opus 5.5等新模型也接连传出消息。本文梳理各方泄露信息与内测者观点分歧,解读AI大模型的密集竞争态势。
DeepSeek V4.1 Flash实测:不是模型拉了,是你没用对
DeepSeek V4.1 Flash实测5天:速度飙到250 token/秒,但在不同Harness下体验天差地别。本文还原从'串稀玩意儿'到'最好用模型'的评价反转,揭示上下文污染、模型行为与工作流匹配才是关键。

拆解DeepSeek V3:557万美元训出671B参数模型的四大工程秘密
油管博主逐行拆解DeepSeek V3技术报告,揭示671B参数模型仅用557.6万美元完成训练的四大工程决策:MoE专家路由、无辅助损失负载均衡、MLA注意力压缩与FP8混合精度训练。附成本细节与基准表现及必要的怀疑。

DeepSeek V4.1 Flash实测:不到1美元烧掉6500万tokens
DeepSeek V4.1 Flash实测:89分钟消耗6500万tokens构建应用仅花不到1美元。深度解析其因果编码器-解码器架构、KV缓存瘦身至不足1KB、Ingram条件记忆与MIT许可证带来的成本革命。

DeepSeek V4.1 Flash深度解析:低价屠榜背后的架构革命
DeepSeek V4.1 Flash深度解析:5520亿参数MoE模型通过CED架构、CSA2稀疏注意力和FP4缓存,将KV Cache压缩437倍、成本直降60%,在智能体基准上击败昂贵旗舰。同时强制迁移策略引发开发者反弹,本文剖析其技术与行业影响。