AI Agent 科研绘图:多层级桑基图实战

PlugCase 案例库结合 AI Agent 与 MCP,实现多层级桑基图的自动化生成与代码适配。
文章探讨了科研数据可视化中多层级桑基图的绘制难题,提出以 PlugCase 数据可视化案例知识库为核心,通过 MCP 协议接入 AI Agent 的解决方案。PlugCase 整合了桑基图、网络图、绘图代码和方法说明等资源,使 Agent 能够检索相似案例、映射数据字段并生成可运行代码。文章详细拆解了接入 MCP、提交需求、检索适配三个操作环节,并指出该模式能显著缩短从数据到图表的路径。同时强调案例库的覆盖范围和人工核验的必要性,认为案例驱动生成比纯代码生成更可控,更贴近科研绘图工作流。
科研数据可视化常面临多层级流向难以清晰呈现的困境,尤其是桑基图这类需要精确表达流量与节点关系的图表。传统方式下,研究者需要手动编写绘图代码、反复调试样式,耗时且容易出错。如今,借助 AI Agent 与专用案例知识库的结合,这一流程正在被重新定义。
多层级桑基图的核心挑战
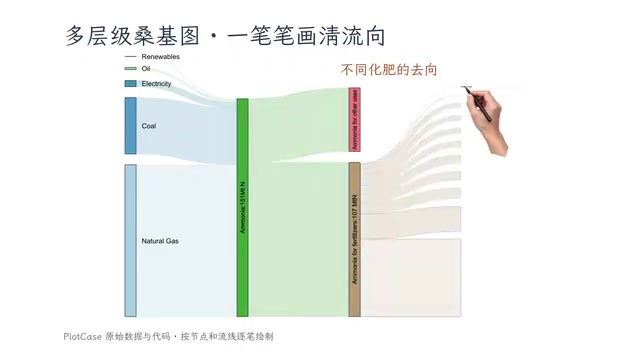
桑基图擅长表达数据从源到汇的流动路径,但当数据涉及多个层级时——例如从能源投入、到中间产品生产、再到最终化肥去向——节点与流线的组织会变得极其复杂。流线宽度代表流量大小,节点位置和层级划分直接影响可读性。研究者往往需要反复调整布局参数,才能让图表既准确又美观。
据原始素材描述,多层级桑基图需要“把每一步的流向连接起来”,并明确“流线越宽代表的流量越大”。这意味着绘图工具不仅要能处理数据聚合,还要支持层级定义和视觉映射。对于非专业可视化开发者而言,从零实现这样的图表门槛不低。
桑基图(Sankey Diagram)是一种流量可视化图表,由 Matthew Henry Phineas Riall Sankey 于1898年提出,最初用于展示蒸汽机的能量效率。其核心元素包括节点(Node)和流线(Link),流线的宽度与流量值成正比,从而直观呈现资源或能量在系统各环节间的分配与损耗。多层级桑基图在此基础上引入层级(Layer)概念,将节点按业务逻辑划分为多个阶段(如投入、转化、产出),流线则跨层级连接,形成有向无环图(DAG)。这种结构要求数据具备明确的起点、终点和中间聚合逻辑,且各层级的节点总量需满足守恒关系(流入等于流出加上损耗)。常见的实现库有 Plotly、D3.js 和 ECharts,但均需手动定义节点索引、链接关系及布局参数。
PlugCase 知识库:案例驱动的绘图方式
PlugCase 定位为数据可视化案例知识库,覆盖桑基图、网络图、图表、视力数据、绘图代码和方法说明等多种资源。它的核心价值在于将“案例”与“代码”绑定:用户不仅能查看最终效果图,还能获取对应的绘图代码和实现方法。这种结构让 AI Agent 有了可检索的参考依据,而不是凭空生成代码。
在 AI Agent 中接入 PlugCase 的 MCP(模型上下文协议)后,Agent 可以访问这一知识库。当用户提交数据和绘图需求时,Agent 会检索相关案例、适配数据字段,再编写可视化代码。这一流程将“找案例—改数据—调代码”的重复劳动交给 Agent,研究者只需关注数据本身和最终呈现效果。
MCP(Model Context Protocol,模型上下文协议)是由 Anthropic 于 2024 年提出的开放协议,旨在标准化 AI 助手与外部工具、数据源之间的交互方式。在 MCP 框架下,AI Agent 可以通过统一的接口访问知识库、数据库、API 等资源,而无需为每个数据源单独编写集成代码。具体到 PlugCase 场景,PlugCase 作为 MCP 服务器(Server)暴露案例检索、代码获取等能力,AI Agent 作为客户端(Client)发起请求,协议负责处理身份验证、请求路由和响应格式。这种架构使 Agent 能够动态发现可用工具,并根据用户需求组合调用,从而实现“检索案例—适配数据—生成代码”的自动化流程。
AI Agent 如何接入并完成绘图
具体操作路径可以拆解为三个环节。第一步是接入 MCP,让 Agent 具备访问 PlugCase 案例库的能力;第二步是提交数据与需求描述,例如说明数据包含哪些层级、需要突出哪些流向;第三步是 Agent 检索匹配案例,根据字段映射关系调整代码,生成可运行的绘图脚本。
这一过程中,Agent 的优势在于快速匹配案例模板,并处理数据字段的对应关系。对于多层级桑基图,Agent 可以从知识库中找到结构相似的案例,复用其层级定义和样式配置,再根据实际数据替换节点和流量值。这比从零编写代码更高效,也降低了出错概率。
案例库与 Agent 协作的边界
提一嘴,PlugCase 与 AI Agent 的协作模式仍依赖案例库的覆盖范围。如果遇到知识库中缺乏的图表类型或特殊数据结构,Agent 的适配能力会受限。原始素材强调“从桑基图到网络图、图表、视力数据、绘图代码和方法说明都能一起参考”,说明知识库的广度是这一方案的基础。
另一方面,Agent 生成的代码仍需人工核验。数据字段映射是否准确、层级关系是否符合业务逻辑、流线宽度是否真实反映流量比例,这些都需要研究者最终确认。AI Agent 在这里扮演的是加速器角色,而非完全替代人工判断。
案例库的覆盖范围直接决定了 Agent 的生成质量。如果知识库中缺少目标图表类型或数据结构不匹配,Agent 可能退化为通用代码生成,失去案例驱动的优势。此外,案例的代码质量、数据字段命名规范、样式配置的模块化程度都会影响复用效果。因此,构建可持续的案例库需要建立案例审核机制、字段映射标准和版本管理策略。对于科研场景,还需考虑数据隐私和知识产权问题,确保案例库中的代码和数据可安全共享。
对科研可视化的实际意义
对于需要频繁制作多层级流向图的科研场景,这一方案的价值在于缩短从数据到图表的路径。研究者不必在绘图库的API和样式参数上耗费大量时间,而是通过自然语言描述需求,由 Agent 调用案例库完成初版代码。后续调整也可以基于已有代码进行,迭代速度更快。
PlugCase 让 AI Agent“开着案例画图”,本质上是将可视化经验沉淀为可检索的案例资产,再通过 MCP 让 Agent 复用这些资产。对于桑基图这类结构复杂、参数繁多的图表类型,案例驱动的生成方式比纯代码生成更可控,也更贴近科研绘图的真实工作流。
相关推荐

单卡12G跑本地实时语音AI:35B模型+语音对话全流程
国外开发者展示如何在单张12GB显卡上本地运行35B MoE语言模型、Whisper语音识别与Breeze TTS2语音合成,通过流式转录、并行合成与量化优化,将端到端语音对话延迟从8秒降至2-3秒,并接入Agent工具调用场景。

Qwen4架构预览已开源:125B参数、512专家,专为显存受限硬件设计
Qwen4尚未发布但架构已通过Qwen3.8 Flash Next开源预览:125B参数、每Token激活6B、512专家、262K上下文,专为显存受限硬件设计。本文梳理官方确认信息、config.json关键指标及24G内存本地部署实测。

6G显存跑8K图!复旦开源MOSS-Image生图模型实测
复旦OpenMouse团队与上海摩斯智能开源MOSS-Image生图模型,5亿参数DT架构,6G显存即可本地跑图,文字渲染精准、支持结构化布局控制与4K Tokens长提示词,适合电商海报与个人创作者本地部署。