B站教程深度解读:大模型Agent从原理到Agent Tuning实战

B站Agent教程拆解从Prompt、RAG到Agent Tuning的落地决策路径。
本文基于B站一套零基础到实战的Agent教程,梳理智能体落地的完整逻辑链。文章先指出原生大模型的三大硬伤——幻觉、参数无法实时更新、复杂任务难以一步完成,由此说明Agent的必要性;接着介绍Prompt、RAG、Agent三层技术框架,强调Planning与工具集、Memory是Agent的核心。针对Agent Tuning,文章解释其三点动因:复杂Prompt对模型能力要求高、私有化与成本约束、小模型经专项训练也能获得Agent能力;并给出“先用GPT-4调通流程、再构建数据训练、最后替换验证”的研发流程。最终结论是:Agent Tuning并非必需,应根据API可用性、私有化要求和训练成本综合决策。
大模型能说会道,却未必能真正“做事”。B站近期一套零基础到实战的Agent教程,从应用场景、技术框架讲到Agent Tuning的研发流程与成本决策,把智能体落地的关键问题拆得相当清楚。本文基于该教程内容,结合多张截图中的现场演示,梳理出一条从“为什么需要Agent”到“什么时候该做Agent Tuning”的完整逻辑链。
为什么大模型应用离不开Agent?
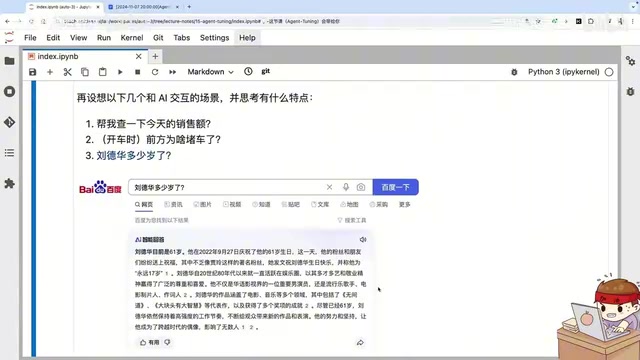
教程开篇没有直接讲技术,而是先抛出一组典型场景:查“不为无等你遮妖”的出处、查询时间和天气、查当天销售额、开车时问前方为何堵车、问刘德华多少岁。这些问题看似日常,却暴露了原生大模型的三个硬伤。
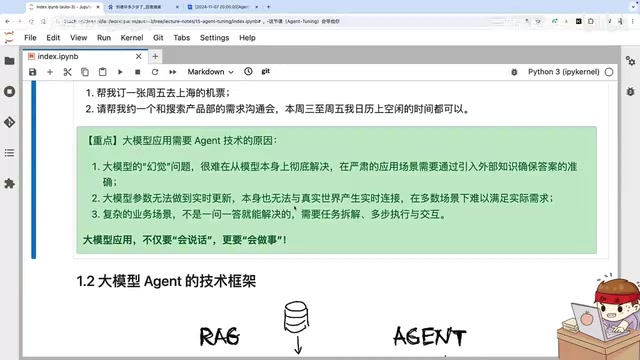
第一是幻觉问题。大模型本质是概率生成模型,偏差不可避免,在严肃场景下很难仅靠模型自身保证答案正确。第二是参数无法实时更新,训练完就是一个静态模型,与真实世界脱节,实时信息只能借助外部工具查询。第三是复杂业务场景需要任务拆解、多步执行和交互,一问一答的模式根本不够用。
教程中展示了一个很有说服力的对比:一个月前问文心“刘德华多少岁”,它依据2022年庆祝61岁生日的网页回答61岁,显然错误;而现在文心会把查询生日、结合当前时间计算年龄差的中间过程都呈现出来,给出正确答案。这正是Agent的典型价值——不仅给出答案,还展示思考步骤和中间结果,让答案有据可查,提升可靠性。
Agent技术框架:从Prompt到Planning的进化
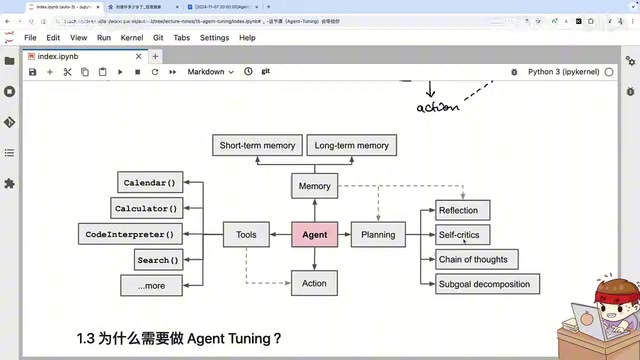
教程引用国外网站的总结图,把大模型应用分为三个层次。最原生的是Prompt模式,用户指令进入大模型黑盒,直接给出回答,简单但能力有限。中间层是RAG(检索增强生成),面对需要实时或准确信息的问题,先去索引库、知识库或全网搜索相关上下文,再交给大模型参考作答,缓解幻觉。
到了Agent层,结构明显复杂:工具集更丰富,按业务结合各种工具;具备长短期的Memory;Planning过程包含深度思考、自我批评和思维链,把问题拆解成子任务逐步执行,反复迭代直至完成。教程特别指出,Planning是Agent必须具备的能力,而左侧丰富工具集和Memory则支撑起面向广泛场景的落地。
RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路是“先检索、后生成”:面对用户问题时,系统先从外部知识库、索引库或搜索引擎中检索出与问题相关的文档片段,再将这些片段作为上下文与原始问题一起送入大模型,由模型基于这些参考材料生成答案。这样做的好处是,模型不必把全部知识都“背”在参数里,实时信息、企业私有知识都可以通过外挂检索库获得,从而显著缓解幻觉。代价是系统复杂度上升,检索质量直接决定回答质量——检索不到或检索错误,模型就会“基于错误材料一本正经地胡说”。RAG通常被视为从纯Prompt走向Agent的中间形态。
Planning(规划)是Agent区别于普通问答系统的关键能力。当任务无法一步完成时,Agent需要把目标拆解为若干子任务,排定执行顺序,调用不同工具逐步推进,并在每一步后评估结果、决定是否调整下一步——这正是思维链(Chain-of-Thought)和自我批评(Self-Critique)所起的作用。思维链让模型显式写出推理步骤,把“隐式计算”变成“可见过程”;自我批评则让模型对中间结果做检查,发现错误后回溯修正。二者结合形成“拆解—执行—检查—迭代”的闭环,使Agent能够处理多步、依赖外部信息且容易出错的复杂业务,而不仅仅是一次性的文本生成。
为什么需要Agent Tuning?
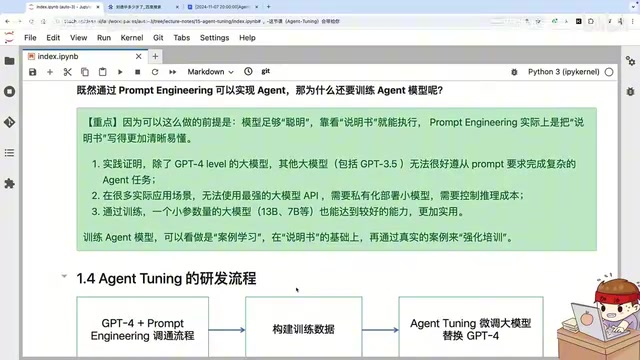
既然用Prompt Engineering就能写出复杂指令实现Agent流程,为什么还要做Agent Tuning?教程给出三点理由。
其一,Prompt本质是给大模型写“说明书”,前提是模型足够聪明。实践证明,除GPT-4及以上级别的大模型,包括3.5在内的其他模型并不能很好理解复杂Prompt、完成复杂任务。其二,实际应用常要求私有化部署,最强的大模型API未必可用,还要控制推理成本,只能自建模型。其三,通过Agent Tuning专项训练,小参数量模型(如3B、7B)也能获得较好的Agent能力,推理成本更低、部署更方便。
教程用了一个生动的类比:大学生毕业前接受通识教育,具备通用知识储备,但走上工作岗位还需要上岗前培训。Agent Tuning就是在说明书基础上,用真实案例做强化培训。
Agent Tuning(智能体微调)是指在通用大模型基础上,用专门构建的Agent任务数据做进一步训练,使模型学会按Agent的方式工作:理解复杂指令、按格式调用工具、遵循多步规划流程、在出错时自我修正。它与普通指令微调的差别在于,训练数据不是简单的“问题—答案”对,而是包含工具调用轨迹、多步推理过程、成功与失败的完整任务记录。之所以有效,是因为小参数量模型本身“不够聪明”,仅靠Prompt很难稳定遵循复杂流程;而通过大量真实案例的专项训练,可以把这些行为模式“内化”进模型参数,从而在3B、7B这类小模型上获得可用的Agent能力,同时降低推理成本和私有化部署门槛。
Agent Tuning的研发流程与成本考量
典型研发流程是:先借助GPT-4这类强模型把整个Agent流程调通,因为Prompt和后续训练数据强关联;然后在调通的基础上构建训练数据,自动化加人工共同修正;接着做Agent Tuning训练自己的模型;最后替换验证,完成闭环。
但教程明确提醒,Agent Tuning并非任何业务场景都必需。如果能用强模型API且成本可接受,就没必要做Tuning,因为训练本身有成本。教程以7B模型为例估算:470万token训练数据、训练五轮,按阿里云广告A100价格估算需要四卡,训练时长和成本都有具体数字,且这只是一次性训好的情况,若需调整还要追加成本。
“用强模型调通流程再训练小模型”是知识蒸馏思路在Agent场景的延伸。由于训练数据的格式、工具调用方式和规划步骤都与前期Prompt设计强绑定,先用GPT-4级模型把整个Agent流程跑通,等于先确定“标准答案长什么样”,再据此批量生成高质量训练数据。若顺序颠倒,先训模型再改流程,往往意味着数据全部作废、重新训练。这也是教程强调“Prompt和训练数据强关联”的原因。需要补充的是,训练成本只是总成本的一部分,数据构建(自动化生成加人工修正)通常更耗时耗力;而一次训练完成后,若业务工具或流程发生变化,还需要追加数据和再训练,这部分隐性成本在决策时同样应纳入考量。
多源视角下的Agent落地共识
综合B站教程与YouTube上多个Agent技术频道的分析,一个共识正在形成:Agent不是替代大模型,而是补齐大模型在实时性、可靠性和复杂任务执行上的短板。对于企业而言,关键决策点不在于“要不要Agent”,而在于“用Prompt、RAG还是Tuning”。资源充足、场景通用时,强模型API加Prompt是捷径;涉及私有化、成本敏感或小模型部署时,Agent Tuning才值得投入。这套教程的价值,正在于把这条决策路径讲得足够具体。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。