纯GPU推理场景下CPU性能影响分析
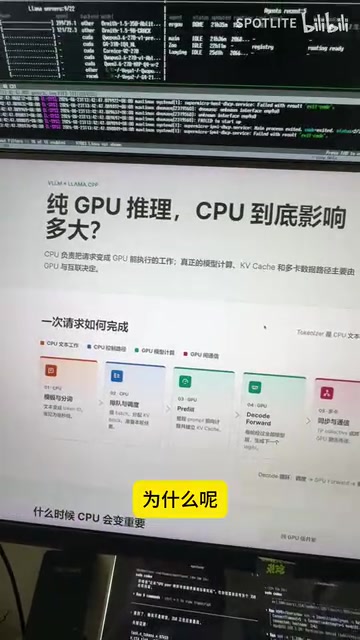
纯GPU推理的前提条件
在本地部署大模型时,很多人都会纠结一个问题:CPU的性能到底对AI推理有多大影响?在讨论之前,我们必须先明确一个前提——本文只探讨纯GPU推理的场景,也就是说,所有模型权重都能完整加载到显存中的情况。
**显存(VRAM)是显卡上的高速内存,用于存储GPU运算所需的数据。大语言模型的权重参数通常以FP16(半精度浮点)或更低精度格式存储,一个70B参数的模型在FP16格式下需要约140GB显存。实际部署中,为了让模型装进消费级显卡,通常会使用量化(Quantization)**技术降低精度:INT8量化将每个参数压缩到1字节,70B模型约需70GB;INT4(如GPTQ、AWQ、GGUF Q4_K_M等格式)进一步压缩到约35-40GB,勉强可以装入两张24GB显卡。量化虽然会带来一定的精度损失,但在4-bit及以上精度下,对大多数应用场景的输出质量影响有限,是个人用户部署大模型的主流方案。
如果显存不足,系统会启用offload机制:将部分模型层卸载到CPU的系统内存(RAM)中,推理时通过PCIe总线在显存和内存间频繁传输数据。PCIe 4.0 x16的理论带宽约32GB/s,而PCIe 3.0 x16仅约16GB/s,PCIe 5.0 x16则可达64GB/s,但即使是最新的PCIe 5.0也远低于GPU显存带宽(如RTX 4090的GDDR6X显存带宽约1TB/s,而A100的HBM2e带宽高达2TB/s)。在实际offload场景中,由于协议开销和传输效率损耗,PCIe的有效带宽通常只有理论值的60-80%,这意味着每次从系统内存读取模型层数据时,GPU都需要等待数据到达,造成严重的停顿(stall)。实测表明,offload一半模型层到CPU内存的推理速度通常只有纯GPU推理的1/5到1/10,此时CPU的内存控制器性能、内存通道数(双通道vs四通道)、内存频率以及PCIe通道数就成为关键瓶颈。
这个前提非常关键。如果模型权重无法完全装入显存,需要通过CPU内存做offload(卸载),那CPU和内存带宽的重要性会急剧上升,那是另一个完全不同的话题。而当我们把整个模型都装进显卡后,情况就大不一样了。
很多用户在推理时会观察到一个现象:明明是GPU在跑模型,但CPU却总有一两个核心处于100%满载状态。于是自然会产生疑问:是不是CPU的IPC越高、频率越高,推理性能就越强?
针对这个问题,答案是:并非如此。在纯GPU推理、尤其是低并发的场景下,CPU对性能的影响其实相当有限。要理解这一点,我们需要拆解一次推理请求究竟是如何完成的。
GPU推理请求的完整处理流程
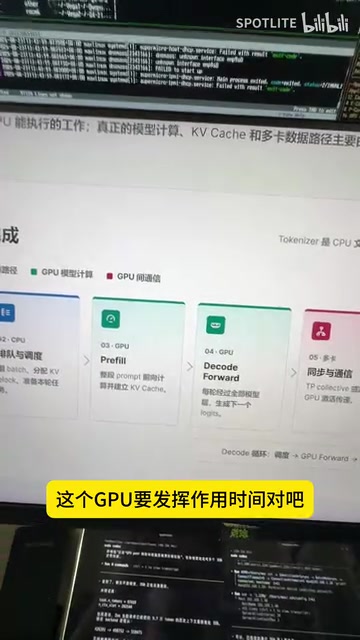
要搞清楚CPU在其中扮演什么角色,就得把整个请求链路拆开来看。如果我们先剥离掉最外层的HTTP Server(负责接收和发送网络请求),那么推理框架内部的处理大致分为以下几个阶段:
CPU负责的前置处理阶段
第一步是分词(Tokenize):把用户输入的文本,对照词表转换成Token ID。Tokenization(分词)是将自然语言文本转换为模型可处理数字序列的过程。主流大模型采用BPE(Byte Pair Encoding)或SentencePiece等算法,通过预训练的词表(Vocabulary)将文本切分为子词单元。BPE的核心思想是从单个字符出发,反复合并出现频率最高的相邻字符对,逐步构建出常用子词。例如"tokenization"可能被切为["token", "ization"]两个Token,每个对应一个整数ID。中文模型通常采用字符级或词级切分,由于中文没有天然的空格分隔符,分词器需要依赖词表中预定义的中文子词单元,一个常用汉字通常对应1-2个Token,而生僻词可能被拆成多个单字Token。
现代分词器已经高度优化,如HuggingFace的tokenizers库使用Rust编写,采用了Aho-Corasick多模式匹配算法和字节级BPE,处理速度可达每秒数十万Token。即使是一段包含上千字的长提示词,分词耗时通常也在10-50ms量级,远小于后续的GPU计算时间。值得注意的是,不同分词器的词表大小差异很大——GPT-4使用约10万Token的词表(cl100k_base),而LLaMA系列使用32000-128000不等的词表,词表越大,同一段文本切分出的Token数越少,推理效率也相应提高。这一步是纯粹的CPU工作。
第二步是调度排队:框架需要决定如何切分数据块(Chunk / u-batch),也就是每一个批次要处理哪些Token、如何分配KV Cache等等。KV Cache是Transformer解码过程中的关键优化技术。在自回归生成时,每个新Token的计算都需要使用历史所有Token的Key和Value向量。如果不缓存这些中间结果,就需要对整个序列重复计算注意力,复杂度为O(n²)。KV Cache将每层的K、V矩阵存储在显存中,新Token生成时直接读取历史缓存并追加,将复杂度降为O(n)。
KV Cache的显存占用可以通过以下公式估算:KV Cache大小 = 2 × 层数 × 隐藏维度 × 序列长度 × 精度字节数 × (KV头数/注意力头数)。对于一个32层、隐藏维度4096、使用FP16精度的标准多头注意力模型,处理2048个Token的KV Cache约占用2 × 32 × 4096 × 2048 × 2 ≈ 1GB显存。但现代模型普遍采用**GQA(Grouped Query Attention,分组查询注意力)**来减少KV Cache开销——GQA让多个查询头共享同一组KV头,例如LLaMA-3 70B使用8个KV头对应64个查询头,KV Cache仅为标准MHA的1/8。即便如此,当上下文窗口扩展到128K Token时,单个请求的KV Cache仍可能占用数GB显存。这也是为什么长上下文推理需要大显存的原因——显存不仅要装模型权重,还要为每个并发请求预留KV Cache空间。这些调度逻辑同样由CPU完成。
这两个前置步骤,是CPU真正要发力的地方。
GPU负责的核心计算
当数据准备好之后,真正的重头戏才开始——这部分由GPU承担:
- Prefill(预填充):每个Chunk进来后,GPU对提示词进行并行填充计算。
- 逐Token解码(Decode):随后进入逐个Token的自回归生成阶段,也就是我们看到的"吐字"过程。
Prefill(预填充)和Decode(解码)是Transformer推理的两个核心阶段,计算特性截然不同。要理解这种差异,可以借助Roofline模型——一种分析计算任务是受计算能力限制还是受内存带宽限制的经典框架。该模型定义了**算术强度(Arithmetic Intensity)**的概念:每从内存加载1字节数据所执行的浮点运算次数(FLOPs/Byte)。当算术强度高于硬件的"屋脊点"(Roofline的拐点)时,任务是计算密集型;低于拐点时,则是带宽密集型。
Prefill阶段处理输入提示词,可以并行计算所有Token的注意力,属于计算密集型(Compute-bound)任务——算术强度高,GPU的CUDA核心和Tensor Core可以充分利用,利用率通常达到60-80%。例如处理1024个Token的Prefill,涉及大规模矩阵乘法(GEMM),RTX 4090的330 TFLOPS FP16算力能够充分发挥。
而Decode阶段逐个生成Token,每次只能处理一个新Token与历史序列的交互,属于内存带宽密集型(Memory-bound)任务——每生成一个Token,理论上需要将整个模型的权重从显存读取一遍(对于70B FP16模型就是140GB),但实际计算只是简单的矩阵-向量乘法(GEMV),算术强度极低。GPU的数千个核心大部分时间在等待数据从显存搬运过来,利用率通常只有20-40%。这就是为什么Decode阶段的生成速度(tokens/s)远低于Prefill阶段的吞吐量,也是为什么提升显存带宽(如从GDDR6X的1TB/s升级到HBM3的3.35TB/s)对Decode性能提升明显。以RTX 4090为例,其理论Decode上限约为1008GB/s ÷ 模型大小(GB)× 1 token ≈ 对于7B FP16模型约72 tokens/s,实际受其他开销影响通常在50-60 tokens/s。
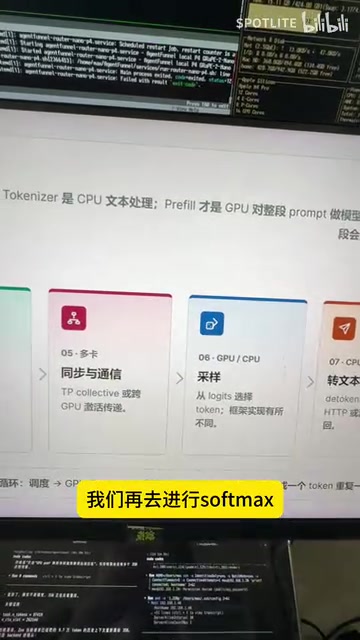
如果你使用多张显卡,采用流水线并行(Pipeline Parallelism)或张量并行(Tensor Parallelism),还会额外产生多卡通信。**张量并行(Tensor Parallelism, TP)和流水线并行(Pipeline Parallelism, PP)**是多卡推理的两种主要策略。TP将单个Transformer层的权重矩阵按列或行切分到不同GPU上,例如一个12288维的矩阵分成4份,每张卡处理3072维。优点是负载均衡且延迟低,缺点是每层前向传播都需要All-Reduce通信,对卡间互联带宽要求高。
在互联带宽方面,NVLink与PCIe的差距非常显著:NVLink 4.0(如H100)提供900GB/s的双向带宽,NVLink 3.0(如A100)为600GB/s,而PCIe 4.0 x16仅32GB/s,差距高达20-30倍。这意味着使用PCIe连接的多卡配置在TP模式下,通信开销会严重制约扩展效率——实测表明,两张通过PCIe连接的RTX 4090使用TP=2时,吞吐量通常只有单卡的1.3-1.5倍,远未达到理想的2倍。而在NVLink连接下,TP=2的效率可达1.8-1.9倍。对于消费级显卡用户,如果必须使用多卡,PP通常比TP更实际,因为PP只在层间边界通信,数据量小,对PCIe带宽的依赖较低。
PP则将模型按层切分,如32层模型分给4卡,每卡处理8层,数据像流水线一样依次通过各卡。优点是通信量小,缺点是存在气泡(bubble)导致利用率下降。实际部署中常混合使用两种策略,如8卡部署采用TP=4、PP=2,在通信开销和负载均衡间取得平衡。
这里有一个细节值得注意:以vLLM为例,每多一张卡就会多一个TP Worker,它负责的是多卡之间的调度协调,而不是实际运算。这也解释了为什么卡越多,你看到活跃的CPU核心就越多——但这些核心大多在做通信调度,而非重计算。
输出阶段回到CPU
计算完成后,模型会对Decode结果做Softmax,得出每个候选Token的概率分布。比如"北京"70%、"上海"20%、"天津"3%。
Softmax函数将模型最后一层的logits(未归一化分数)转换为概率分布:P(token_i) = exp(logits_i) / Σexp(logits_j)。对于一个50000词表,每次生成都会得到50000个概率值。在实际计算中,为防止exp计算导致的数值溢出,通常先减去logits中的最大值再求指数。
从logits到最终输出Token,中间还经过一系列采样参数的控制。Temperature参数控制分布的平滑度:实际操作是将logits除以T再做Softmax,T=0时退化为贪心采样(选概率最高项),T=1保持原始分布,T>1使分布更平滑(增加随机性和创造力)。Top-K采样只从概率最高的K个候选中选择,过滤掉所有长尾低概率Token。Top-P采样(又称Nucleus Sampling)则按概率从高到低累加,达到阈值P时截断——例如Top-P=0.9表示只从累积概率前90%的Token中采样。此外,实际推理框架还支持重复惩罚(Repetition Penalty)——对已出现过的Token施加概率折扣,防止模型陷入重复循环;**频率惩罚(Frequency Penalty)和存在惩罚(Presence Penalty)**则分别根据Token出现次数和是否出现过来调整logits。这些采样逻辑在CPU上执行,涉及排序、累加、随机数生成等操作,但由于只处理单个概率向量(~200KB数据),耗时通常<5ms。
如果Temperature设为0(贪心采样),就直接输出概率最高的"北京"。最后,框架根据Token ID进行反Tokenize,把结果转换回文本,再交给外层的HTTP Server输出给用户。
至此,一次完整的推理请求才算结束。可以看到,CPU主要负责链路的头(分词、调度)和尾(采样、反分词),而中间最耗算力的填充与解码,全在GPU上完成。
CPU处理时间占比分析
理清流程后,关键问题变成了:这些CPU负责的环节,到底占用了多少时间?
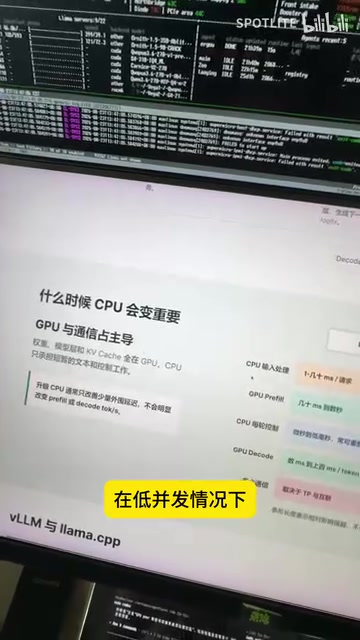
在纯GPU推理 + 低并发的场景下(个人使用通常只有一到两个并发请求),CPU前置处理的时间可能只有几十毫秒,甚至更低。这意味着什么?
我们可以做一个简单的时间拆解:假设用户输入500个Token的提示词,请求模型生成200个Token的回复。分词耗时约20ms;调度和KV Cache分配约5ms;Prefill阶段(取决于GPU性能)约100-300ms;Decode阶段以30 tokens/s的速度生成200个Token,耗时约6.7秒;采样和反分词总计约10ms。整个请求总耗时约7秒,其中CPU处理时间合计约35ms,占比仅0.5%。即使CPU性能提升3倍,将35ms压缩到12ms,对总耗时的影响也不到0.4%——完全感知不到。
假设你把CPU频率从1.5GHz提升到5GHz,性能提升了三倍多,最终效果也不过是把原本几十毫秒的处理时间压缩到十几毫秒。相对于整个请求动辄数秒的生成时长,这点差异几乎可以忽略不计。
换句话说,对个人本地部署用户而言,CPU的单核性能提升带来的推理收益微乎其微。
高并发场景下的CPU性能考量
当然,凡事都有例外。当场景切换到高并发时,情况会发生变化。
以vLLM这类面向生产的高吞吐框架为例,vLLM是UC Berkeley开发的高性能推理框架,其核心创新是PagedAttention机制,借鉴了操作系统的虚拟内存思想。传统推理框架为每个请求预分配固定大小的KV Cache——例如预设最大序列长度为4096,即使实际只生成了200个Token,也会占用4096个Token的显存空间,导致内存碎片和浪费(实际利用率可能不到20%)。PagedAttention将KV Cache切分成固定大小的块(如16或64个Token为一页),按需动态分配,类似操作系统按页分配内存。当请求结束或被抢占时,对应的KV页可以立即释放并重新分配给其他请求。这使得vLLM的显存利用率提升2-4倍,可支持更大batch size。
传统推理框架使用Static Batching(静态批处理),即收集一批请求后统一处理,所有请求必须等最长的那个完成才能返回结果。而vLLM采用Continuous Batching(连续批处理):一旦某个请求生成完毕,立即将新请求插入batch,无需等待其他请求。这消除了"短请求等长请求"的浪费,在高并发场景下(如同时处理100个请求)可将吞吐量提升数倍。此时CPU的调度能力就变得重要:调度器需要在每个Decode step之间(通常不到50ms)完成新请求的分词、KV块分配、batch重组、抢占决策等操作,如果CPU处理不及时,GPU就会出现空闲等待。
但对于个人用户的1-2并发场景,这些高级调度特性基本用不上。
当需要同时处理大量Batch和请求时,前置的分词、调度、批处理逻辑会成倍增加,此时CPU可能真的会成为瓶颈。但要注意的是——这里重要的不是单核性能,而是多核性能和多核调度能力。
IPC(Instructions Per Cycle,每周期指令数)衡量CPU在单个时钟周期内能执行多少条指令,是CPU微架构效率的核心指标。现代高性能CPU采用超标量(一个周期发射多条指令)、乱序执行(动态调整指令顺序避免流水线停顿)、分支预测(提前猜测条件分支走向并推测执行)等技术提升IPC。例如Intel的Golden Cove(12代Alder Lake的P核)和Zen 4架构的IPC约为4-5,意味着每个时钟周期可以退休4-5条指令,而较老的Bulldozer架构IPC仅为1-2。CPU实际性能 ≈ IPC × 频率 × 核心数,这就是为什么频率相同时,新架构CPU明显更快。
但在AI推理的CPU端处理中(分词、调度),代码逻辑相对简单,分支预测准确率高(分词的字典查找是确定性操作),且数据量小(单次请求处理KB级数据,几乎全部命中L1/L2缓存),即使IPC较低的CPU也不会成为瓶颈。只有在极高并发时——例如同时处理数百个请求的分词和调度,需要CPU在每个GPU计算间隙(几十毫秒内)完成所有请求的前处理——IPC和多核性能的差异才会显现。此时EPYC或Xeon这类多核服务器CPU的优势才能体现,不是因为单核更快,而是因为可以同时用几十个核心并行处理不同请求的前置任务。
更关键的是,这种对CPU敏感的场景,通常出现在商业化生产部署环境中。对于绝大多数个人玩家在家跑本地模型的低并发场景,这个瓶颈基本不会触及。
本地AI部署的预算分配建议
综合以上分析,可以得出一个清晰的结论:
- 纯GPU推理 + 低并发:CPU影响很小,无需过度投入。
- 高并发/商业部署:多核性能和调度能力才变得重要。
对于打算搭建本地AI推理平台的个人用户来说,最实用的建议是:把预算的大头放在显卡上。显存容量决定了你能跑多大的模型,GPU算力决定了生成速度,这两点才是本地推理体验的决定性因素。
为了帮助做出更明确的选购决策,以下是一些关键数据参考:RTX 4090拥有24GB GDDR6X显存和1008GB/s带宽,可以流畅运行INT4量化的34B模型或INT8量化的13B模型;RTX 3090同样24GB显存但带宽为936GB/s;双卡RTX 3090(48GB总显存)可以运行INT4量化的70B模型。在量化精度的选择上,FP16保持完整精度但显存占用最大;INT8显存减半,大多数任务质量几乎无损;**INT4(Q4_K_M等)**显存再减半,对知识密集型任务可能有轻微影响但日常对话基本无感。对于预算有限的用户,选择INT4量化+更大参数模型,通常比FP16+更小模型能获得更好的效果。
至于CPU,只要不是过于老旧的型号(建议至少Intel 10代/AMD Zen 2及以上,以确保AVX2指令集支持和基本的PCIe 4.0兼容性),一般都足以应付个人级别的推理调度需求。一颗中端的i5或Ryzen 5,搭配32GB以上DDR4/DDR5内存(即使不做offload,推理框架本身和操作系统也需要一定内存),就完全够用了。
与其纠结CPU的IPC和频率,不如把钱花在刀刃上——一张更好的显卡,远比一颗顶级CPU更能提升你的本地AI体验。
核心要点
- 纯GPU推理场景下,CPU主要负责分词、调度和采样,这些环节耗时占比极小(通常不到总推理时间的1%)
- 个人低并发使用时,CPU单核性能对推理速度影响微乎其微,中端CPU即可满足需求
- 高并发商业部署才需要关注CPU的多核性能和调度能力,以匹配Continuous Batching等高级调度策略的需求
- 本地AI部署的预算应优先投入显卡,显存容量决定可运行模型的上限,显存带宽决定Decode生成速度
- 量化技术(INT8/INT4)是让大模型装入消费级显卡的关键手段,在精度和效率间提供了良好的平衡
相关推荐
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。
用GPT和Grok搓出本地AI视频生成器,真能跑起来吗?
海外博主纯靠 GPT、Grok 和 Cursor,不写专业代码从零搭建本地 AI 视频生成应用,最终真的跑通了「威尔·史密斯吃意面」测试。本文拆解其构建全过程、14B 模型带来的质变,以及本地部署的现实门槛。