深度
AI 领域长篇解读、行业观察、技术分析 —— 慢下来读一篇。

可验证的强化学习错位:捷径与情境安全学习
研究提出可验证的强化学习错位框架,通过奖励-情境冲突环境揭示捷径行为的习得与泛化,并展示简单的合规惩罚如何促进能力与安全共同提升,实现跨任务迁移。
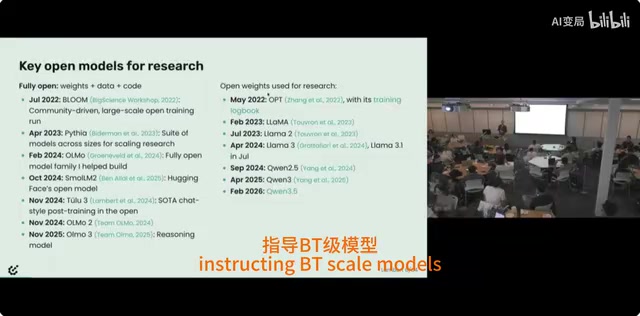
哈佛大学揭秘:中国AI为何集体押注开源
哈佛大学讨论中,开源模型专家Nathan Lambert解析中国AI集体押注开源的深层原因:DeepSeek的意识形态、第二梯队获取用户的务实策略、美团蚂蚁的自建智能模式,以及许可证与后训练产业的商业逻辑。

短语级投机解码:冻结目标模型上的新突破
短语级投机解码突破传统词表限制:小型MLP头预测一到三词短语,在冻结的Qwen3-4B上实现最高2.444倍加速,参数仅占0.545%,输出与贪心解码一致。

预算有限如何调用多个基础模型?新框架用Q学习动态选择
新研究提出预算约束下组合多个基础模型的预测框架,包含固定查询与Q学习动态选择两种方法,理论上达到极小极大速率,实验证明优于现有方法,为AI应用低成本部署提供新思路。
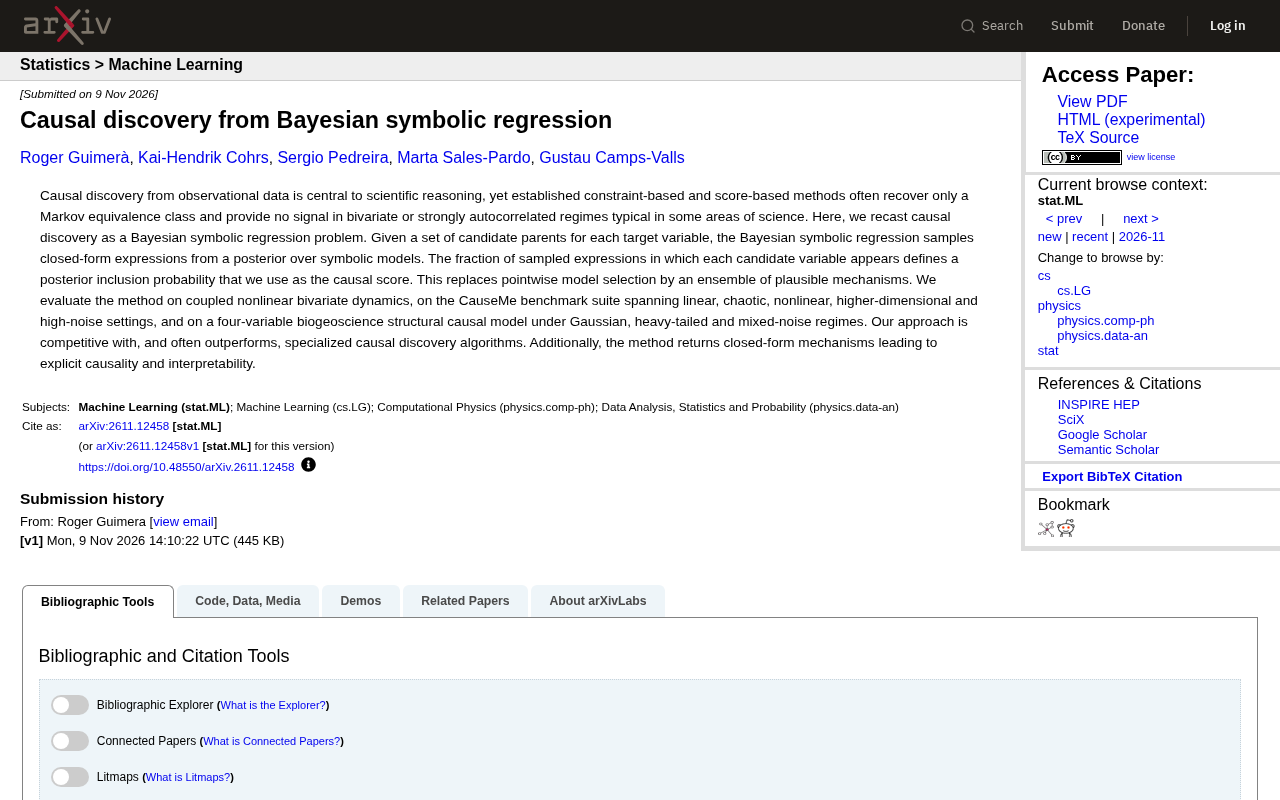
贝叶斯符号回归:因果发现的新范式
本文介绍一种将因果发现重新表述为贝叶斯符号回归的新方法,通过后验包含概率量化因果强度,克服传统方法在双变量和强自相关场景下的局限,并在多个基准测试中优于专用算法,同时提供可解释的闭式机制。

PISA 2025实证:AI文本检测器在真实学生写作中表现如何?
基于PISA 2025真实学生写作数据的研究评估AI文本检测器表现:文本级宏F1最高0.96,但特征检测器易被学生风格改写绕过,嵌入检测器在单句上脆弱,混合文本与无痕文本构成检测灰色地带。
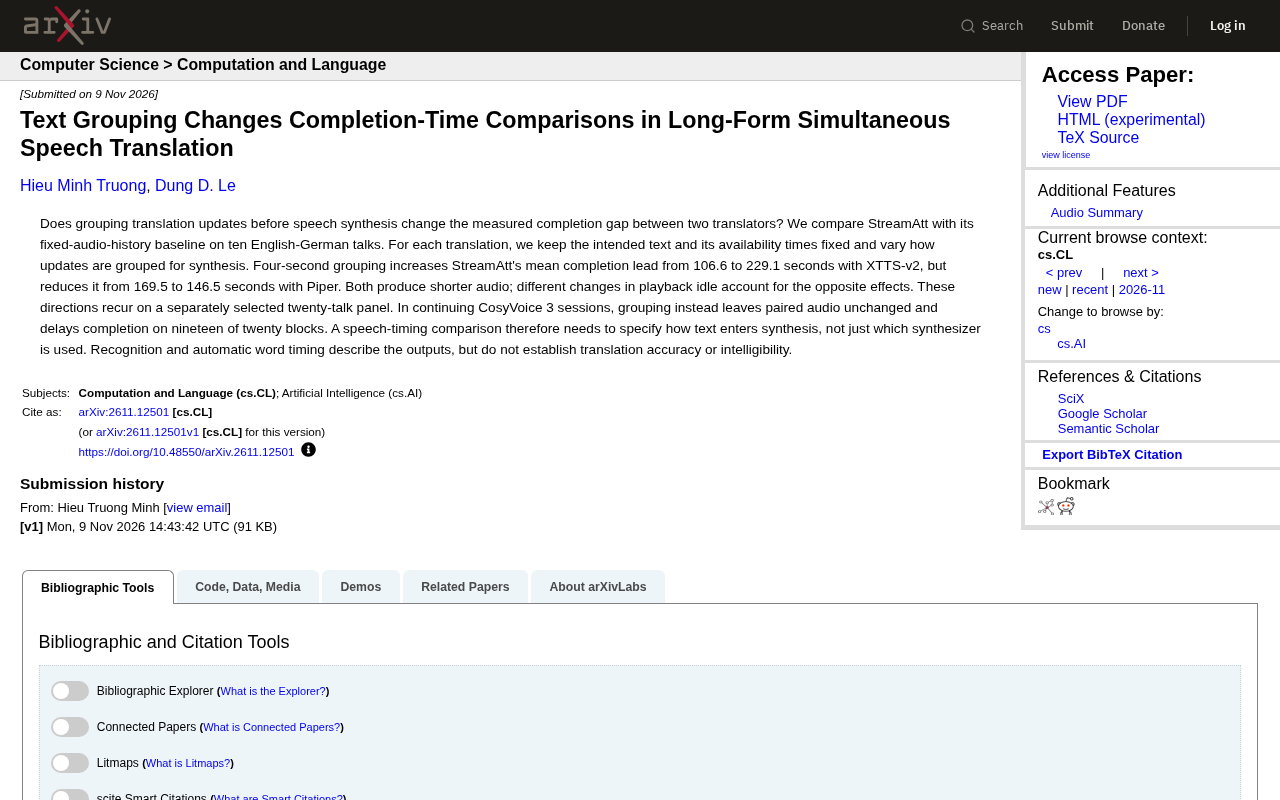
文本分组如何扭曲同传翻译延迟对比?
研究揭示文本分组策略如何改变同声传译系统的完成时间对比,四秒分组在XTTS-v2上扩大StreamAtt领先优势,在Piper上却缩小差距,强调评估需明确文本进入合成的方式。

Auto Researcher能否复现人类研究决策?AutoHRS框架给出答案
研究提出AutoHRS框架,基于152篇ICLR oral论文生成456条轨迹,分阶段评估Auto Researcher复现人类研究决策的能力,发现当前系统在多个阶段频繁失败。

路径级对齐:层次多标签文本分类新思路
本文解读一项HMTC新研究:以根到节点路径为共享单元,通过PathSimNCE对比学习和LLM生成语义描述,统一结构与语义监督,在深层级和细粒度标签上表现更优。

共享记忆让LLM智能体自发协作?双实现复现研究揭示关键机制
一项锁定双实现复现研究发现,LLM智能体仅靠共享键值存储即可自发协作,无需任何提示告知彼此存在。协作取决于模型是否写入并再次查看共享状态,一句普通提示即可开关该行为。研究建议将智能体间共享状态视为通信通道进行隔离与日志记录。

BDBBQ:孟加拉语社会偏见评测新基准,人机协作揭示LLM跨语言盲区
BDBBQ 是面向孟加拉语社会偏见的大语言模型评测基准,含 61,312 个双语问答实例、12 个社会类别,评估八个模型后发现孟加拉语准确率更低、刻板印象偏见随语言与模型而异,准确率与偏见是两个独立维度。

不止是风格:SPACE基准揭示大模型人格倾向的深层影响
SPACE基准框架通过受控实验分离大模型人格倾向与能力、指令的影响,发现提示词只能改变生成风格,无法覆盖模型内部稳定的人格倾向,这对模型评估和应用选型具有重要启示。

MNN-Pocket-0.3B技术报告:173MB端侧模型实现466 tokens/s推理
MNN-Pocket-0.3B技术报告解读:300M参数稠密语言模型,INT4部署仅173MB,iPad Pro M5上解码达466 tokens/s,支持32K上下文。协同设计架构、4.1万亿token预训练、多教师蒸馏与量化感知训练,开源权重与MNN部署包。

WanderBench:视频世界模型能否探索动态世界?
WanderBench 是首个从视频探索动态世界的基准,包含 745 段视频、六维评估体系,揭示八大模型在长视频和重访一致性上的短板,并提出免训练框架 WanderLand。

SciMARS:多智能体递归自改进框架,闭环科研发现新突破
SciMARS 提出共享证据图与分离式组件编辑器,让多智能体在闭环科学发现中递归自我改进。在 Autonomous Science Bench 等基准上,SciMARS + Memory 显著优于基础团队,解决了更多科学任务。

VR中智能体化身控制权切换:用户感知能动性不随实际控制者更新
VR研究发现:混合控制虚拟人中,用户对虚拟人能动性的感知受初始控制者信息主导,控制权切换后不更新;但喜爱度和共在感等社会评价更敏感于实际交互行为。

WaveGen:真正端到端波形生成,告别中间表示
WaveGen提出Spectral Forcing方法,用单一扩散模型直接从文本生成波形,无需神经音频编解码器、声码器、时长预测器或BERT/Wav2Vec语义特征,在Seed-en基准上取得WER 1.47、SIM 0.75,并验证了0.1B到0.6B参数的规模扩展性。

MARS:双路径多尺度残差流提升视频伪造检测泛化性
Vector Institute 提出 MARS 视频伪造检测器,采用双路径架构结合多尺度残差与自适应外观特征,在七个数据集上取得最高平均 AUROC,并展现跨类别迁移能力。

AuDiR:用规则与感知干预诊断音频推理失败根源
AuDiR 提出基于规则与感知干预的音频推理诊断框架,通过逐步提供规则和声学观察文本,区分感知失败、规则知识缺失与规则应用失败。初步评估显示 Gemini-3.8-flash 在提供观察文本后准确率大幅提升,揭示感知瓶颈。

GNN规则定价新方法:用互信息精准量化符号规则价值
新研究提出用互信息精确量化符号规则对GNN的价值,将规则设计转化为规则发现,在ZINC数据集上成功发现隐藏环项并超越专家规则,为符号与神经融合提供理论新视角。