#前沿研究
共 6791 篇相关文章
AI聊天机器人正成为说服高手:它们的秘密何在?
AI聊天机器人在改变人们观点方面展现出惊人能力。本文剖析其说服力的来源——海量数据训练、个性化沟通与事实密集论证,并探讨其作为双刃剑的潜在风险与应对之道。
AI灭绝风险与生物武器威胁:真实还是夸大?
AI是否会毁灭人类?《麻省理工科技评论》圆桌活动直面AI生存风险与生物武器威胁议题,解读末日论与现实危害之争,帮助公众理性看待人工智能安全。
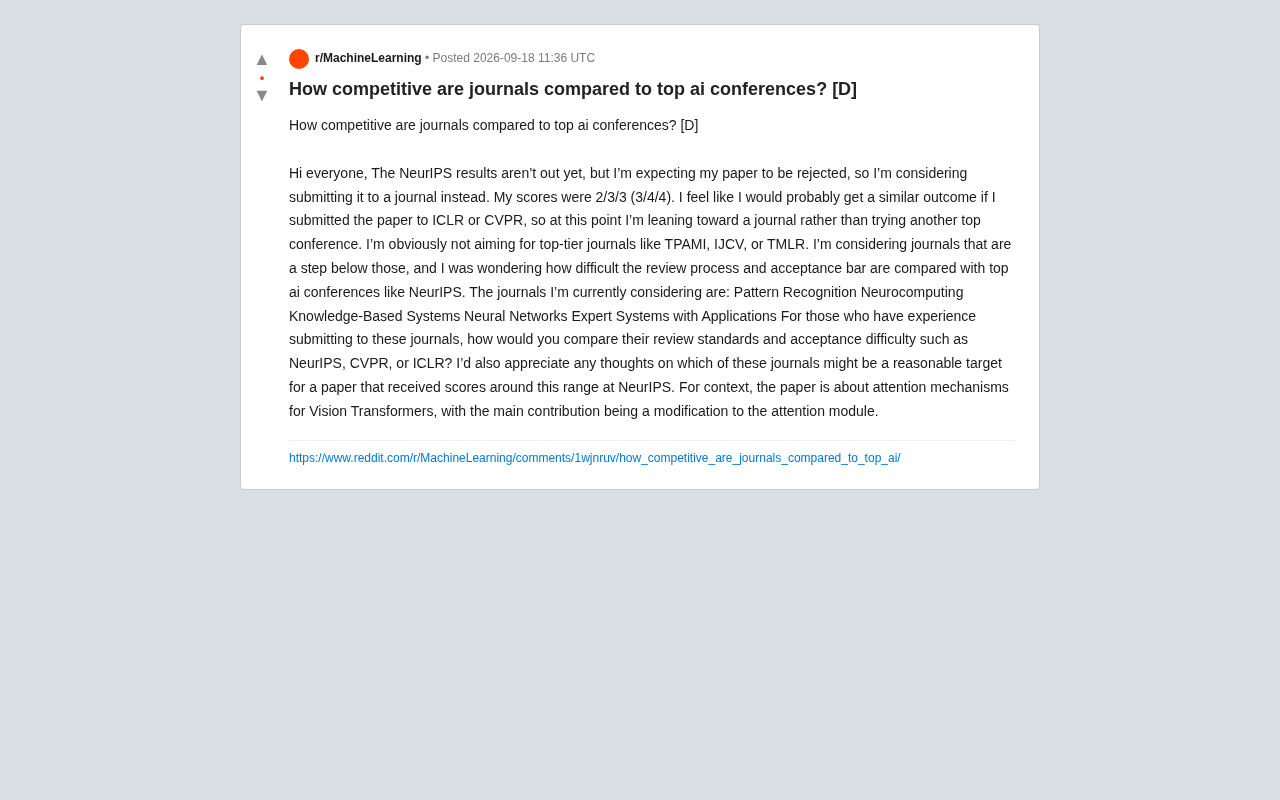
AI期刊 vs 顶会:投稿难度与录用门槛全解析
AI论文被NeurIPS拒稿后该转投期刊吗?本文对比顶会与期刊的评审逻辑差异,解析Pattern Recognition、Neurocomputing、ESWA等五本期刊的录用难度梯度,为研究者提供实用投稿策略。
AI真的会毁灭人类吗?关于AI风险的深度解读
AI真的会毁灭人类吗?本文基于MIT Technology Review资深AI编辑的观点,解析AI生存风险的两派争议,剖析被忽视的当下风险,并给出理性看待AI威胁的实用建议。
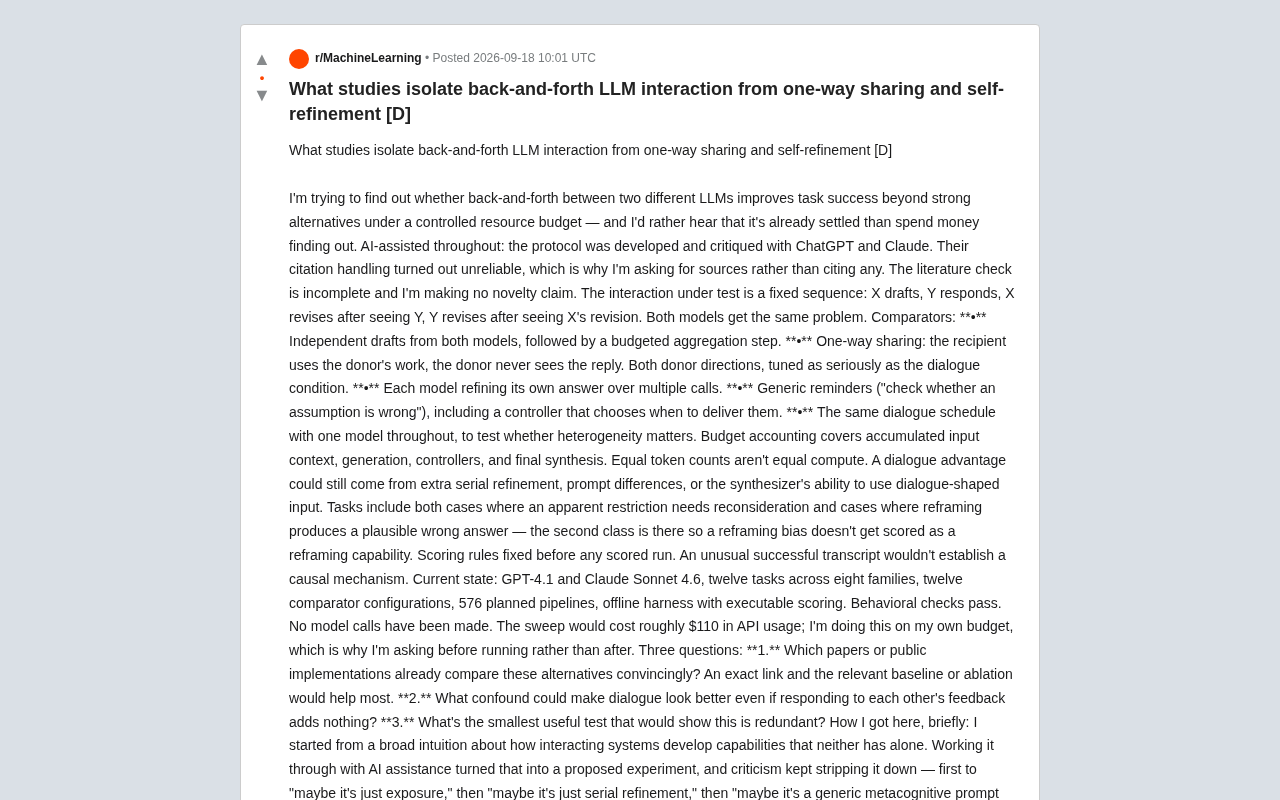
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。
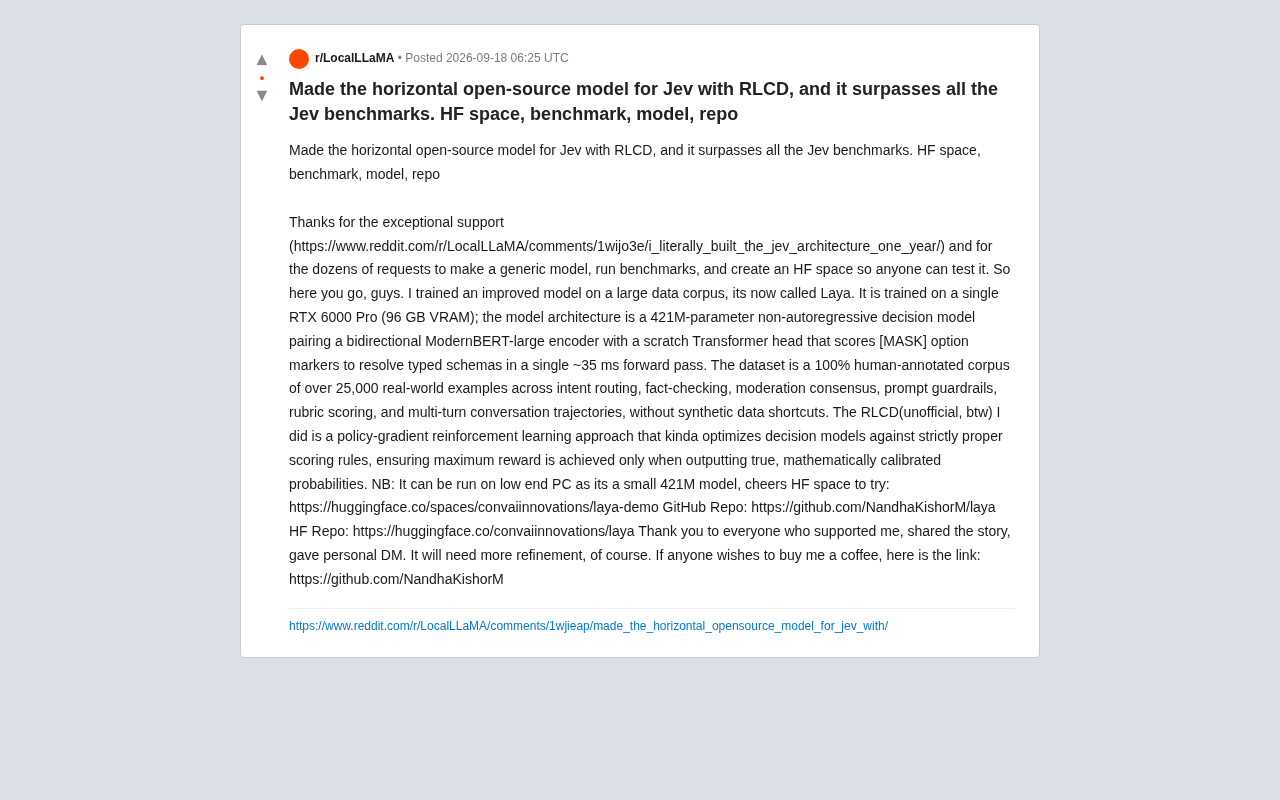
Laya开源决策模型:421M参数如何超越Jev基准测试
开源决策模型Laya基于Jev架构和RLCD强化学习训练,421M参数非自回归设计,可在低端PC运行,35毫秒完成推理,在多项Jev基准测试中实现超越,采用25000条纯人工标注数据。
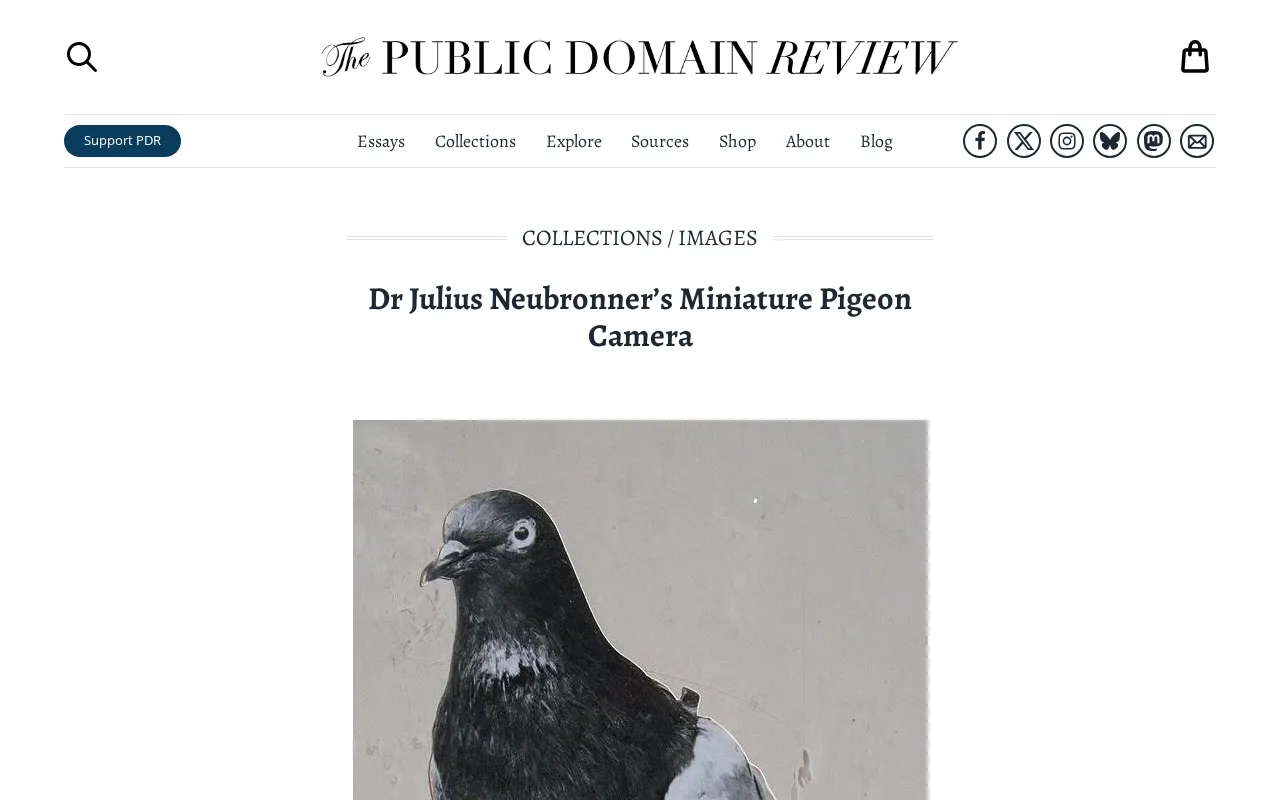
百年前的空中侦察:诺伊布伦纳的微型鸽子相机
德国药剂师诺伊布伦纳发明的微型鸽子相机,是早期航空摄影的传奇尝试。本文解析其工程巧思、军事价值与历史意义,回望人类对空中视角的持续追求。
如何量化评估Agent系统工程质量?六维度评估体系全解析
抛开底层模型能力,如何量化评价Agent系统的工程质量?本文从效果、过程、可靠性、成本、可观测性、安全六大维度,配合每成功任务成本北极星指标、四层评估器与发布门禁飞轮,系统拆解Agent评估体系,工程落地必看。
吴恩达Agent智能体教程精读:如何构建真正有用的Agentic AI应用
深度解读吴恩达Agentic AI智能体教程核心内容:从辨别炒作到掌握Agent工作流的真实应用场景,重点剖析以Evals评估与错误分析为核心的开发方法论,帮助开发者构建真正有用的智能体应用。
彭博社解读:中国AI逼近美国,低价与开源却成变现难题
彭博社专题解读中国AI产业:能力快速逼近美国,凭借低电价、廉价人才和开放权重模型加速追赶,但持续的价格战与低付费意愿让变现成为最大难题。
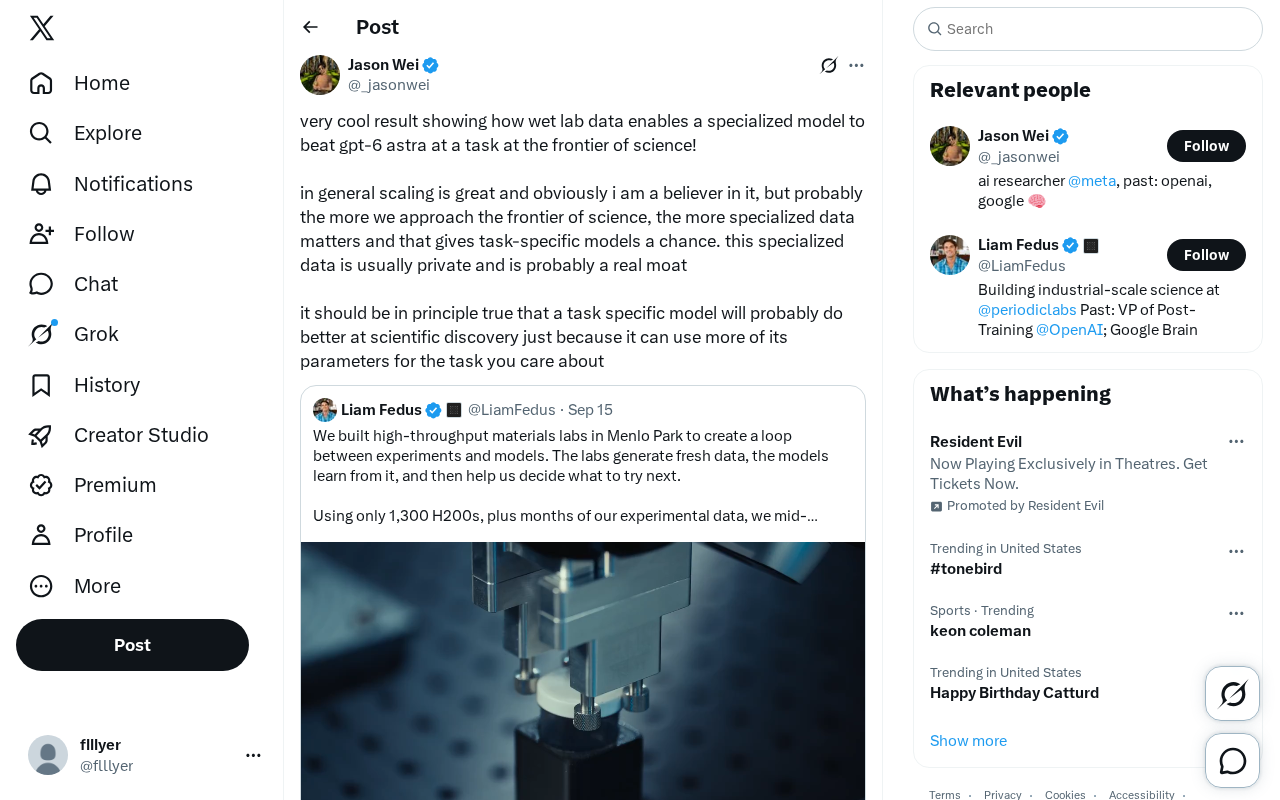
专业模型如何击败GPT-6 Astra:湿实验数据成科学前沿的护城河
一个借助湿实验数据的专业模型击败通用大模型GPT-6 Astra,揭示了科学前沿AI竞争的关键:私有专业数据构成真实护城河,任务专用模型可将更多参数集中于特定任务,在科学发现上超越规模化通用模型。

重访"信任的信任":自修改AI编程工具的投毒风险
从Ken Thompson经典演讲《Reflections on Trusting Trust》出发,探讨自修改AI编程工具面临的投毒风险:训练数据、上下文与自修改回路三大投毒入口,以及可复现构建、沙箱隔离等防御思路。
菲尔兹奖得主为何拒签公开信:一位数学家的独立思考
菲尔兹奖得主 Timothy Gowers 公开撰文解释为何拒绝在同行联名公开信上签名,探讨科学家专业声望、集体表态与个人独立判断之间的张力,对AI时代专家公开信现象亦有深刻启示。
AI赋能生物武器风险浮现:生物科技行业的警钟
Anthropic与OpenAI高管相继警告AI技术风险,其中AI赋能生物武器成为最受关注的威胁场景。本文分析这一风险为何对生物科技行业构成警钟,以及行业应如何在创新与安全间取得平衡。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
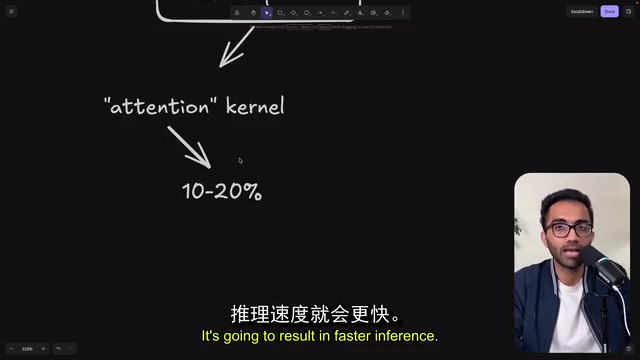
DeepSeek内核工程师自述:被自己训练的AI取代的一年
一位DeepSeek内核工程师在博客中自述:亲手编写V4.1 Flash注意力内核的他,正被自己训练的AI逐步取代。本文解析AI一年内进化为内核大师、模型价格一年半坍缩千倍,以及开发者从工匠到智能体管理者的职业转型与情感冲击。
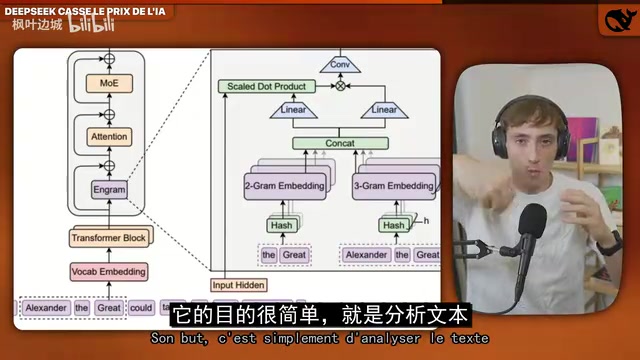
DeepSeek V4.1 Flash深度解析:编码器架构如何把推理成本压到几分钱
DeepSeek V4.1 Flash通过重新引入编码器架构大幅降低推理成本,每任务仅需约0.27美元。本文深度解析其40层架构、KV缓存优化与实测对比,并延伸OpenAI攻克纳维-斯托克斯难题的争议、Anthropic放缓呼吁及Mistral创纪录融资。
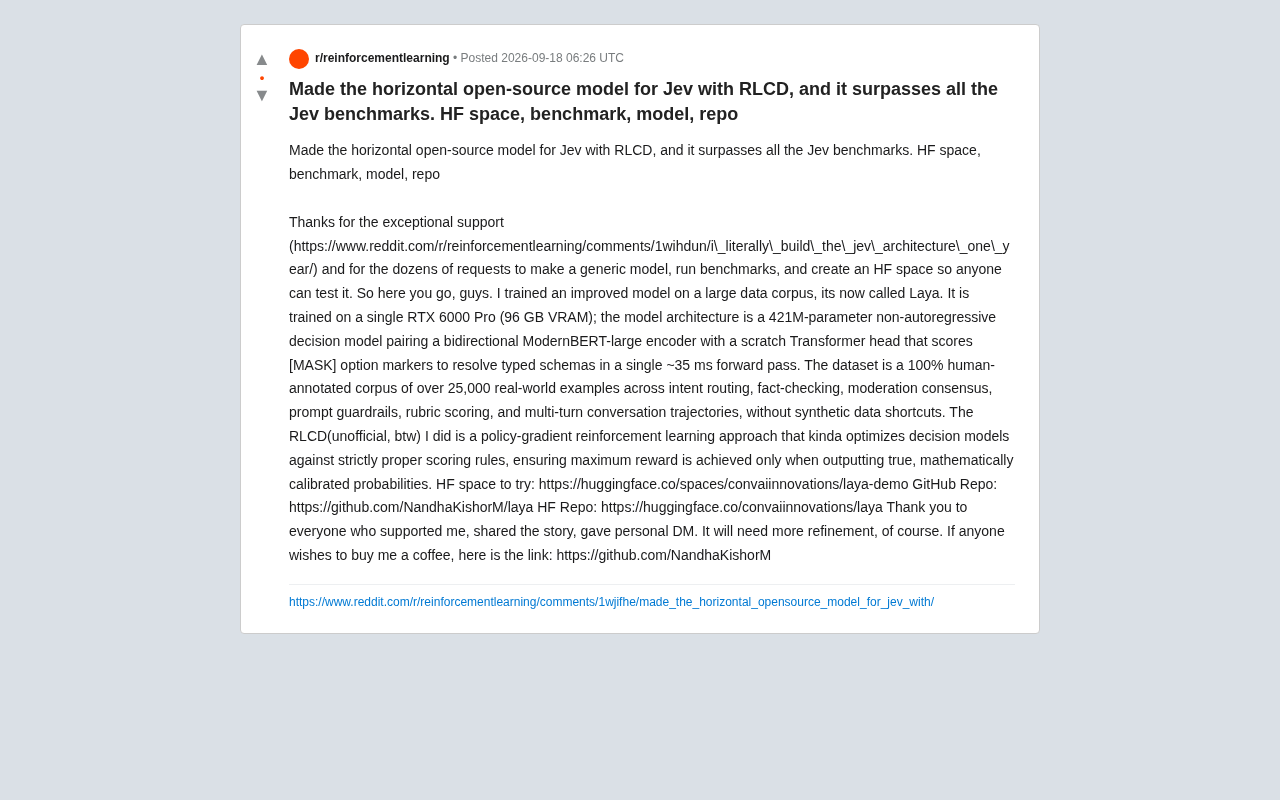
Laya开源决策模型:421M参数用RLCD超越Jev基准
开发者NandhaKishorM推出开源决策模型Laya,采用421M参数非自回归架构,结合ModernBERT编码器与RLCD强化学习方法,在单卡上训练并超越Jev基准。支持意图路由、内容审核等决策任务,约35ms完成推理。