#前沿研究
共 6589 篇相关文章
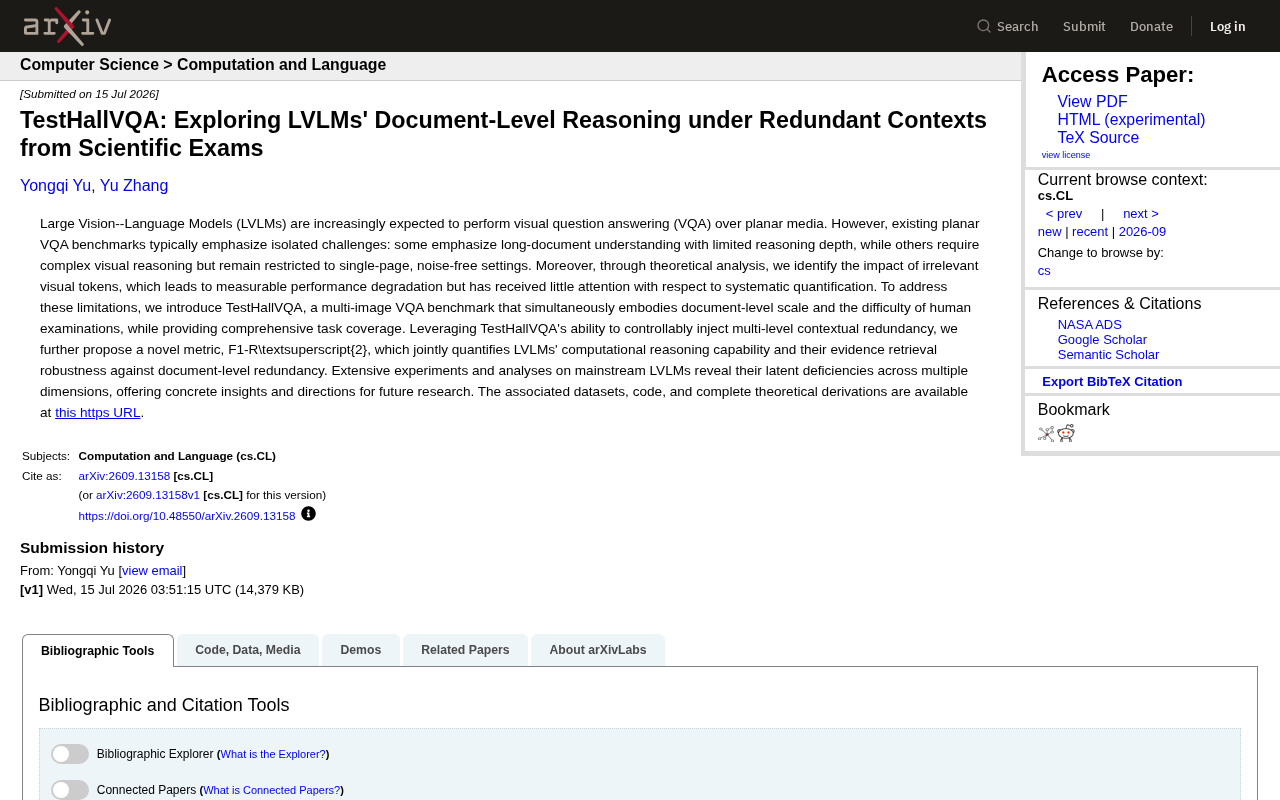
TestHallVQA:冗余上下文下大视觉语言模型的文档级推理新基准
TestHallVQA 是一个面向大视觉语言模型(LVLMs)的多图 VQA 新基准,融合文档级规模与科学考试难度,并提出 F1-R² 指标量化模型在冗余上下文下的推理与证据检索鲁棒性,揭示主流模型的潜在缺陷。
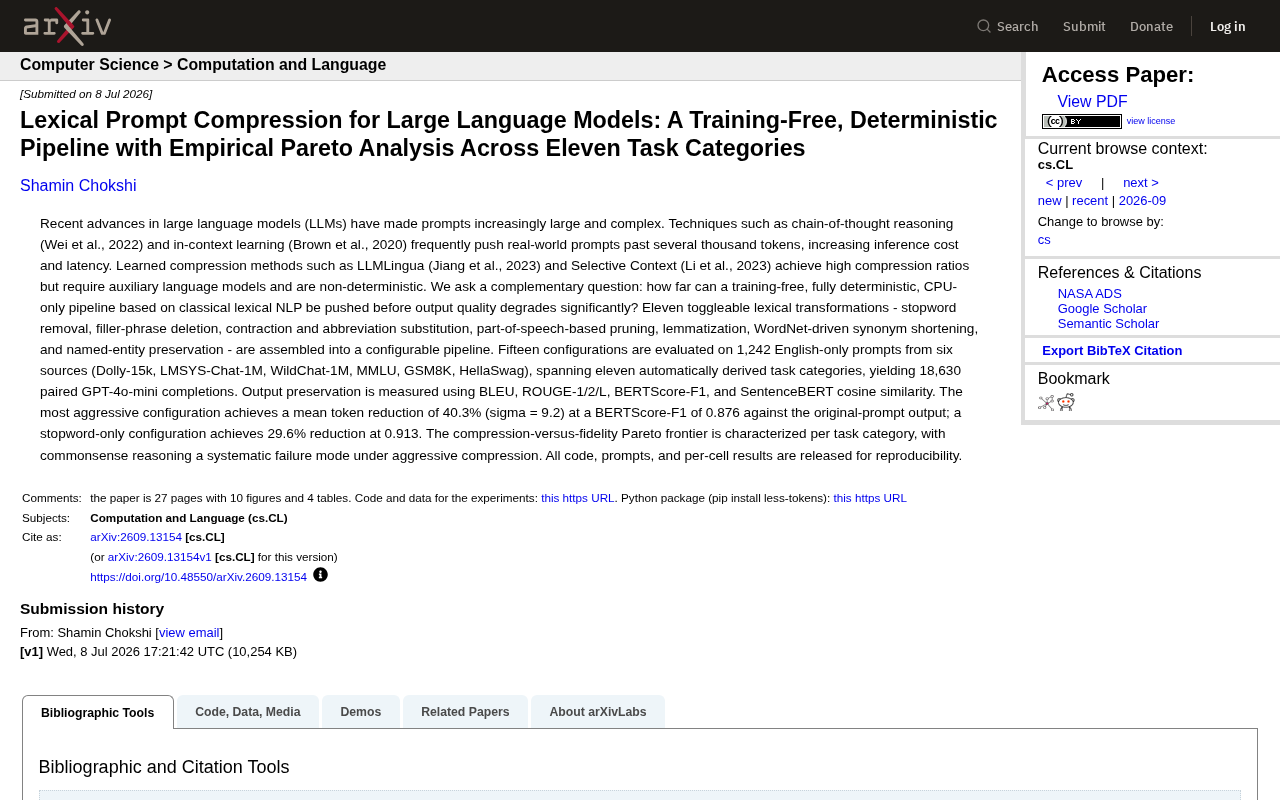
无需训练的Prompt压缩:CPU即可运行的确定性词法方案
arXiv新研究提出无需训练、纯CPU运行的确定性Prompt压缩管线,通过十一种词法变换在1242条Prompt上实证:最激进配置削减40.3%token,仅停用词方案保真度达0.913,并揭示常识推理为激进压缩下的系统性失效点。

PhysMent:用交互式物理仿真评测大模型的物理推理能力
PhysMent 是一个基于 MuJoCo 仿真器的交互式基准测试,通过施力、观测、推进时间等工具调用评测大语言模型的物理推理能力。研究发现模型在定性任务表现尚可,但定量多步实验任务准确率骤降,瓶颈在于流程性工具使用而非物理知识本身。
Token Merging:让多语种语音识别更快更省的实用方案
一项 arXiv 研究系统评测了 Token Merging 词元合并技术在 Whisper 多语种语音识别上的效果,覆盖 16 种语言与 3 种模型规模,证明它能在几乎不损失准确率的前提下大幅提升推理效率,且与 DoRA 微调兼容。
OrchSLM:小语言模型协同编排的机制探究
OrchSLM 是一个用于探究小语言模型(SLM)非交互式协同编排机制的路由框架,将编排的设计选择转化为可控参数,系统分析任务结构、模型池组成与多智能体共识如何影响编排行为,为 agentic 系统部署提供新视角。

机器速度下的AI治理:AGIL自适应架构解析
arXiv论文提出AGIL自适应治理智能层,一个五层架构用机器学习实现实时AI政策执行。文章解析企业AI治理中的"认证赤字"问题,及基于斯坦福AI Index等三份权威报告的数据洞察。
AI智能体故障归因:把根因分析变成一个搜索问题
arXiv新论文提出Continual Search框架,将AI智能体的根因归因重新定义为搜索问题,通过多轮迭代让LLM持续追查故障证据。在MegaRCA-Mix基准上将GPT-5.5的F1分数提升超40%,且低配模型可超越高配模型。
LabAgent:为科研实验室打造可复现的AI智能体系统
arXiv新论文提出LabAgent,一套面向科研实验室的AI智能体系统,通过可执行验证和经验记录两大机制解决科研方法传承难题,在药物预测、蛋白质变异等生命科学领域超越通用智能体。

TimeThink:让时序大模型学会组合式推理的合成框架
TimeThink 是一个用于激发时序大模型组合式推理能力的合成框架,通过确定性生成可验证的问答数据与 RLVR 训练策略,仅用合成数据即在真实基准上超越强基线,为医疗等高风险场景的可解释时序推理提供新思路。

自适应物理AI探索:LLM智能体能否胜任长周期物理任务?
最新arXiv论文探讨LLM智能体能否管理长周期物理任务。研究通过整合规划、工具调用、观察与验证的多智能体框架,在农业场景中对比零样本LLM与强化学习智能体,发现LLM在环境变化时具备更强的自适应能力。
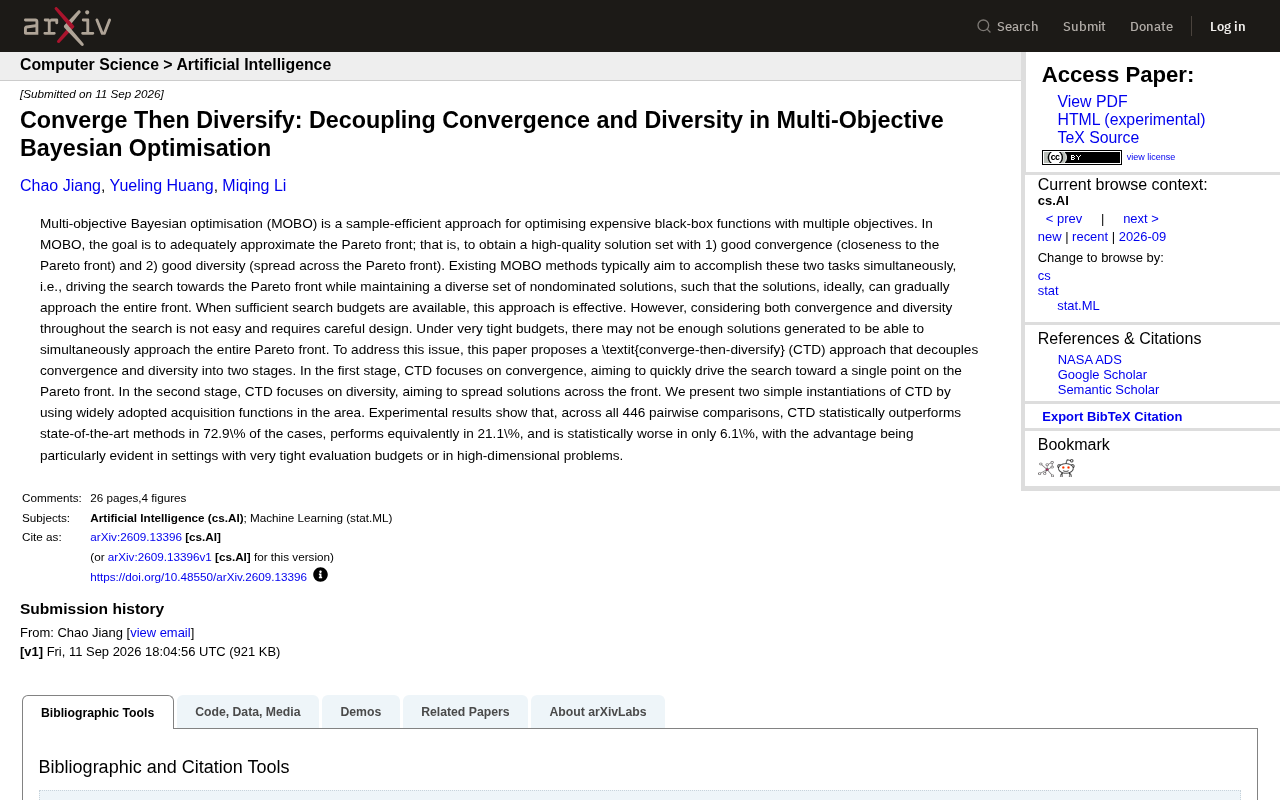
先收敛后多样化:多目标贝叶斯优化的CTD新范式
arXiv新研究提出Converge-Then-Diversify(CTD)方法,将多目标贝叶斯优化中的收敛与多样性解耦为两个阶段。在446次对比中72.9%显著胜出,尤其在紧预算和高维问题中优势明显。

Vibe Patenting:LLM评审员能胜任专利撰写评估吗?
arXiv最新研究通过Vibe Patenting测试平台,评估LLM评审员在专利撰写这类专业任务中的可靠性。研究发现评审反馈能让低成本智能体逼近高端模型,但AI评审与人类专利律师的一致性强烈依赖具体指标。
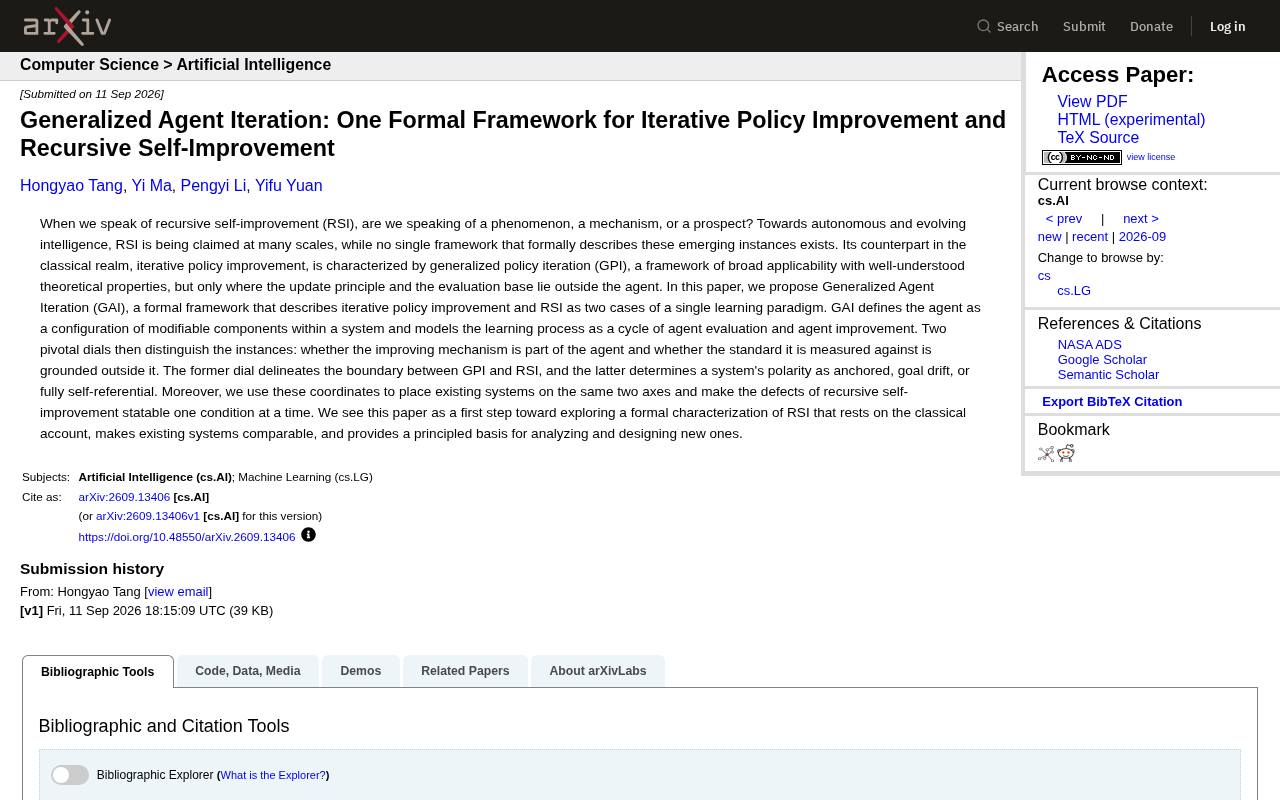
GAI框架:统一迭代策略改进与递归自我改进的形式化理论
arXiv 新论文提出广义智能体迭代(GAI)框架,将经典迭代策略改进(GPI)与递归自我改进(RSI)统一为同一学习范式,用两个关键维度区分系统类型,为分析和设计自我改进 AI 提供形式化基础。
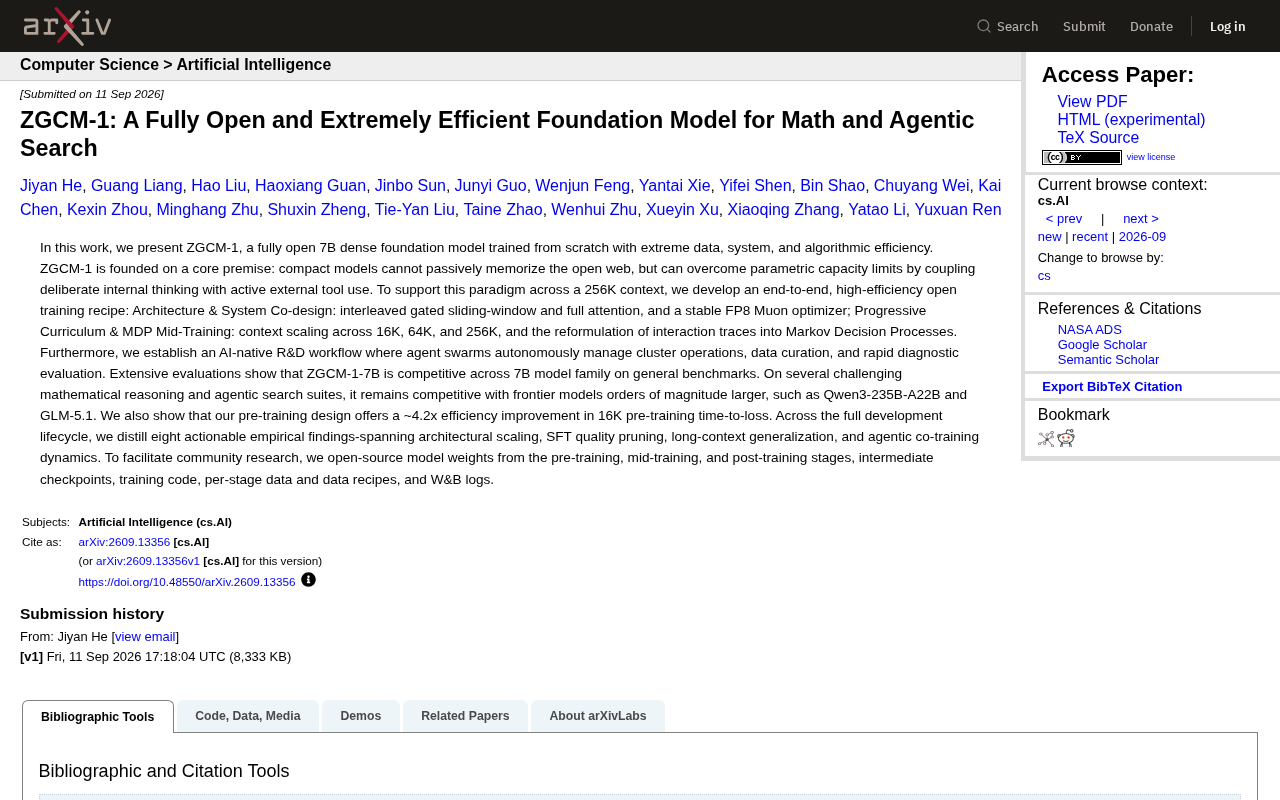
ZGCM-1:7B全开源模型如何用工具调用挑战千亿级大模型
ZGCM-1 是一个完全开源的 7B 稠密基础模型,通过耦合内部思考与外部工具调用,在数学推理和智能体搜索任务上媲美 Qwen3-235B、GLM-5.1 等超大模型,并公开全流程权重、代码与数据配方。

谁在攻击AI巨头?一家以色列公司引发的争议
一家标榜有效利他主义理念的以色列公司被指涉及针对OpenAI、Anthropic和Meta的网络攻击。本文分析事件背景、AI企业安全风险及有效利他主义与AI安全的复杂关系。
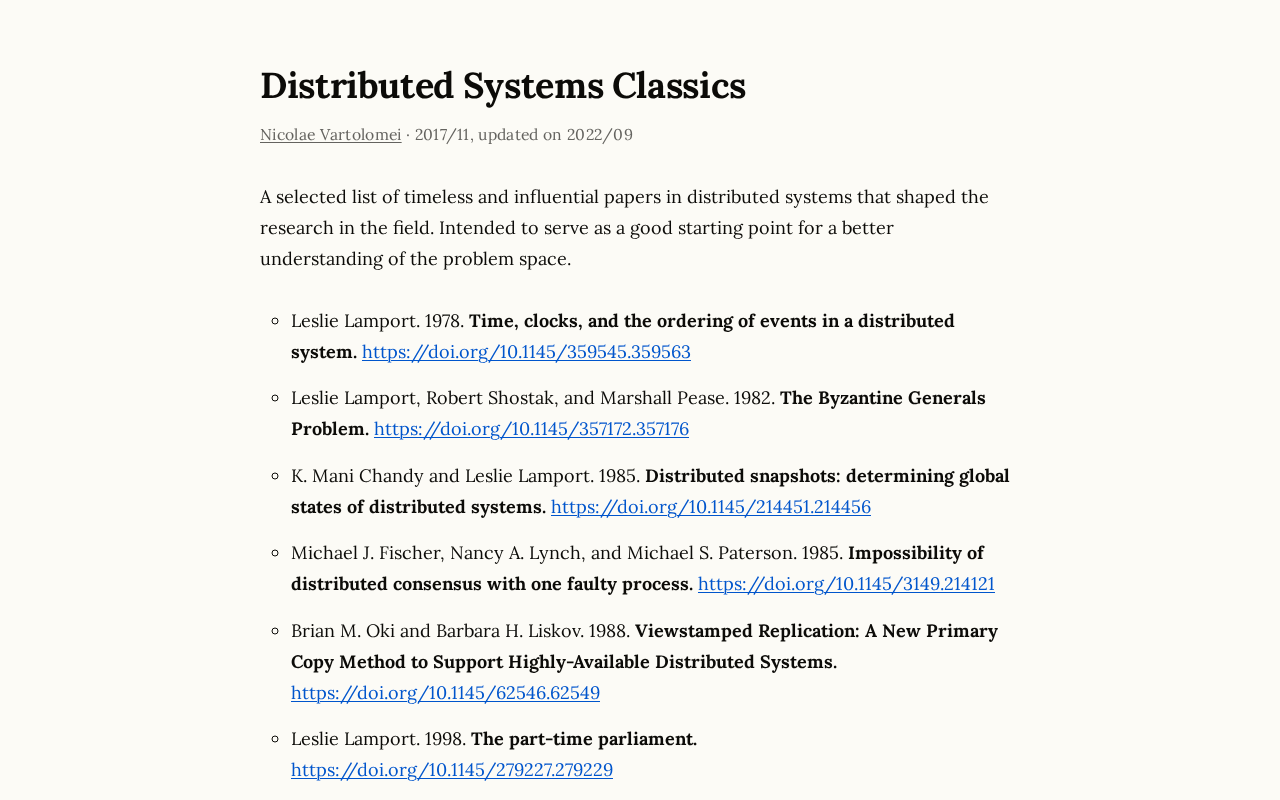
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。
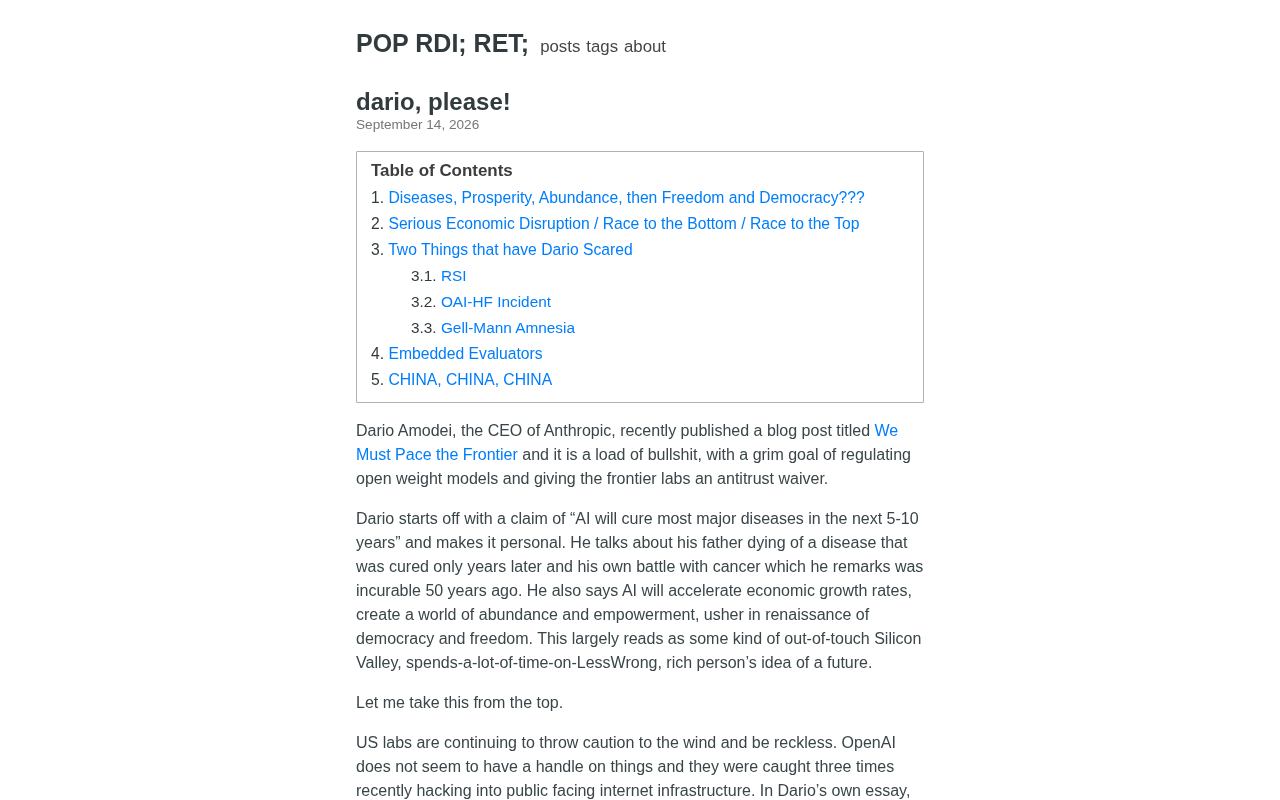
"Dario, Please":一封写给Anthropic CEO的公开呼吁引发热议
《Dario, Please》一文在Hacker News引发热议,累计247分与122条评论。这封写给Anthropic CEO Dario Amodei的公开呼吁,折射出AI社区对头部大模型公司决策方向的持续关切与话语生态变化。
vLLM 全栈优化实战:如何应对真实 Agent 流量的服务压力
vLLM 全栈优化实战:如何应对真实 Agent 流量的服务压力
vLLM 团队发布全栈优化博客,针对真实 Agent 流量对推理服务栈的压力,从架构、框架到运行时协同优化,并在 SemiAnalysis 的 AgentX 公开基准上进行测量。本文解析其优化思路与工程启示。