#前沿研究
共 6589 篇相关文章

OpenAI斥资打造生物数据:破解医学AI的数据饥渴
OpenAI正出资打造生物学数据以突破医学AI的数据瓶颈。从破产生物科技企业竞标获取监管与安全数据,到主动付费生成高质量数据,本文剖析AI进军生物医学领域的数据竞赛新趋势。

AI末日论转向:当行业领袖集体谈论技术威胁
Anthropic、OpenAI、xAI 与 DeepMind 的领袖为何集体谈论 AI 风险?本文解读 AI 行业的"末日论"转向、举报型智能体等前沿治理议题及其背后动因。

谷歌ATLAS发布:AI经济影响全球数据可视化平台
谷歌推出ATLAS开放访问平台,将AI与经济研究中的数百万全球数据点转化为交互式可视化体验,为研究者、政策制定者提供理解AI经济影响的公开工具。
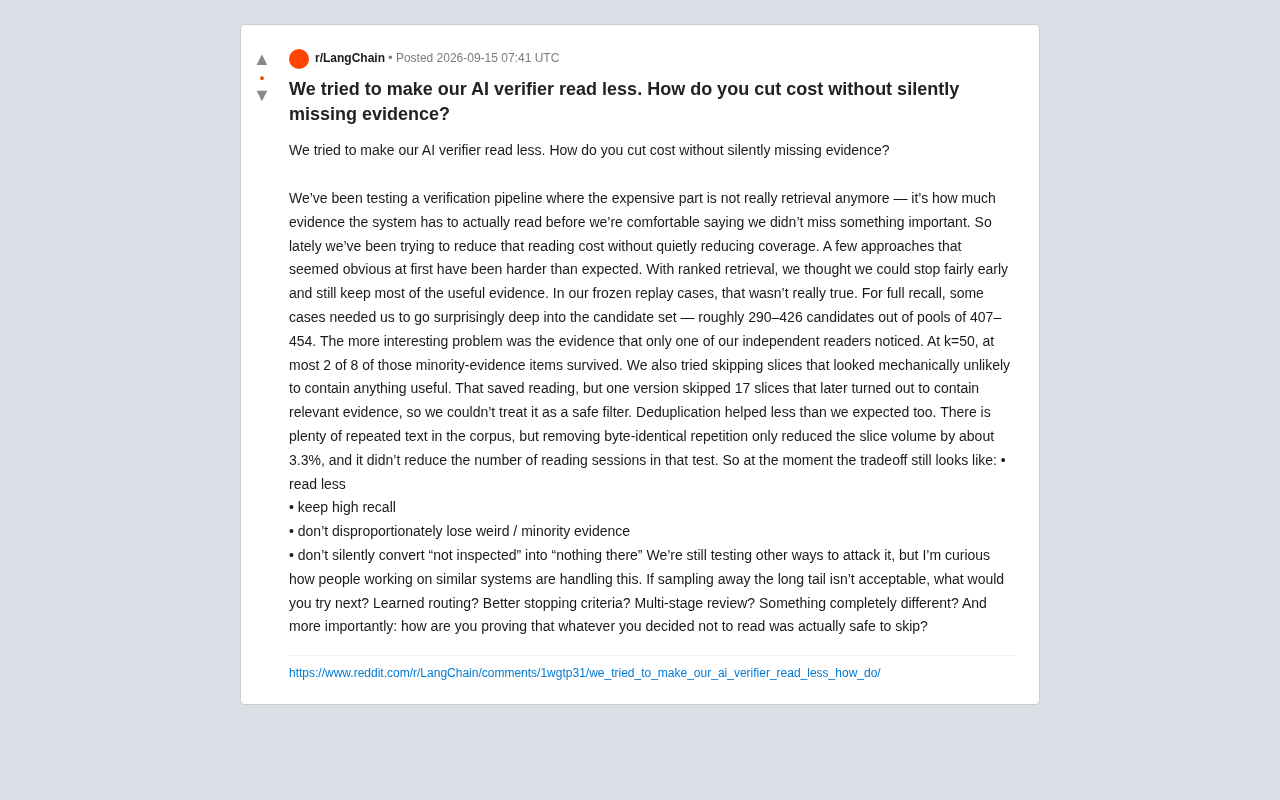
AI验证系统降本困局:如何少读证据又不漏掉关键信息
AI验证系统的真正成本不在检索而在阅读证据量。本文剖析一个RAG验证流水线的降本实践:提前停止、跳过切片、去重为何收效甚微,以及如何在保持高召回率的同时不漏掉少数派证据这一核心难题。
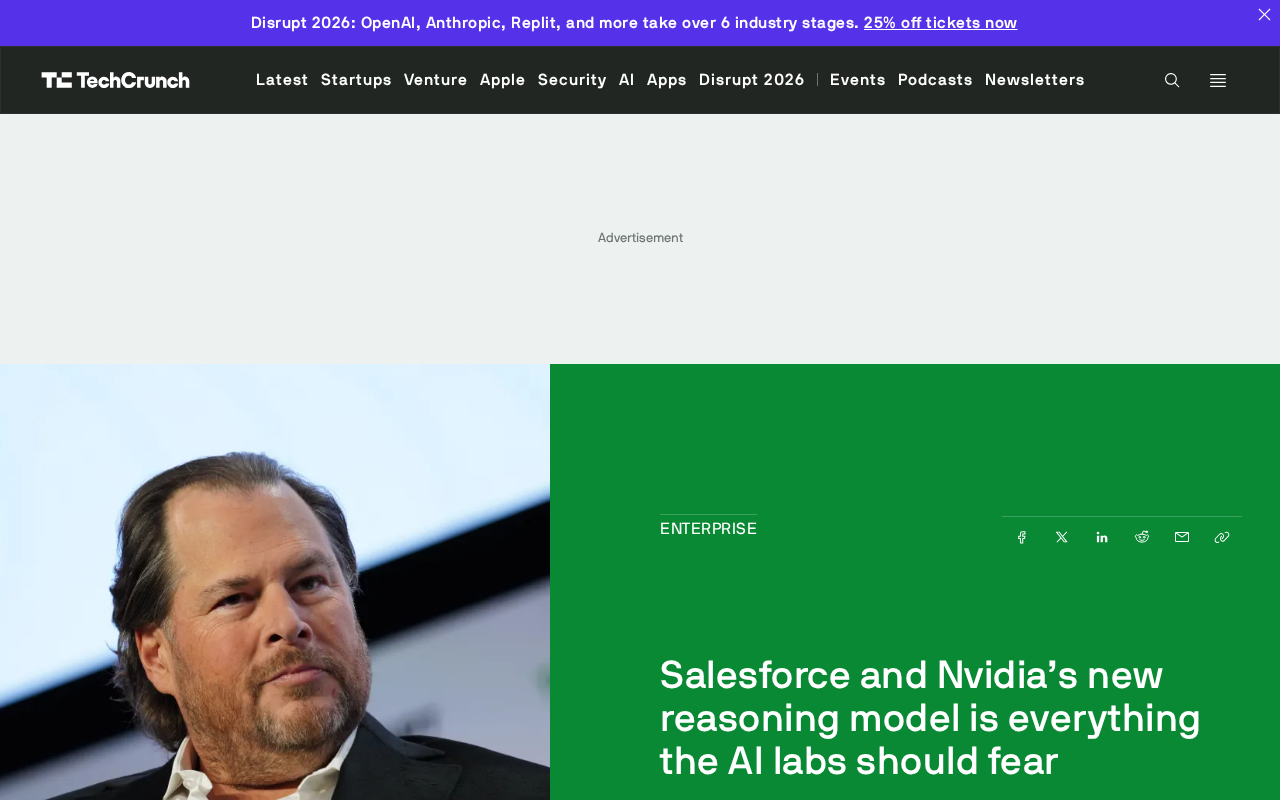
Salesforce联手英伟达推Koa模型:企业AI的开源突围
Salesforce与英伟达联合推出基于开放权重模型Nemotron的推理模型Koa,专注销售、营销和客服场景。本文分析这一垂直化AI策略为何值得通用大模型实验室警惕,以及它对行业格局的启示。
H3加速竞技场新增三款模型:社区众测AI性能
H3加速竞技场新增VDN-H3、TaoMate H3、LightX2V 1.2三款模型,通过社区投票对比新旧模型加速表现。本文解析众测评测机制及其参考价值。
Claude Opus 5用JavaScript逐帧生成动画,AI代码能力再进阶
Reddit 上一段演示显示 Claude Opus 5 用 JavaScript 逐帧生成动画。本文解析 AI 通过代码创作动态内容的意义、能力边界,以及如何理性看待社区演示。
AI与数学的新起点:Daniel Litt的深度思考
数学家 Daniel Litt 发表博客《A beginning for mathematics》引发 Hacker News 热议。本文解读 AI 与数学交叉领域的范式变革,探讨形式化证明、自动推理对数学研究本质的影响与学界分歧。
Voodoo Dynamic Quant开源:用梯度下降优化模型量化
开发者开源动态量化方法 Voodoo Dynamic Quant,采用 MIT 协议。它用梯度下降优化 GGUF 模型的逐张量量化布局,在激进低比特档位优于 Unsloth Dynamic 3.0,为低显存本地部署提供新工具。
Perplexity揭秘:支撑AI搜索的嵌入与排序模型服务架构
Perplexity公布AI搜索底层技术研究,揭示支撑嵌入与排序模型的业界领先服务基础设施,解析检索增强生成中检索与排序环节如何决定回答质量与响应速度。
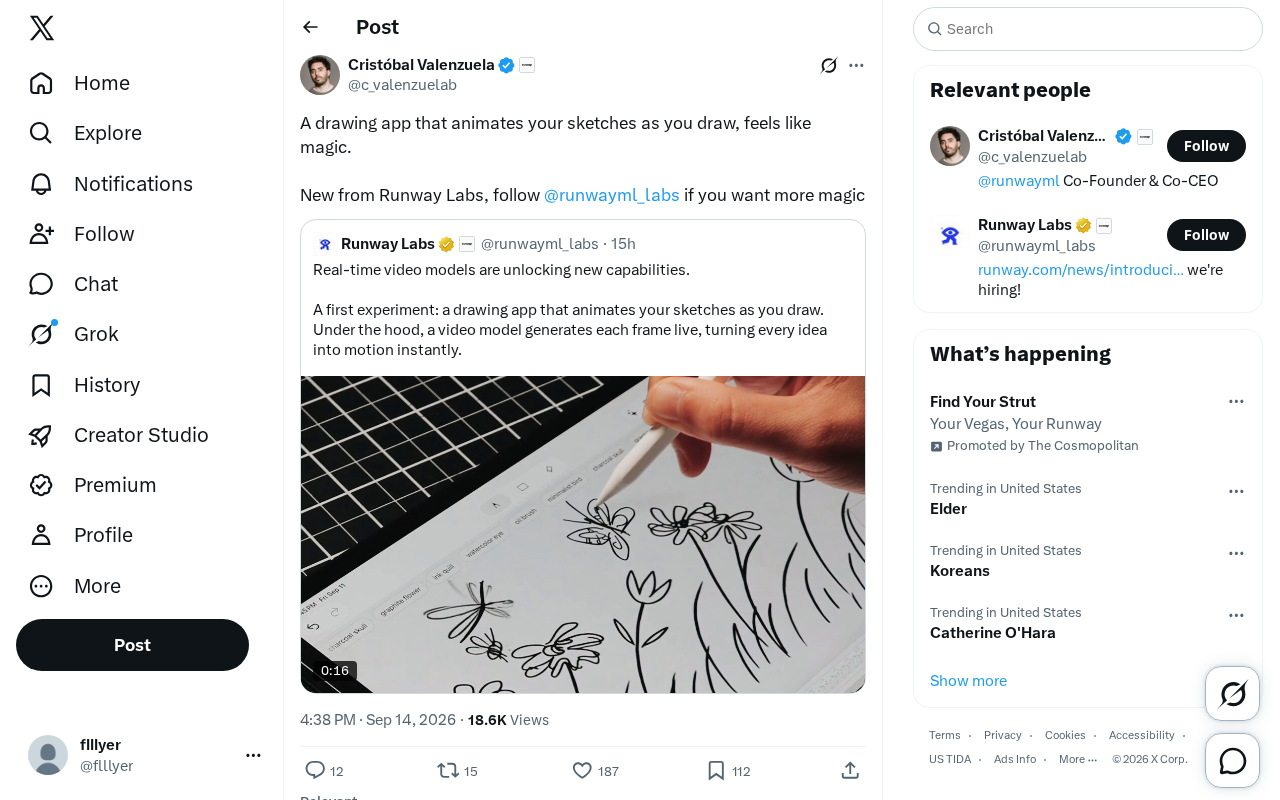
Runway Labs 新推绘画应用:边画边动的AI创作魔法
Runway Labs 推出一款可边画边动的 AI 绘画应用,能在绘制草图的同时将其转化为动态画面。本文解析这款实时生成工具的亮点、背后趋势及对创作者的意义。
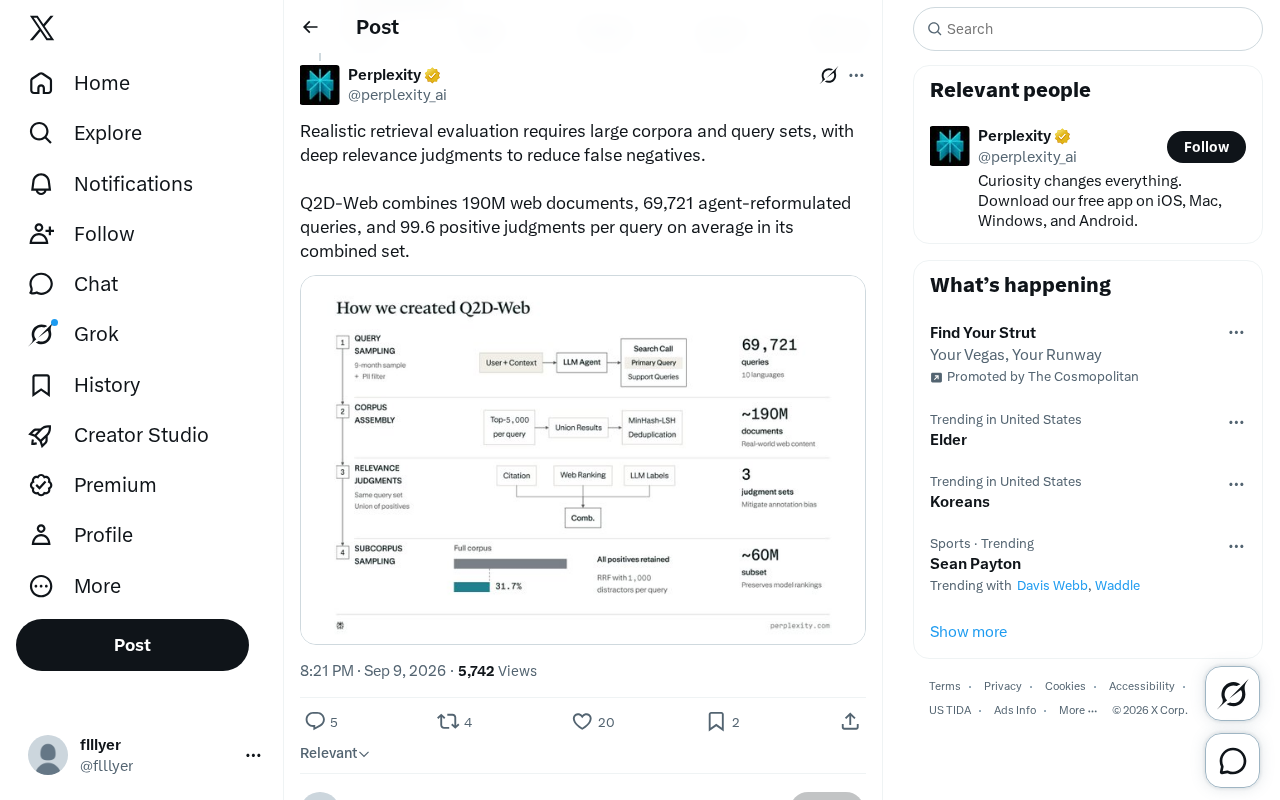
Q2D-Web:用1.9亿网页重构检索评测的真实性标准
Q2D-Web 检索评测数据集结合 1.9 亿网页文档、6.9 万条 agent 重构查询与平均每查询 99.6 个正相关判断,通过大规模语料与深度相关性标注减少假阴性,为检索与 RAG 研究提供更真实的评测基准。
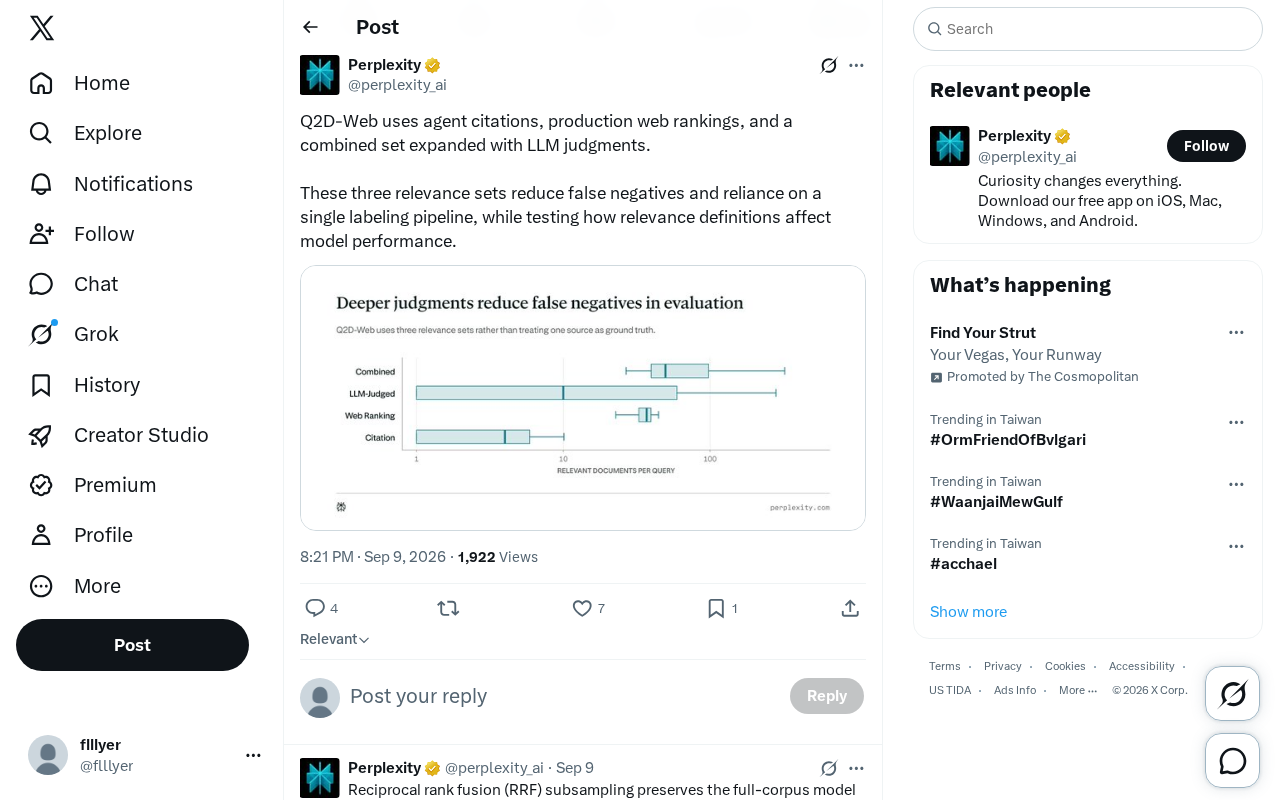
Q2D-Web:多重相关性标注如何重塑检索评测
Q2D-Web 采用智能体引用、生产网页排名与 LLM 扩展的三套相关性集合,减少检索评测中的假阴性和单一标注依赖,并检验相关性定义如何影响模型表现。
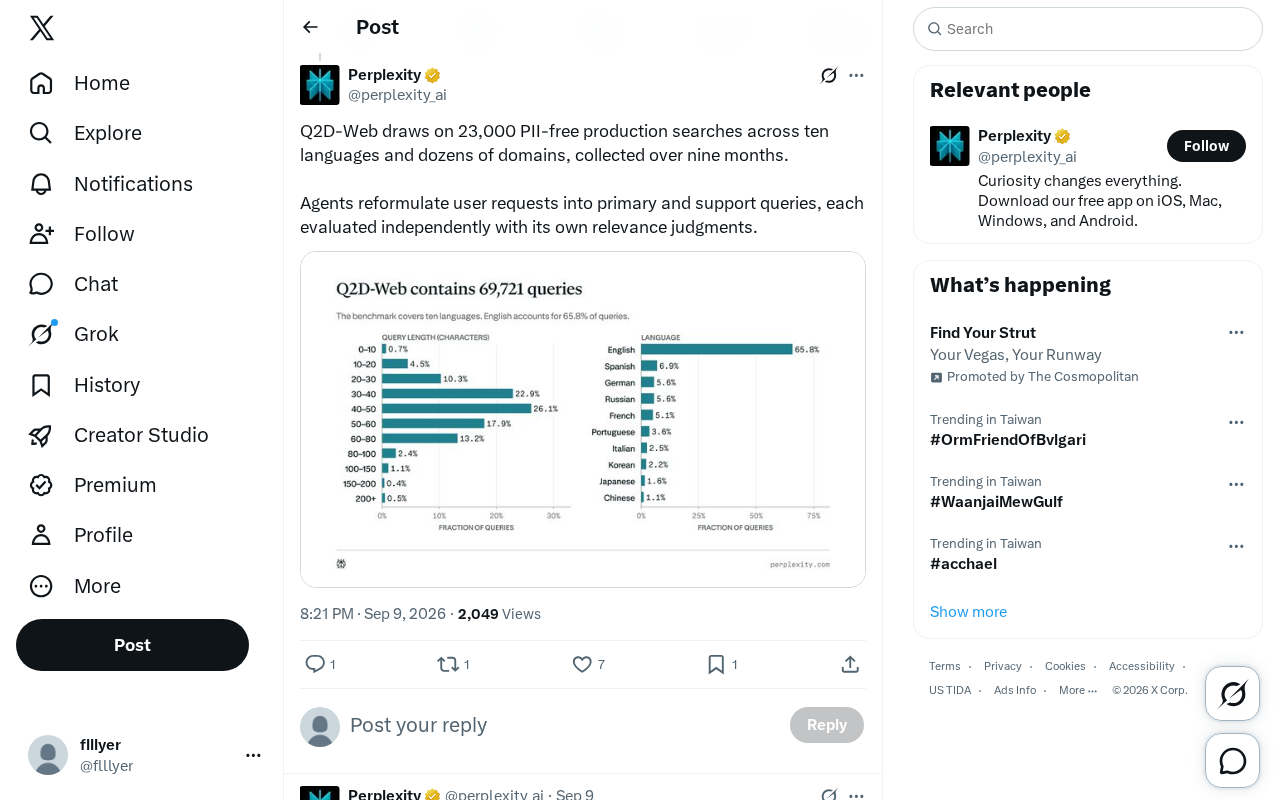
Q2D-Web数据集:23000条真实搜索背后的Agent查询重构评测
Q2D-Web数据集汇集23000条无PII生产搜索,覆盖十种语言和数十个领域,历时九个月采集。它通过将用户请求重构为主查询与支持查询并独立评估相关性,为检索式Agent的查询重构能力提供了贴近真实的评测基准。
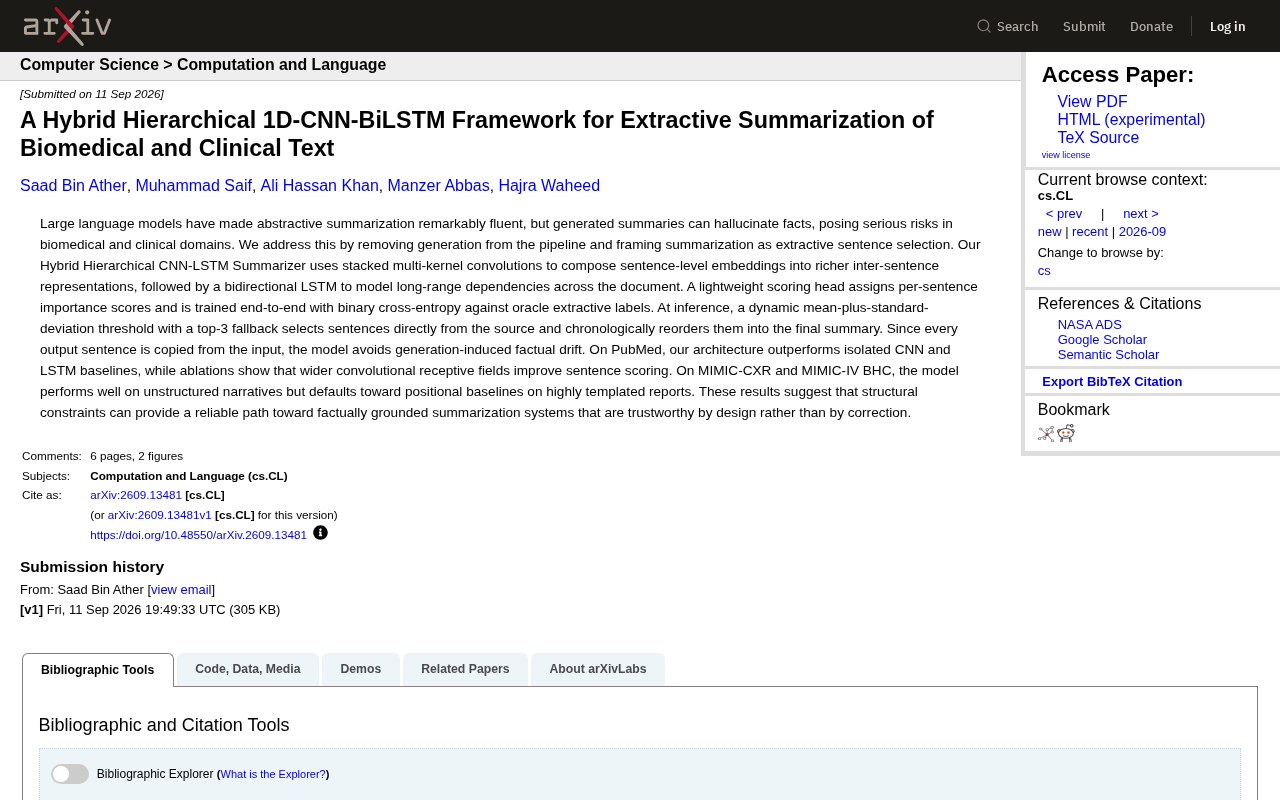
抽取式摘要新框架:CNN-BiLSTM如何解决医疗文本的事实幻觉难题
一篇arXiv论文提出Hybrid Hierarchical CNN-BiLSTM抽取式摘要框架,通过移除生成环节、直接从原文选句,解决生物医学与临床文本的事实幻觉难题,在PubMed、MIMIC等数据集上验证效果与局限。
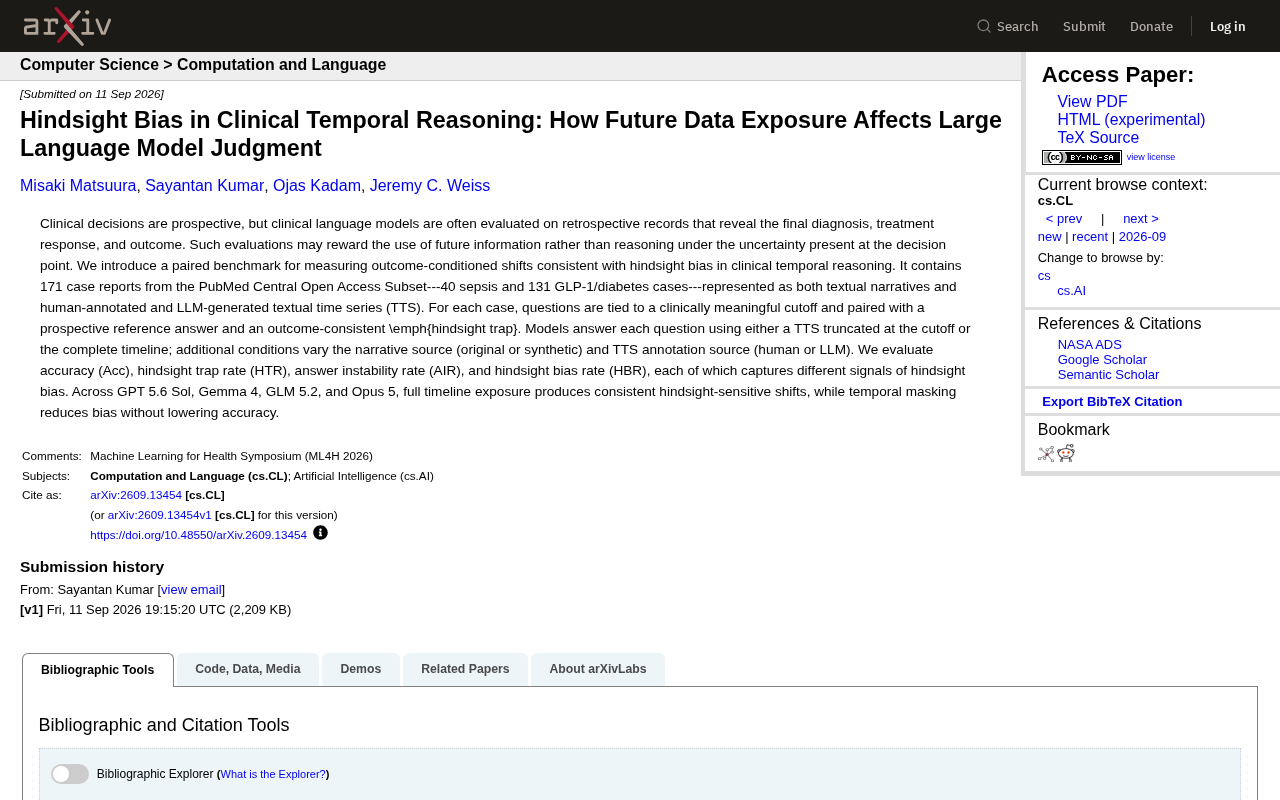
临床时序推理中的后见之明偏差:未来数据如何扭曲大模型判断
arXiv最新研究揭示临床语言模型的后见之明偏差:当模型接触包含结局的完整时间线时会产生系统性判断偏移,而时间遮蔽能在不降低准确率的前提下减少偏差。文章解析171病例配对基准与四项评估指标。
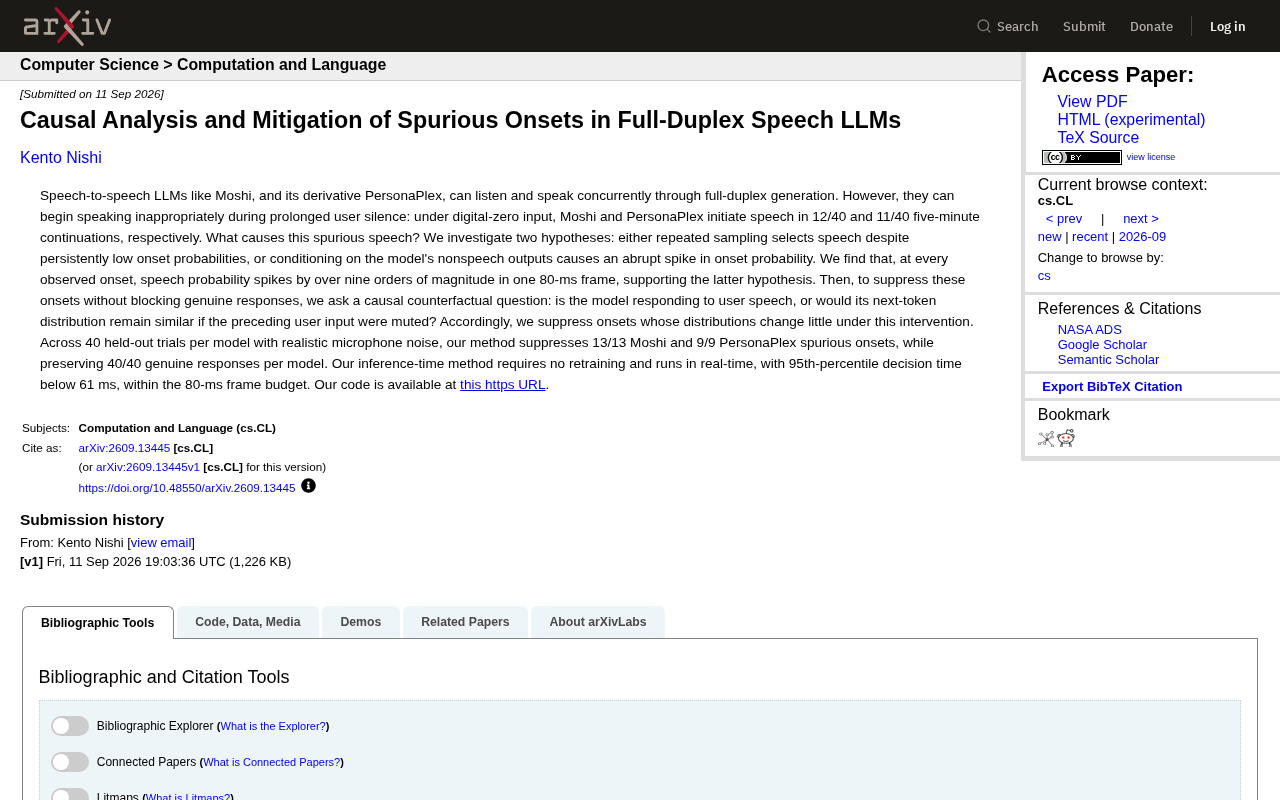
全双工语音大模型的"抢话"难题:因果分析与实时抑制方法
全双工语音大模型 Moshi 和 PersonaPlex 在用户沉默时会不当开口。本文解析虚假开口的因果成因,介绍一种基于反事实干预、无需重训练、可实时运行的抑制方法,实测完美抑制虚假发声并保留真实回应。
CVSS-X:覆盖28种语言的大规模语音翻译语料库
CVSS-X 是一个覆盖 28 种语言、12 个语系的大规模合成语音到语音翻译语料库,总时长超 16000 小时,是原始 CVSS 的八倍,支持双向多语言语音翻译研究,已开源发布。