#前沿研究
共 6589 篇相关文章
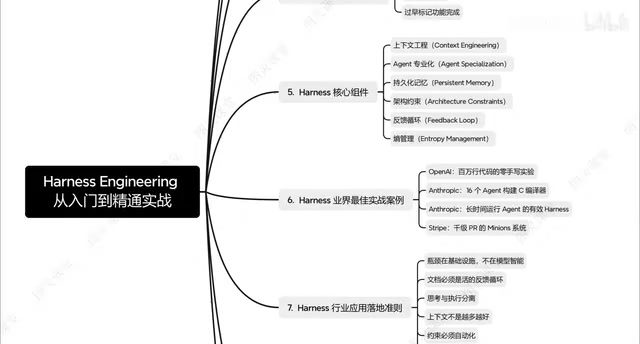
Harness Engineering入门到实战:多Agent项目开发全解析
本文解析B站Harness Engineering系列教程,涵盖AI工程范式三阶段演进、Agent失败模式、信息层/约束层/自动化三层架构,以及基于Java的多Agent项目实战与落地清单。
Qwen3 Max最新版实测:分数升了,为何有的能力反降?
海外博主实测阿里 Qwen3 Max 最新 0902 检查点:整体跑分升至 86.25% 登榜单第三,却在电梯、弓箭等前端交互题上退步,全靠一道 3D 手表题的首个满分拉动。附与 Gemini 3.8 Flash、Muse Spark 1.3 的横向对比。
从零理解AI大模型:概念、技术脉络与普通人的机会
从零理解AI大模型:厘清人工智能、机器学习、深度学习、Transformer与生成式AI的发展脉络,解析深蓝、AlphaGo、ChatGPT等关键节点,以及普通人如何切入大模型应用领域。

NVLink 6 多层容错:NVIDIA如何保障AI工厂持续算力
NVIDIA NVLink 6 通过多层容错机制为大规模AI工厂提供持续算力保障。本文解析其链路冗余、故障隔离与系统监测的分层设计,以及对超大规模AI训练可用性的实际意义。

确定性执行如何驱动高能效AI推理:解读Groq LPX与NVIDIA平台协同
NVIDIA开发者博客解析Groq LPX确定性执行架构如何在电力受限的AI工厂中驱动高能效、高交互性推理,探讨专用加速器与NVIDIA平台协同的能效新范式。
谷歌发布 Gemini 3.8 Live:语音 AI 迈向实时推理时代
谷歌发布 Gemini 3.8 Live 与 3.8 Live Extended Thinking 两款实时语音对话模型,支持并行推理、后台任务执行、97 种语言实时切换与视觉理解,并在语音质量与智能体任务基准中领先。本文解析其核心能力与生态布局。

稠密模型 vs MoE:激活参数、吞吐量与选型指南
深入解析稠密模型与 MoE 混合专家模型的核心区别:激活参数、总参数、吞吐量各有何差异?结合 NVIDIA Nemotron 3.5 Lightning 案例,给出实用的模型选型建议。

AI造福社会:技术突破如何普惠每个人
AI技术突破如何普惠每个人?本文探讨专家与本地社区领袖如何借助AI推动社会影响力,让技术红利惠及更广泛人群,涵盖医疗健康等重点应用领域及AI向善的行业趋势。

OpenAI、Anthropic与谷歌密谈AI安全数周,政策博弈浮现
OpenAI确认与Anthropic、谷歌DeepMind就AI安全议题密谈数周,而特朗普团队淡化安全顾虑、主张与中国竞速。本文解析AI企业协作与政策分歧背后的博弈逻辑。

大规模监控25年反思:安全与隐私的博弈
安全专家 Bruce Schneier 发文反思25年来的大规模监控,探讨国家安全与个人隐私的博弈。文章分析监控的技术逻辑、社会代价,以及 AI 时代下隐私保护面临的新挑战与应对路径。
AI加速科学发现:从医疗到生活的真实影响
AI的真正价值在于服务于人。本文探讨AI如何加速科学发现、改善医疗与日常生活,以及应如何理性看待科技公司的AI造福人类愿景。

GRP-Obliteration:单个提示词即可解除大模型安全对齐
GRP-Obliteration 宣称仅用单个未标注提示词即可解除大模型的安全对齐。本文解析其核心思路、对开源模型安全的启示,以及在信息有限下如何理性看待这类权重级去对齐攻击。

形式化方法能否驯服AI智能体?OpenShell的实践启示
OpenShell团队分享将形式化方法应用于AI智能体控制的实践经验。本文解析形式化验证如何为AI Agent提供可证明的安全约束,探讨规范定义、灵活性权衡与运行时验证等关键挑战及行业意义。
CSS Zen Garden的理想终成现实?聊聊内容与样式分离
Hacker News 热帖「The CSS Zen Garden dream shipped」引发讨论。本文回顾 CSS Zen Garden 内容与样式分离的设计理想,分析现代 CSS 如何让这一梦想落地,以及组件化时代理想与现实之间的张力。
开源AI落后前沿模型仅4.4个月:差距正在缩小
开源AI落后前沿模型仅4.4个月:差距正在缩小
一份《State of Open Source》报告指出开源AI模型平均仅落后前沿闭源模型4.4个月。本文解读这一时间差指标的意义、背后驱动力,以及它对企业、开发者与闭源实验室的影响。
谷歌又一AI安全研究员离职:警告"我们可能都要死"
谷歌又一位AI安全研究员离职并发出"人类可能面临灭绝"的极端警告,本文解析此类离职背后的行业张力、存在性风险争论以及AI治理的深层挑战。
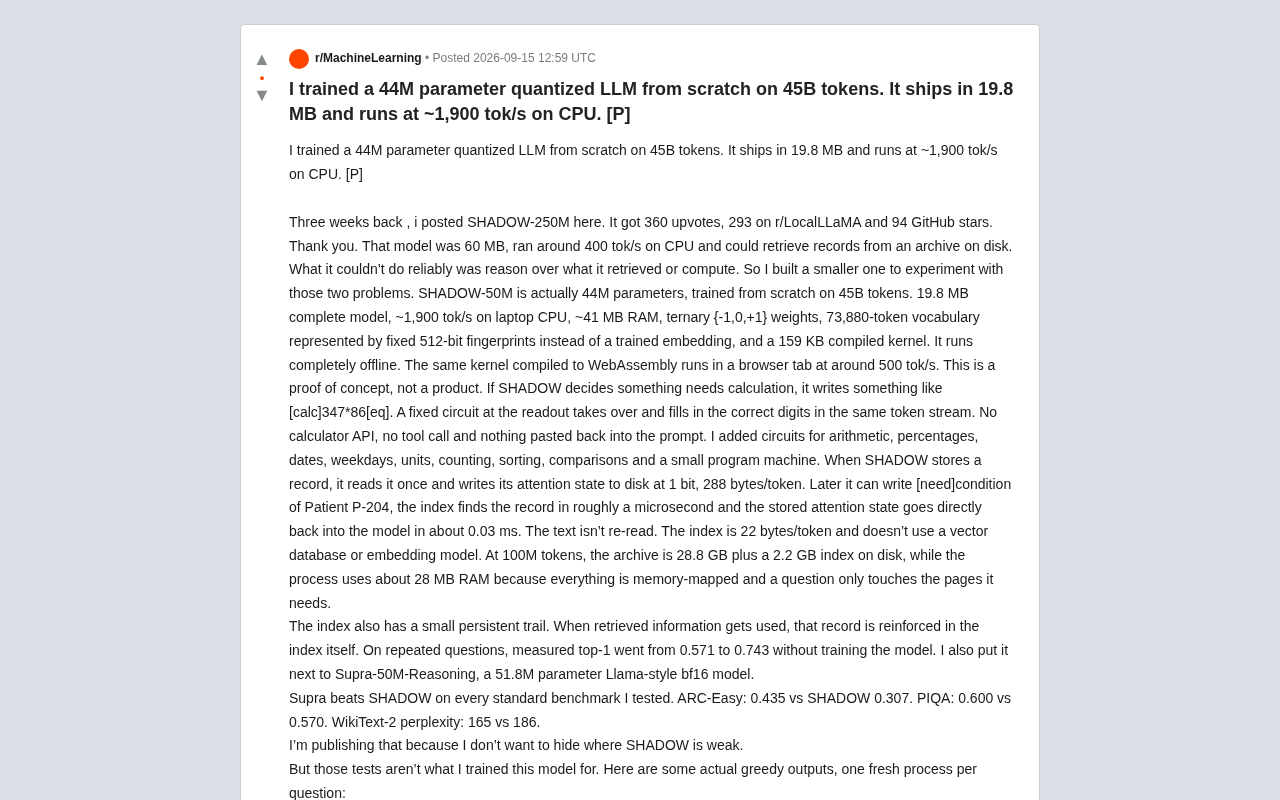
19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。
NVIDIA FLARE联邦学习实战:跨Docker、K8s与Slurm扩展部署
NVIDIA FLARE开源联邦学习框架支持跨Docker、Kubernetes与Slurm部署,解决异构基础设施下的FL扩展难题,助力医疗、金融等隐私敏感行业从原型走向生产落地。