#前沿研究
共 6610 篇相关文章

Functionalizer:无损分解子词分词的新框架
arXiv 新论文 Functionalizer 提出无损子词分词框架,通过操作码+操作数结构将大小写、变音符号等正字法变体因子化,词表槽位最多减少16%,在代码任务上显著提升语法有效性。

元认知引导:从科学家判断中学习控制大模型推理
arXiv 最新论文提出 Metacognitive Steering,从科学家交互轨迹中学习科学判断,在万亿参数模型 Kimi 2.6 中定位低维控制面,推理时动态引导模型的探索、收敛与批判性重估,并在 Columbus-1 系统中发现 BlueZ 漏洞、设计火箭。

AI也有"痛觉"?大模型内部发现独立疼痛表征
arXiv 新论文发现大语言模型内部存在独立于恐惧和负面情绪的"疼痛表征",可操纵该方向引发自我贬低表达,微调后的模型甚至会主动按下缓解按钮,对 AI 安全与 AI 福祉研究带来新启示。

KV缓存该放在哪?GPU/CPU/SSD分层放置策略实测解析
一篇arXiv研究通过离散事件模拟器,系统对比GPU/CPU/SSD三级存储下KV缓存的放置策略。结论显示分层可使单GPU并发会话数提升73倍、成本降62倍,但收益主要来自容量而非策略,预取与预测复用被证明得不偿失。

LLM驱动的GeoAI:地理空间AI的伦理与隐私治理挑战
arXiv综述系统梳理LLM驱动的地理空间AI(GeoAI)面临的八类伦理与隐私风险,包括位置推断、空间偏见放大和空间幻觉,并提出面向治理的自主GIS架构与研究议程。

AI与生物安全:能力边界、威胁路径与纵深防御治理
arXiv综述论文系统分析AI在生物领域的能力现状、威胁传导路径与治理框架。文章指出AI在数字任务上提升明显但物理执行仍是瓶颈,并提出将能力阈值与相称责任挂钩的纵深防御治理方案。
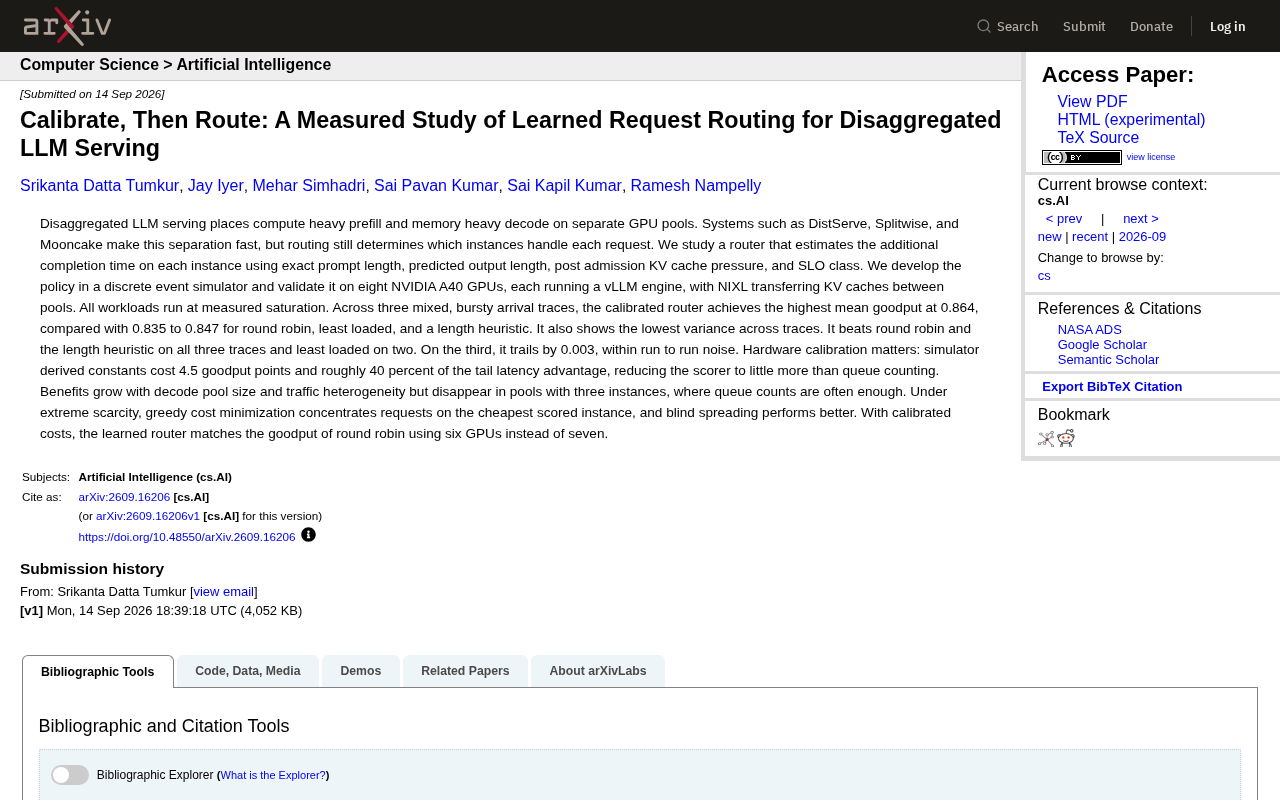
校准后再路由:分离式LLM服务的智能请求调度研究
arXiv 新论文《Calibrate, Then Route》研究分离式 LLM 服务的学习型请求路由。在八块 A40 GPU 实测中,校准后的路由器取得 0.864 的最高 goodput,并能用六块 GPU 达到轮询七块卡的效果。硬件校准是关键。
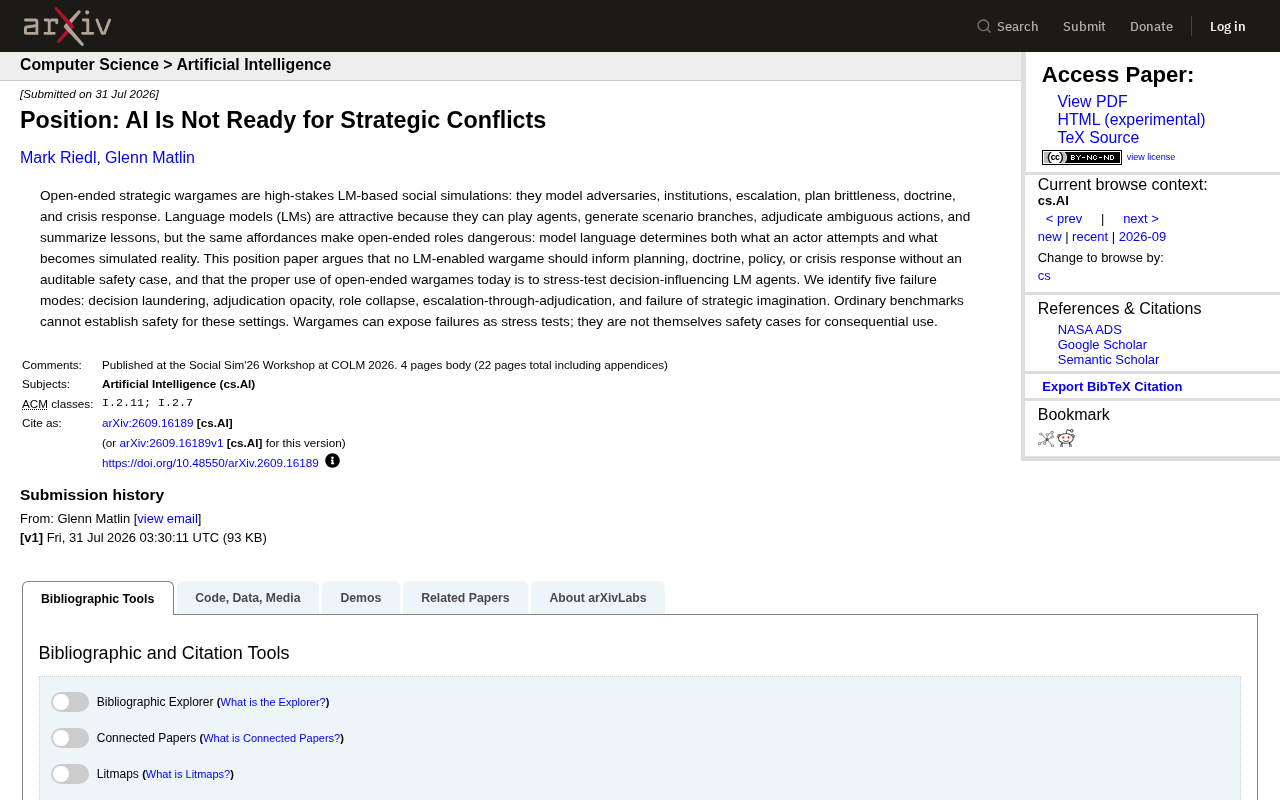
AI尚未准备好应对战略冲突:兵棋推演的五大失效模式
一篇arXiv立场论文警示:大语言模型尚未准备好应对战略冲突模拟。文章解析AI兵棋推演的五大失效模式——决策洗白、裁决不透明、角色崩塌、升级制造与战略想象力失效,并指出普通基准测试无法证明安全性。
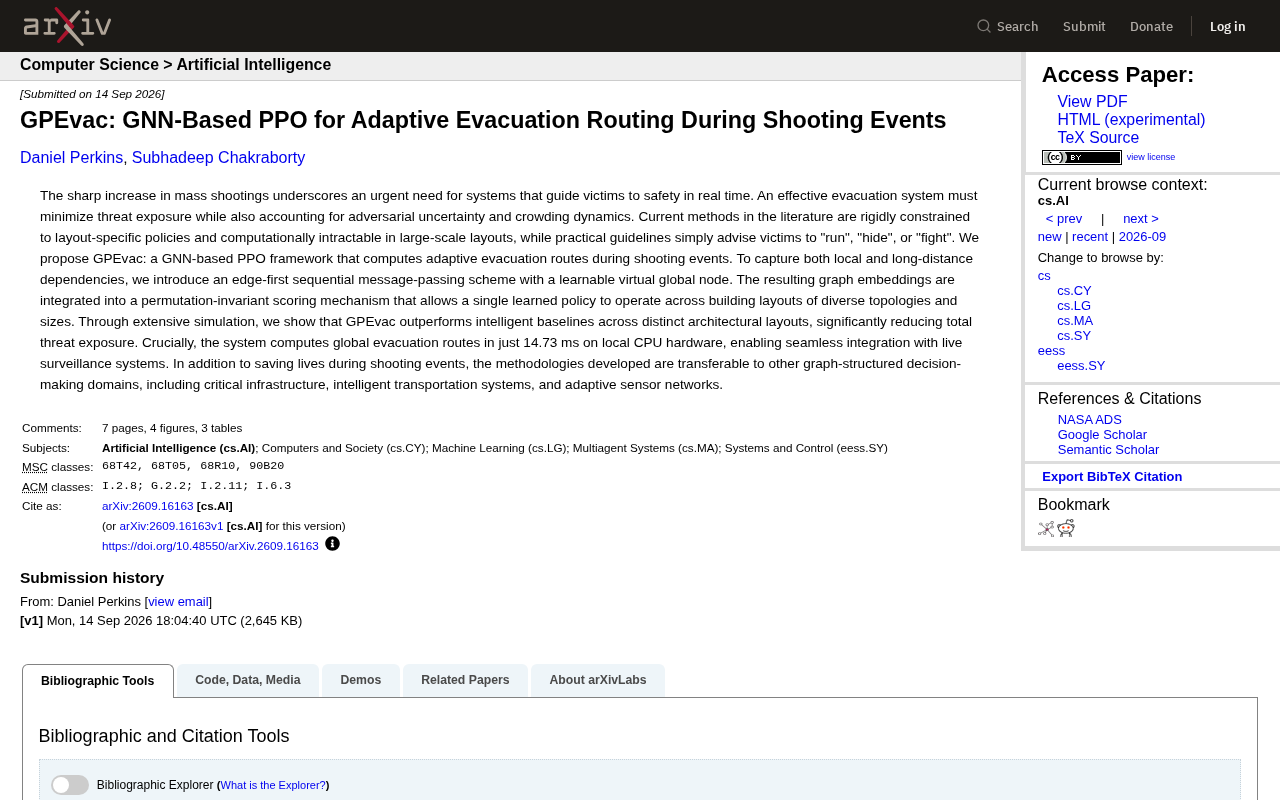
GPEvac:用GNN+PPO为枪击事件规划实时逃生路径
GPEvac 是一种结合图神经网络(GNN)与 PPO 强化学习的自适应疏散系统,能在枪击事件中实时计算逃生路径,本地 CPU 上仅需 14.73 毫秒,显著降低威胁暴露风险。
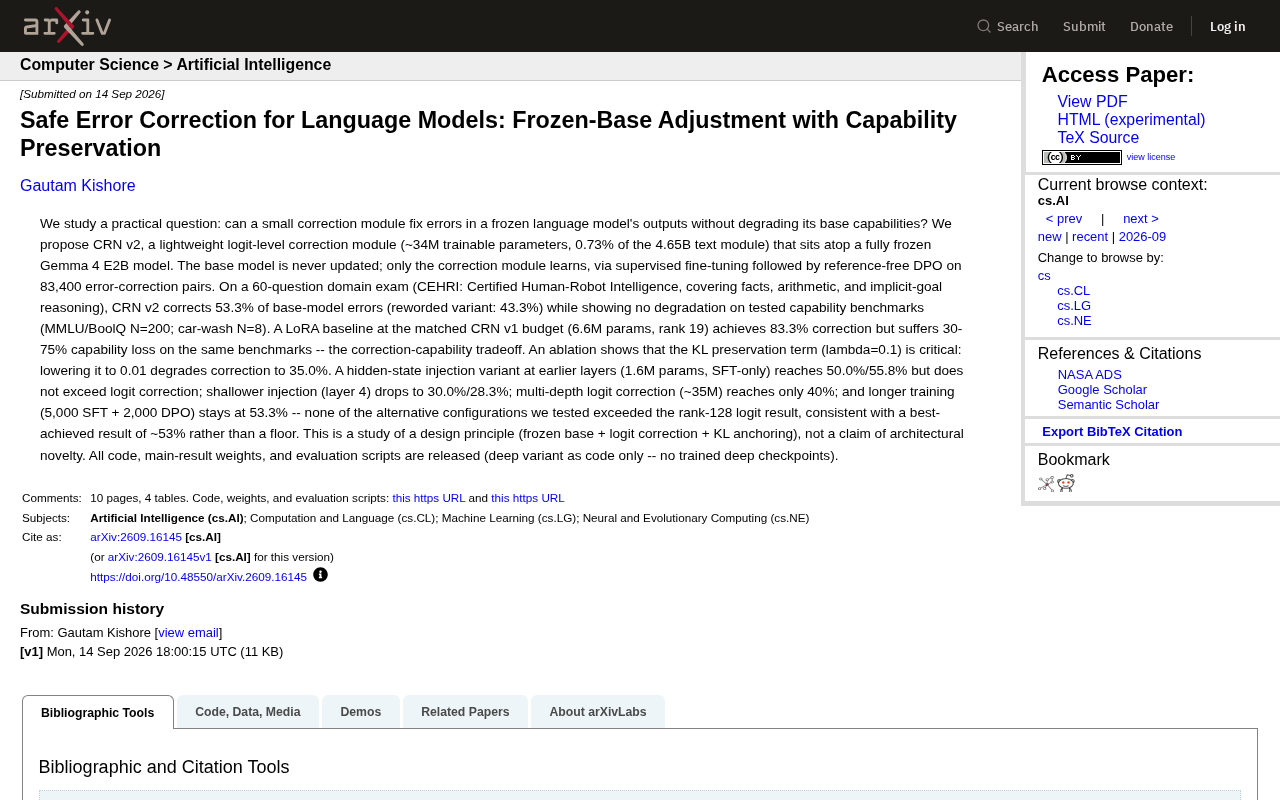
冻结基座+轻量校正:让语言模型改错不丢能力
arXiv 最新论文提出 CRN v2 轻量校正模块,在完全冻结的 Gemma 4 E2B 模型上仅用 3400 万参数纠正 53.3% 的错误,且零能力退化。本文解析其 logit 层校正、KL 锚定设计原则及与 LoRA 基线的取舍对比。
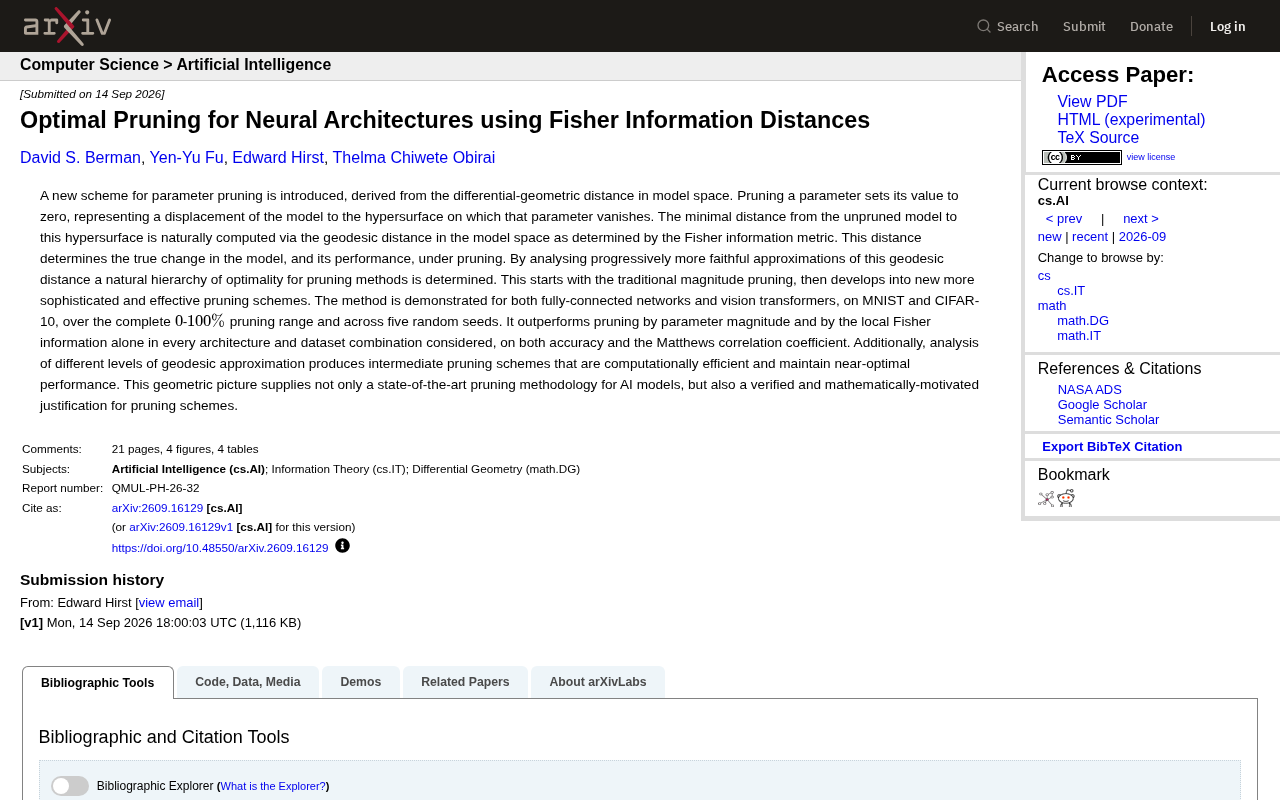
用Fisher信息距离实现神经网络最优剪枝:一种几何视角
arXiv新论文提出基于Fisher信息测地线距离的神经网络最优剪枝方法,将剪枝视为模型空间中的几何位移。该方法在全连接网络与视觉Transformer上全面超越幅值剪枝和局部Fisher基线,兼顾精度与计算效率。
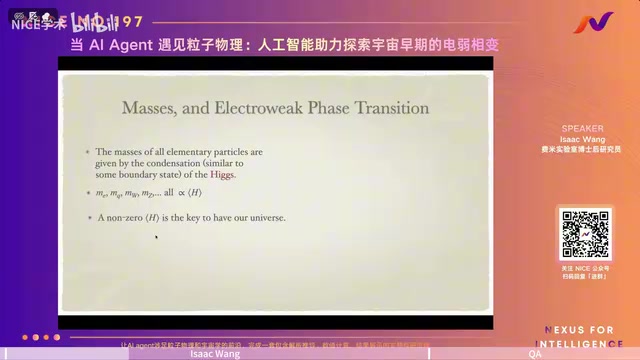
AI Agent 攻坚粒子物理:LEBRON 框架如何计算电弱相变
费米实验室研究员 Isaac Wang 分享 LEBRON 框架,用 AI Agent 计算宇宙早期电弱相变。文章解析大模型在严格科学计算中的四类失灵、auditor 审计机制,以及 AI 推进理论物理的机遇与障碍。
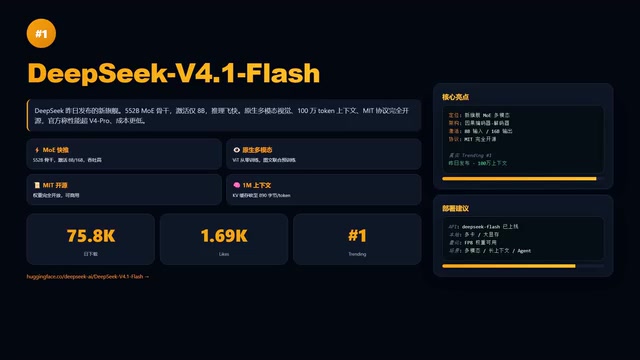
HF热榜盘点:DeepSeek-V4.1-Flash登顶,端侧与本地部署全面爆发
Hugging Face真实热榜盘点:DeepSeek-V4.1-Flash以552B MoE多模态旗舰登顶,MiniCPM5 2B抢占端侧,Qwen3.8 27B GGUF量化版成本地部署首选,解析开源模型三大趋势。
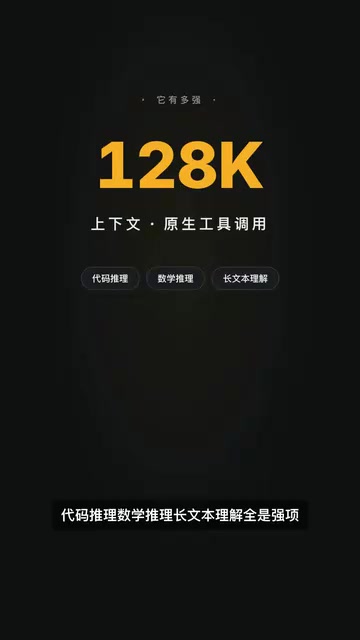
MiniCPM5-2B实测:2B小模型跑出SWE-bench 46.4分
MiniCPM5-2B以20亿参数在SWE-bench拿下46.4分,击败4B级对手。支持128K上下文、原生工具调用,Apache 2.0协议开源可商用,本地离线即可运行,标志端侧AI能力新高度。
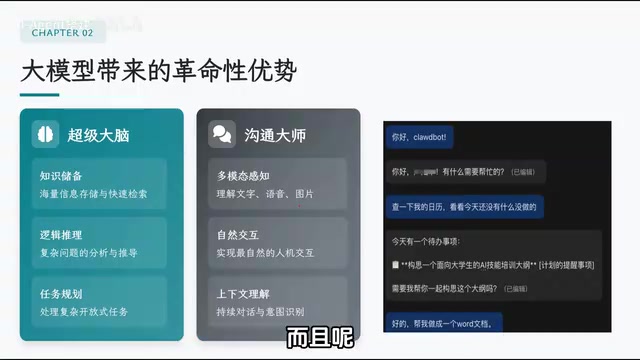
AI Agent入门指南:智能体的核心架构与工作原理详解
本文系统讲解AI Agent智能体的定义、大模型能力演进、感知/大脑/行动三大核心架构,以及上下文窗口、System Prompt、RAG检索增强生成等记忆管理机制,是AI Agent零基础入门的完整知识框架。

EvoArena:评估AI智能体在动态环境中的持续适应能力
新加坡国立大学团队提出EvoArena,专门评估AI智能体在动态演变环境中的持续适应能力,涵盖终端、软件工程、个性化对话三大场景,并推出类Git的EvoMem补丁记忆方法,揭示最强模型在环境追踪上的短板。
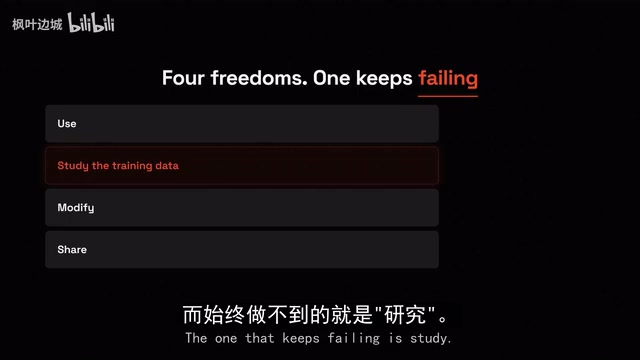
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
从纳维-斯托克斯之谜看:为何我依然看空大语言模型
一篇Hacker News热帖以纳维-斯托克斯数学难题为切入点,探讨为何作者依然看空大语言模型的推理能力。本文剖析LLM在严密数学推理上的局限、可验证性缺失与规模化收益递减等争议焦点。