#前沿研究
共 8684 篇相关文章

NASA火星采样返回任务被取消:一场科学雄心的搁浅
NASA火星采样返回任务(MSR)被正式终结。这项旨在将毅力号采集的火星样本带回地球的宏大计划,因预算严重超支与技术复杂性而搁浅,引发科学界与技术社区广泛讨论。
Jev与System One模型:LLM的新形态"决策模型"
TypeSafe AI 推出 Jev,一种输出浮点数而非文本的新型 LLM——决策模型(System One)。本文解析其是非/选择/评分三类问题、极低价格、搜索重排等应用,以及黑盒偏见隐忧和开源复现浪潮。
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。
数据本体论:AI智能体缺失的上下文层
数据本体论(Data Ontology)是AI智能体缺失的上下文层。本文解析它如何统一业务语义、消除数据歧义,让AI从猜测业务含义转向依据明确定义执行,是企业级AI落地的关键基础设施。
如何评估AI Agent:从工具调用到任务完成的全链路测评
AI Agent评估需要从工具调用到任务完成的全链路视角。本文解析Agent测评的两个核心层次,帮助团队判断Agent能否在真实环境中完成复杂连续任务。
OpenAI组建数学顾问团:AI已破解100多个未解难题
OpenAI组建数学顾问团,其AI系统已解决超过100个开放性数学难题。顾问团被明确定位为加速研究而非放缓,本文解析这一进展对AI推理能力与基础科学研究的深远意义。
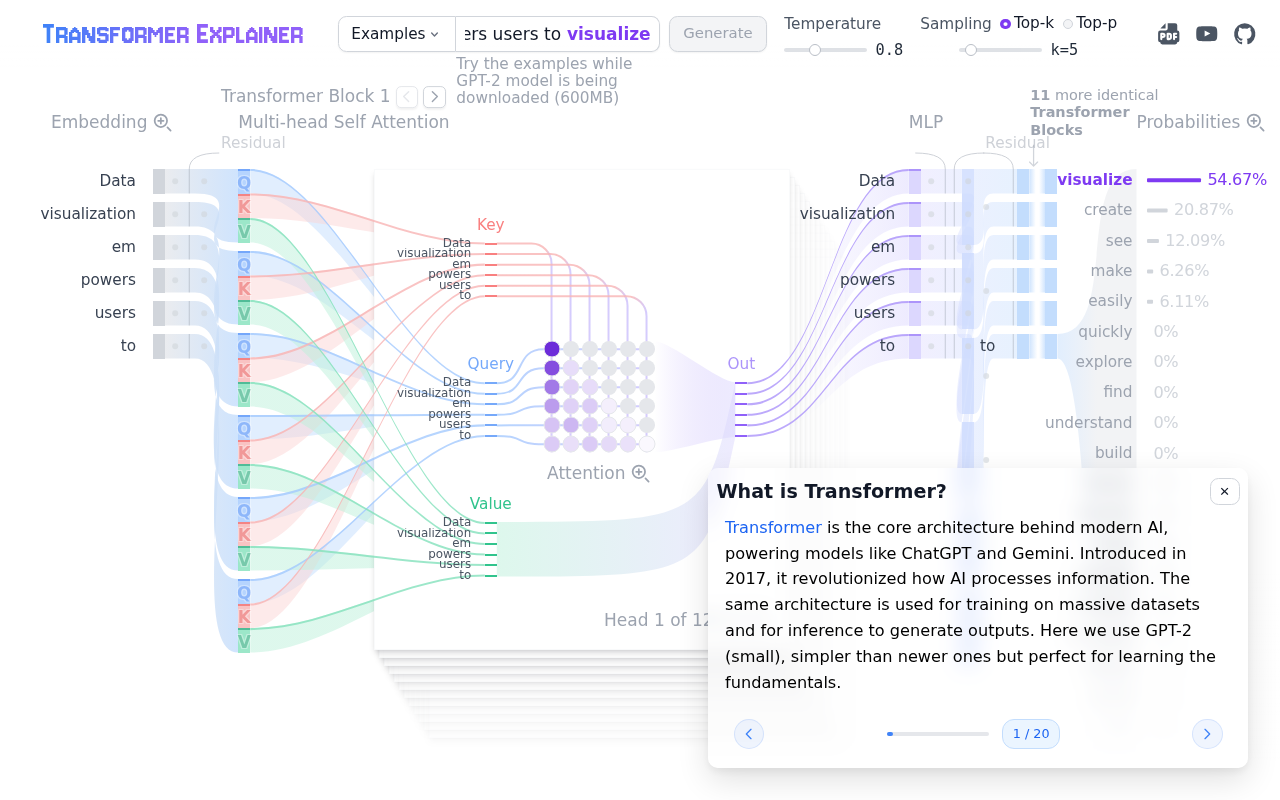
可视化理解Transformer:拆解大模型背后的核心架构
用可视化方式拆解Transformer架构,深入浅出讲解自注意力机制、多头注意力、位置编码与编码器-解码器结构,帮助AI学习者建立对大模型底层原理的直观理解。
TinyTorch:自己动手实现PyTorch,从张量到Transformer
TinyTorch 是一个免费开源的机器学习教学课程,引导你从零构建一个可运行的深度学习框架,覆盖从张量、自动微分到 Transformer 的完整链条。本文解析它的学习路径与价值,帮你从调库者变成真正理解框架原理的工程师。
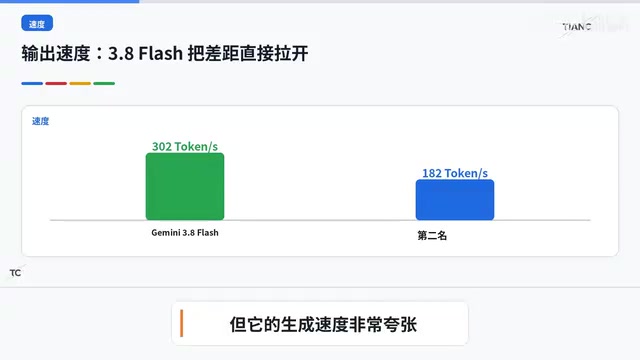
Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
Gemini 3.5 Pro延期难产,谷歌却疯狂迭代3.8 Flash。本文从智能、速度、单位任务成本与TPU算力能效角度,解析谷歌如何重新定义大模型战争,从军备竞赛转向工业竞赛。
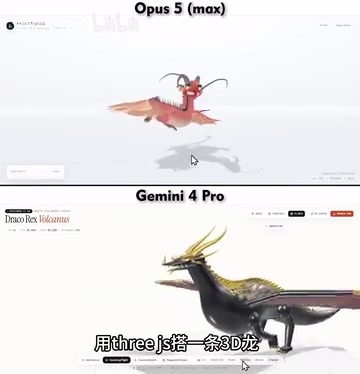
Gemini 4 Pro对决Opus 5 Max:Three.js建3D龙谁更强?
Gemini 4 Pro 与满血 Opus 5 Max 用同一条提示词、通过 Three.js 搭建 3D 龙的横向对比测试。结果显示未发布的 Gemini 4 Pro 竟能与满配 Opus 5 打成平手,本文解析这场 AI 编程能力对决的看点与意义。

AI能力在飙升,可靠性却停滞:被忽视的真正难题
AI能力持续飙升,但可靠性却停滞不前。基于普林斯顿HAL研究和Nature论文,本文探讨为何评测体系奖励自信错误、Agent从建议转向执行后的风险量级变化,以及生产环境中衡量AI可靠性的真正难题。
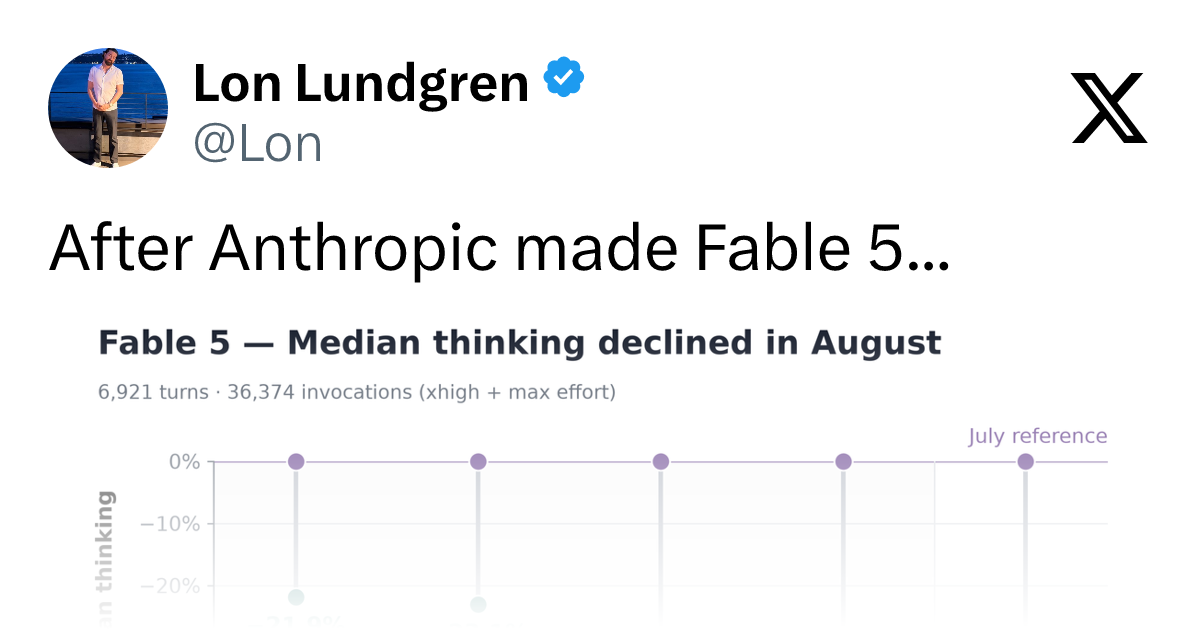
Fable 5引发热议:AI推理能力真的在下降吗?
Hacker News 热议话题「Fable 5」指出 AI 推理能力中位数在八月出现下滑,引发社区对大模型表现波动的讨论。本文分析模型退化的可能原因与第三方监测的价值。
本地部署前沿AI模型:硬件自主运行的可能性
探讨在个人硬件上运行前沿AI模型的可能性、技术门槛与价值。分析本地部署AI在显存算力、模型可获取性方面的挑战,以及数据自主与成本控制带来的吸引力。
亚马逊携手斯坦福启动AI科研计划
亚马逊宣布与斯坦福大学启动AI与科学研究合作计划,聚焦推进前沿研究、扩大参与度和推动成果落地转化,成为科技巨头与顶尖高校联合研发的最新案例。

Grok 4.7 智能、性能与价格深度解析
针对 Grok 4.7 的智能、性能与价格分析进行梳理,介绍评估大语言模型的核心维度,包括基准测试、推理速度与定价性价比,帮助读者建立理性的模型评估框架。

时间触发通信系统中的"喋喋不休"故障及其防护
深入解析时间触发通信系统中的"喋喋不休"(babbling idiot)故障模式,探讨总线守卫、集中式与分布式守卫架构如何实现故障隔离,保障航空、汽车等安全关键系统的通信可靠性。

数学界成立AI咨询组:应对人工智能对研究范式的冲击
数学界成立人工智能咨询组,旨在为研究者和机构提供AI使用指导,应对AI对数学研究严谨性、学术诚信与验证标准的冲击。本文分析其成立背景与可能承担的角色。
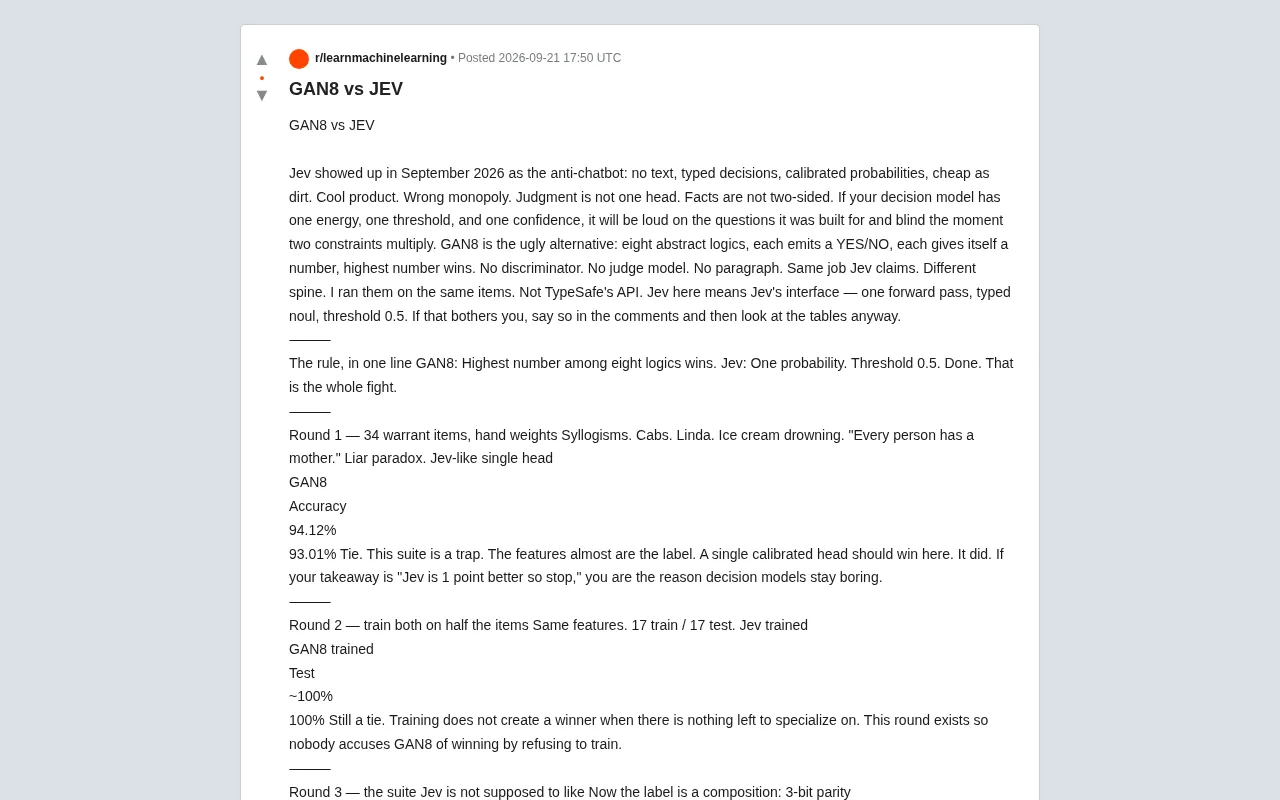
GAN8 对决 JEV:单头判断模型与八逻辑架构的实战较量
GAN8 与 JEV 两种决策 AI 架构的四轮实战对比:单头概率模型 vs 八逻辑表决架构。在奇偶校验等结构性组合任务上 GAN8 完胜,但融合两者反而更糟。深入解析决策模型设计的核心权衡。