#大语言模型
共 302 篇相关文章

RAG框架赋能路口安全:用大模型将事故叙述转化为对策建议
一项arXiv最新研究提出检索增强生成(RAG)框架,用大模型将交叉路口事故叙述自动转化为对策建议,在佛罗里达真实数据上实现0.82的F1分数,为交通安全分析提供可解释、可扩展的决策支持工具。
推理网络:用阈值策略优化大模型推理成本
arXiv 最新研究提出「推理网络」图框架,用于优化大语言模型的推理成本。论文证明最优模型激活策略具有阈值结构:先用低成本模型,置信度不足时再调用昂贵模型,在开源 LLM 上实现显著降本。

DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。
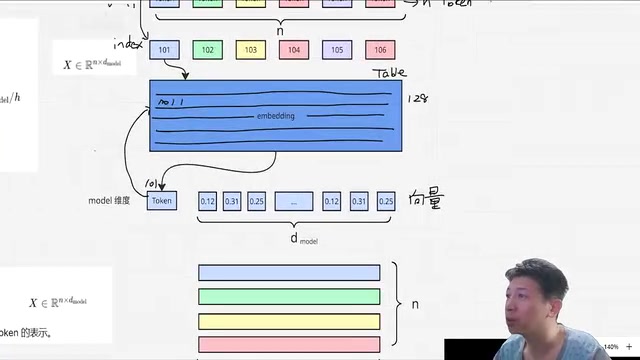
Transformer注意力机制详解:从Token到自注意力全流程
深入解析 Transformer 注意力机制,从 Tokenizer 分词、Embedding 向量化到 Q/K/V 自注意力计算、Mask 掩码与 Softmax 全流程拆解,重点追踪每一步的矩阵维度变化,帮助理解大模型与 AI Agent 长文本处理的底层原理。
"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

PhysMent:用交互式物理仿真评测大模型的物理推理能力
PhysMent 是一个基于 MuJoCo 仿真器的交互式基准测试,通过施力、观测、推进时间等工具调用评测大语言模型的物理推理能力。研究发现模型在定性任务表现尚可,但定量多步实验任务准确率骤降,瓶颈在于流程性工具使用而非物理知识本身。

TimeThink:让时序大模型学会组合式推理的合成框架
TimeThink 是一个用于激发时序大模型组合式推理能力的合成框架,通过确定性生成可验证的问答数据与 RLVR 训练策略,仅用合成数据即在真实基准上超越强基线,为医疗等高风险场景的可解释时序推理提供新思路。

Vibe Patenting:LLM评审员能胜任专利撰写评估吗?
arXiv最新研究通过Vibe Patenting测试平台,评估LLM评审员在专利撰写这类专业任务中的可靠性。研究发现评审反馈能让低成本智能体逼近高端模型,但AI评审与人类专利律师的一致性强烈依赖具体指标。

Swift-Qwen3.8-27B:削减58%思考token,推理速度翻倍
UkisAI 开源 Swift-Qwen3.8-27B,通过定位并惩罚"过度思考"token,配合在线策略蒸馏,实现思考token削减58%、推理速度提升1.95倍,准确率损失控制在1%以内。本文详解其技术路径与基准测试数据。
苹果Siri或将支持切换Claude、ChatGPT:代码揭示端倪
开发者从苹果代码中发现,Siri背后的AI模型可能支持切换,未来或接入Claude、ChatGPT等第三方大模型。本文解析这一发现的技术含义、苹果的AI战略考量及其对行业的影响。

先修复后强化:上下文增强知识图谱推理攻克多跳问答难题
arXiv 最新论文提出上下文增强知识图谱推理框架,通过"先修复后强化"策略提升大模型多跳问答能力。在胃轻瘫与糖尿病知识图谱上,基于 Qwen3-14B 验证 CG 监督优于纯 KG 监督,修复后单跳准确率达 100%。

压缩的代价:事实幻觉背后的率失真极限
arXiv新论文用率失真理论揭示大语言模型事实幻觉的第二个来源:有限记忆下的压缩失真。文章解析覆盖—压缩模型、误差下界公式及其对检索增强、弃答等实践的启示。

弱监督+LLM标注精炼:从人道主义文档中提取数据集引用
arXiv新论文提出弱监督+LLM标注精炼框架,从强迫流离失所与FCV人道主义文档中自动提取数据集引用。在1706段黄金基准上达到88.2%段落级准确率,为标注数据稀缺场景提供可复制方案。
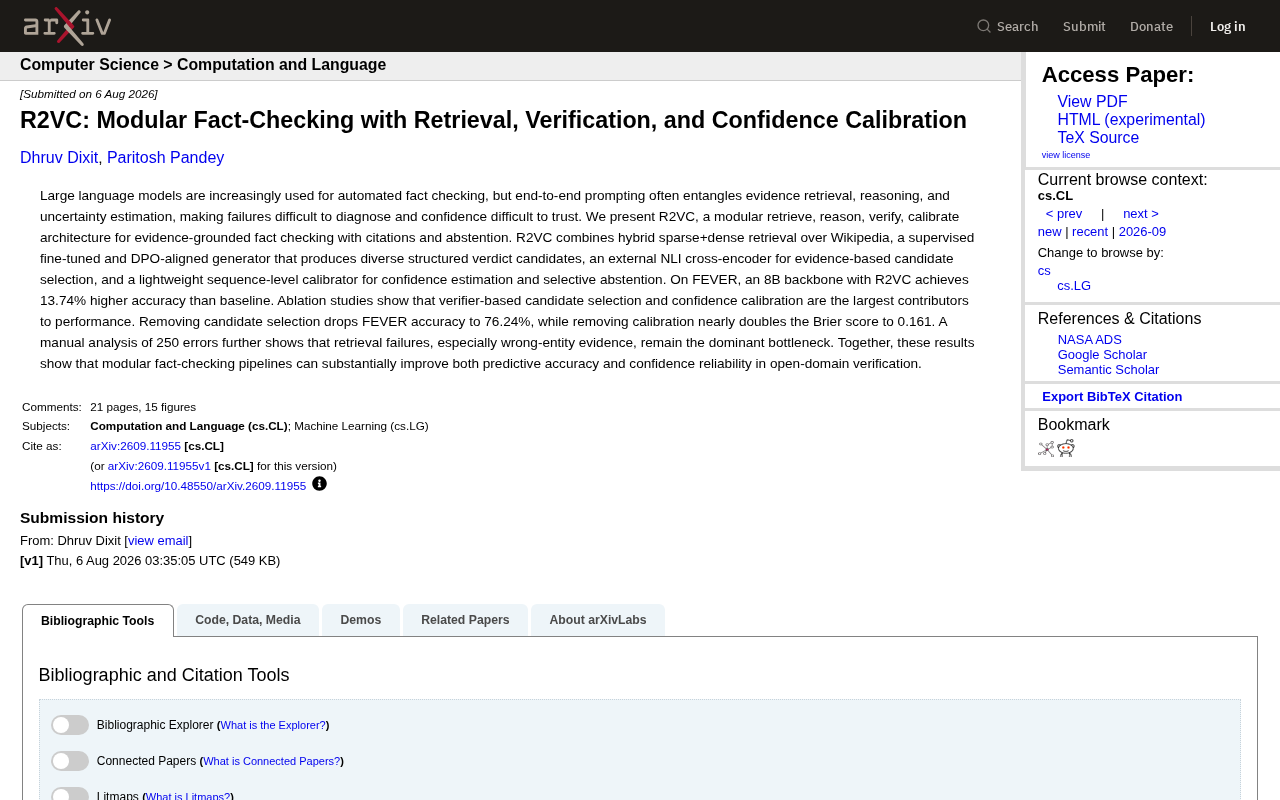
R2VC:模块化事实核查架构,让LLM验证更可信
arXiv 新论文 R2VC 提出模块化事实核查架构,通过检索、推理、验证、校准四环节,在 FEVER 基准上让 8B 模型准确率提升 13.74%,同时显著改善置信度可靠性与可弃权机制。
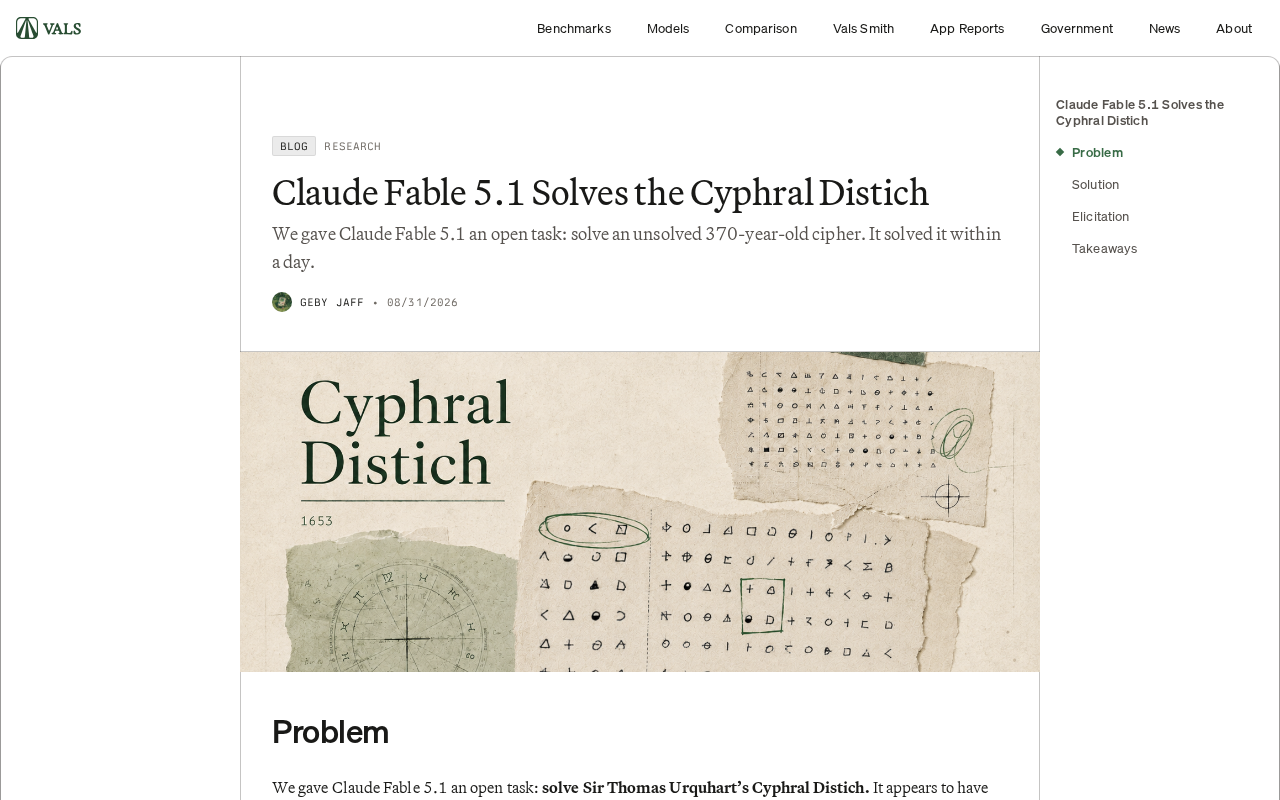
AI破解370年古密码?Claude Fable 5.1的争议性突破
Hacker News 热议:AI模型Claude Fable 5.1据称破解了有370年历史的Cyphral Distich密码。本文梳理事件并分析AI在古密码破译中的能力、局限与需谨慎看待的关键点。
本地大模型幻觉检测实战:从1.5B到120B的低显存方案
如何在不额外消耗大量显存的前提下检测本地大模型的幻觉?本文基于1.5B到120B模型的实测经验,解析置信度、自洽性、轻量校验等低开销检测思路,为本地LLM部署者提供实用参考。
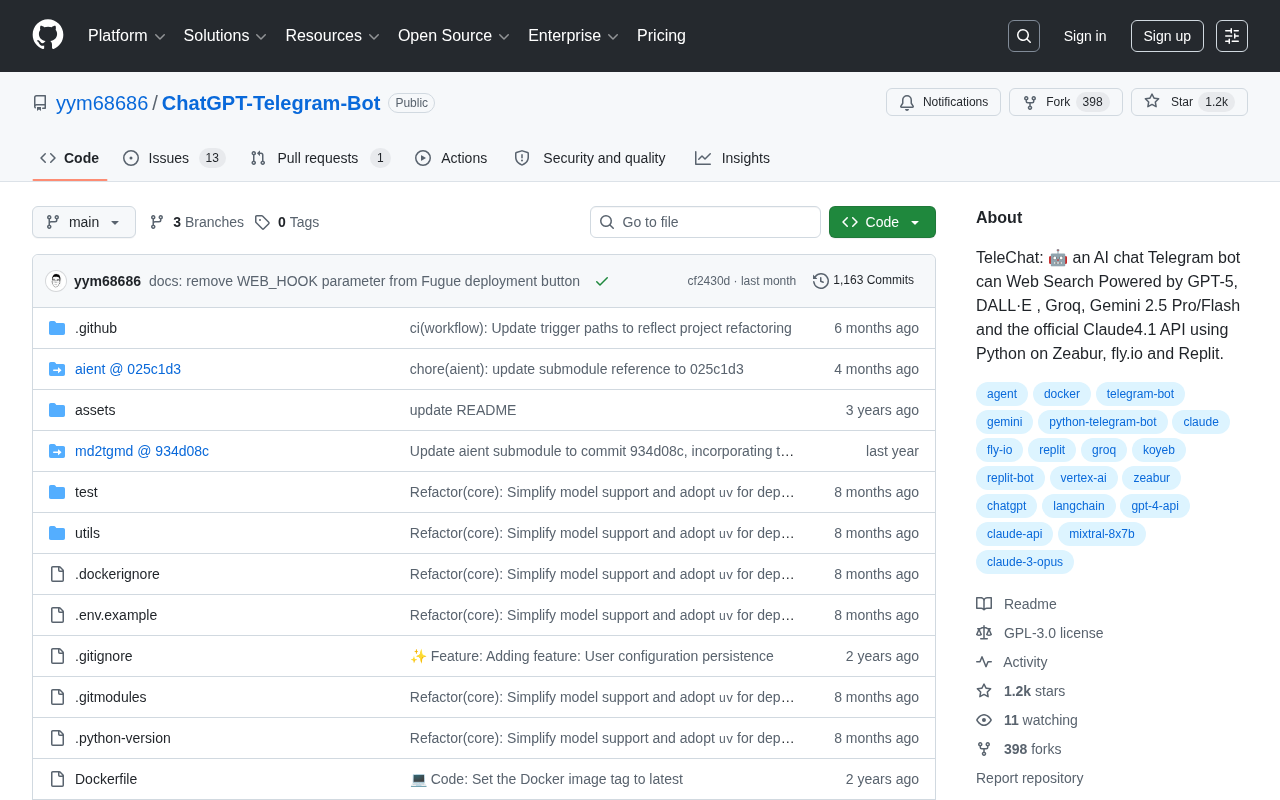
TeleChat:集成GPT-5、Gemini与Claude的开源Telegram AI机器人
TeleChat 是一个开源 Telegram AI 聊天机器人,集成 GPT-5、DALL·E、Groq、Gemini 2.5 与 Claude 4.1 API,支持联网搜索,可在 Zeabur、fly.io、Replit 部署,已获 1242 Star。

"LLM是真的,AI是假的":一场概念之争的思辨
Hacker News热议命题《LLMs are real, AI is fake》引发思辨:为何说大语言模型真实可验证,而'人工智能'更像营销话术?本文解析术语精确性的重要性及其对从业者的启示。
