#开源工具
共 12983 篇相关文章

AI+Playwright打造闲鱼监控利器:ai-goofish-monitor解析
GitHub开源项目ai-goofish-monitor基于Playwright与AI实现闲鱼多任务实时/定时监控与智能分析,配备后台管理UI,帮助用户从海量商品中高效筛选心仪产品。本文解析其核心架构、功能特点与适用场景。
从零实现XGBoost回归:5天手写代码,精度媲美sklearn
开发者用5天时间从零实现XGBoost回归算法,精度与sklearn几乎相同但速度稍慢。本文分析实现难点、精度对比及对机器学习学习者的启示。

PARC:面向端侧多模态Agent的并行对齐剪枝与轮次感知上下文复用
PARC研究提出并行对齐结构化剪枝与轮次感知KV缓存复用,解决端侧多模态Agent的核心分区失配与缓存膨胀问题。七核部署下视觉编码器延迟降低11.4%,解码吞吐提升23.8%,精度无回退。

开源大模型背诵圣训全翻车:3万次回答无一对得上原文
一项双语基准测试用3万次回答考察五个开源大模型对六大圣训集的逐字回忆能力,结果显示0%的回答达到词汇与语义双高保真,阿拉伯语表现反而更差。研究主张高风险文本任务必须采用检索增强生成而非参数化记忆。

AVID:首个5T fMRI听觉诱导视觉想象解码基准数据集
AVID是首个面向听觉诱导视觉心理想象解码的5.0特斯拉fMRI训练级数据集,含约67小时九名参与者记录,提供场景级与受控双子集及解耦源图像一致性与语义对齐的标准化评估协议,基线显示当前重建流程仍有限但可保留场景级语义。

BasisKV:低秩KV缓存压缩如何同时优化张量并行通信与关键页路由
BasisKV提出低秩KV缓存压缩新方法:将Value压缩与输出投影绑定以削减张量并行通信,并复用Value潜变量预测Key路由,在8卡张量并行推理下实现最高1.42倍端到端加速。

扩散模型成员推理新方法LoFIT:局部条件拟合检测训练数据
论文提出LoFIT方法,通过分析条件预测偏移中的方向性信号实现扩散模型成员推理。无需梯度,仅前向查询,在四个数据集上优于基线,微调早期即可区分成员。
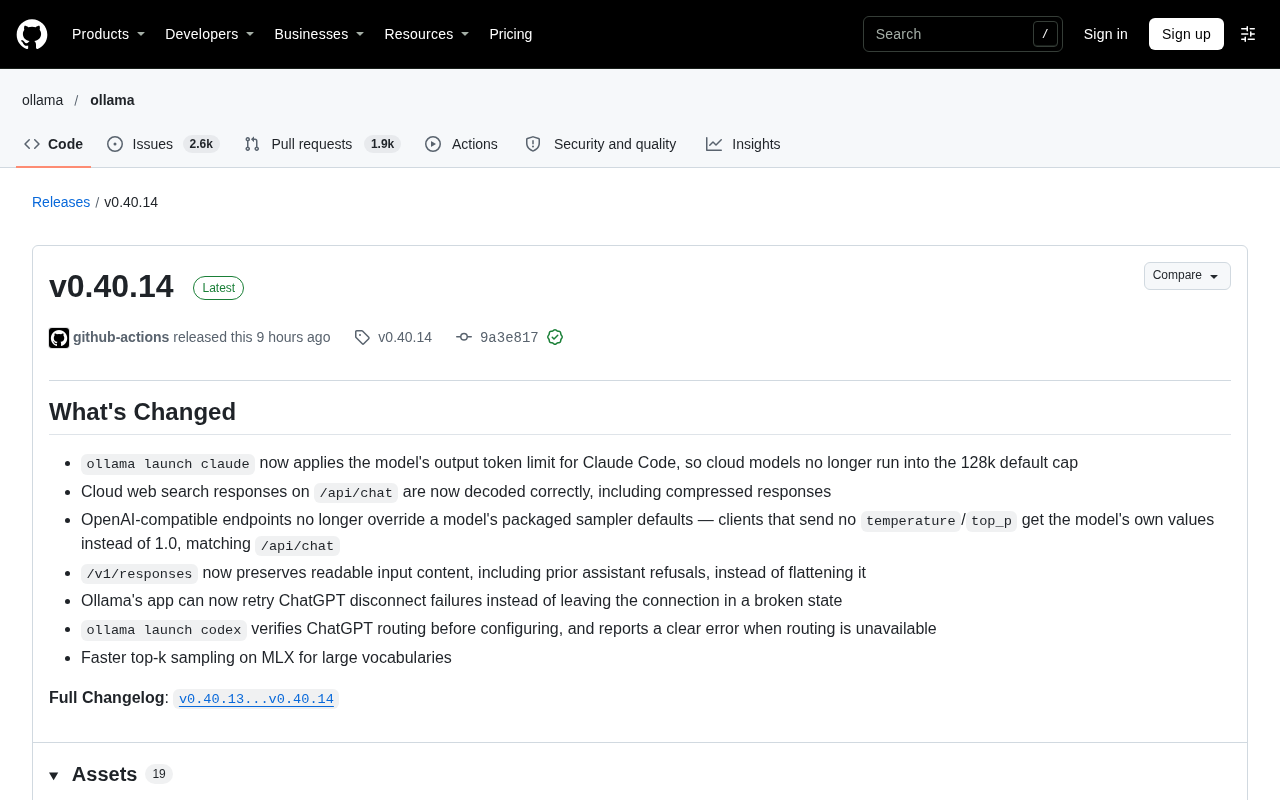
Ollama v0.40.14 更新:修复云模型输出限制与采样默认值
Ollama v0.40.14 发布,修复云模型在 Claude Code 中的 128k 输出上限问题,OpenAI 兼容接口不再覆盖模型采样默认值,并改进 /v1/responses 输入保留与 ChatGPT 连接重试。
LangGraph 集成 VLM:让图像回答更精准的实战思路
介绍如何用 LangGraph 编排 VLM 视觉语言模型处理图像问答,拆解输入解析、视觉提取、生成与校验节点,分析提示词设计、状态管理与重试策略,帮助开发者从图像中获得更稳定准确的回答。

OpenAI自研Pando:Git后端推送延迟降80%
OpenAI 自研 Git 兼容后端 Pando,通过分支独立处理与跨 fetch 复用 packfile,将中位推送延迟降低近 80%,每日承载近 PB 级 Git 数据,为超大型单体仓库的版本控制提供新思路。

旧结论遇新模型:LLM复现研究的启示
从 Hacker News 讨论出发,分析用新模型大规模复现 LLM 旧研究结论的意义与难点:提示词敏感性、评测集污染、结论时效性,以及复现研究对论文可信度和工程选型的影响。

Pixel-UMI:从人体演示学习全身操作策略
Pixel-UMI 提出从传感器化人体演示学习环境感知全身操作策略的流程,包含环境感知重定向 EAR、重定向误差感知掩码 REAM 与 DAgger 在线纠正,在五项任务上平均任务进度达 87.0%。

Pixel:软硬件协同设计的全栈机器人学习系统
Pixel 是面向通用移动操作的全栈机器人学习系统,将低成本轮式人形硬件、多种数据采集接口、统一全身控制器与分层策略学习管线协同设计,支持语言条件化视觉运动控制和长程任务执行。

WebHarbor:用153个真实网站环境训练GUI智能体
WebHarbor 是一套包含 153 个 Docker 化真实网站环境的套件,覆盖 3518 个多步骤与登录后任务,既可用于 GUI 智能体可靠评测,也能支撑强化学习训练,让 Qwen 4B 级模型泛化到未见任务。
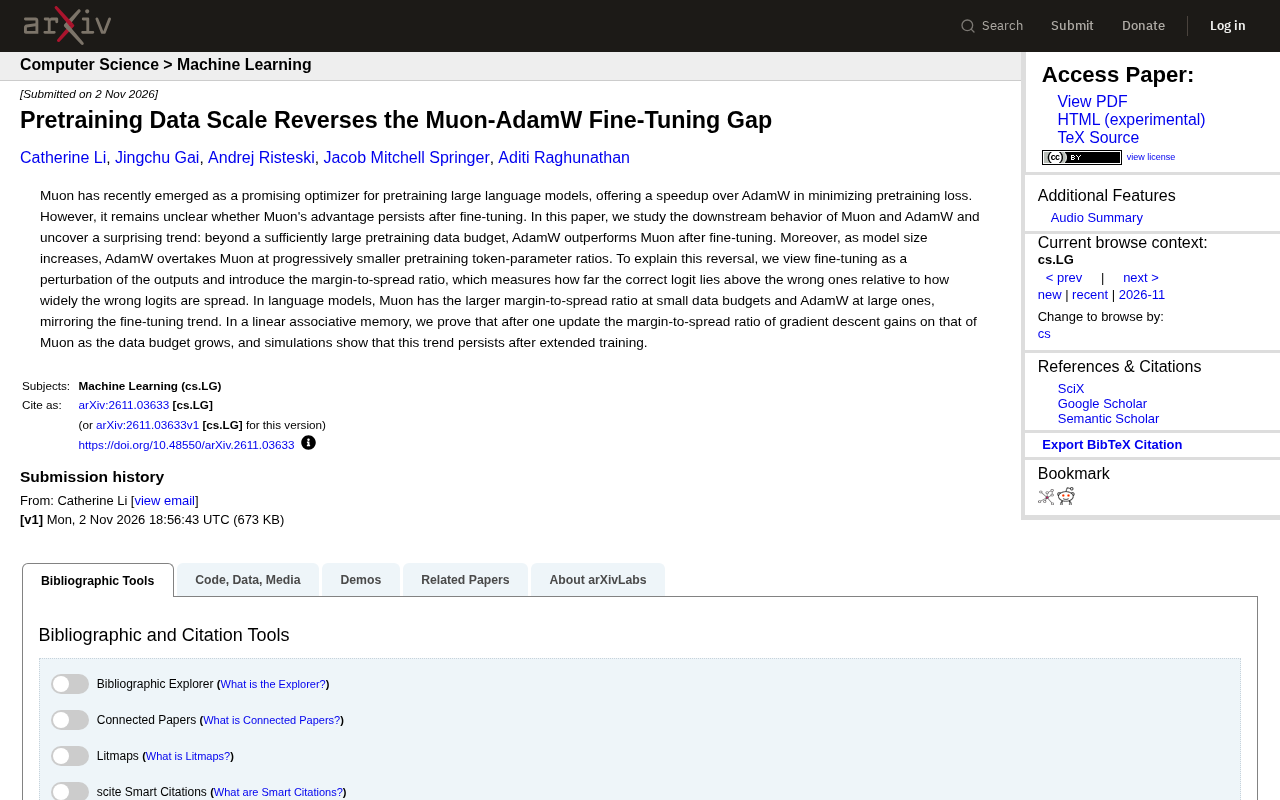
预训练数据规模逆转:Muon微调优势为何被AdamW反超
新研究发现预训练数据规模足够大时,AdamW在微调后反超Muon。边际-散布比理论解释这一逆转,为优化器选择提供新视角。

RLVR泛化困境:推理策略为何在OOD下失效
研究揭示RLVR在分布外任务上推理策略崩溃的现象:模型放弃推导退化为暴力枚举,而协同训练双射反转任务能意外恢复OOD准确率,为LLM推理泛化提供新思路。

FADE:解耦能力与难度的在线RLVR调度新方法
FADE提出双线性状态空间滤波,解耦模型能力与提示难度,提升在线RLVR调度效率。在五个推理基准上验证,每步开销低于0.6毫秒,显著改善准确率与校准度。

D&A:解耦描述与评估,让VLM成为零样本机器人奖励模型
D&A 框架将 VLM 的机器人任务进度估计解耦为客观描述与显式评分两阶段,用文本化成功定义对抗确认偏差,纯提示方法即可匹配后训练奖励模型,支持零样本泛化与下游强化学习。

Strategist:用元智能体进化推理策略
Strategist是一个跨任务进化推理策略的元智能体。它将策略编写为可执行蓝图并构建蓝图库,通过检索、生成、测试和修订的循环自动改进推理流程。在30个基准测试中,Strategist在24个上超越最强基线,平均准确率持平(74.7% vs 74.0%)且推理成本降低39%,策略还能迁移到未见任务和模型。

31.6M参数土耳其语音识别模型:ufakzeka-kulak开源发布
ufakzeka-kulak 是一个 31.6M 参数的开源土耳其语语音识别模型,基于 FastConformer 和 TDT,Apache-2.0 许可。在 FLEURS 和 Common Voice 上 WER 优于 Whisper base/small,本文解读其训练数据筛选、评估设计与应用场景。