#深度学习理论
共 8 篇相关文章

·5 分钟
深度学习三大架构与万能逼近定理:一次讲透MLP、CNN与Transformer
从Reddit热帖出发,梳理MLP、CNN、Transformer三种深度学习架构的归纳偏置差异,讲清万能逼近定理(UAT)的存在性含义与泰勒展开在逼近分析中的作用,并澄清常见误解。
阅读全文 →

·5 分钟
用积木讲透万能近似定理:神经网络为何能逼近任意函数
用可视化“积木”思路拆解 Michael Nielsen 第4章的万能近似定理:单个神经元如何造出阶跃砖块、两块阶跃如何相减成凸起、单隐藏层网络如何堆叠逼近任意连续函数,以及定理能证明什么、不能证明什么。
阅读全文 →

·5 分钟
Neural Expansion:解密深度神经网络泛化的统一几何机制
深度神经网络泛化难题迎来新解释:Neural Expansion框架通过输入空间方向性射线覆盖的几何扩展,统一解释正确分类、对抗样本和OOD样本的预测行为,为理解泛化机制提供新视角。
阅读全文 →

·5 分钟
神经网络拓扑表达力的构造性边界:从决策边界到输出空间
一项关于神经网络拓扑表达力的研究提出用输出空间贝蒂数替代决策边界度量,给出ReLU网络表达球面楔和与乘积的构造性架构上界,并猜想球面同胚空间的紧边界,为理解深度网络的几何表达能力提供新框架。
阅读全文 →
·6 分钟
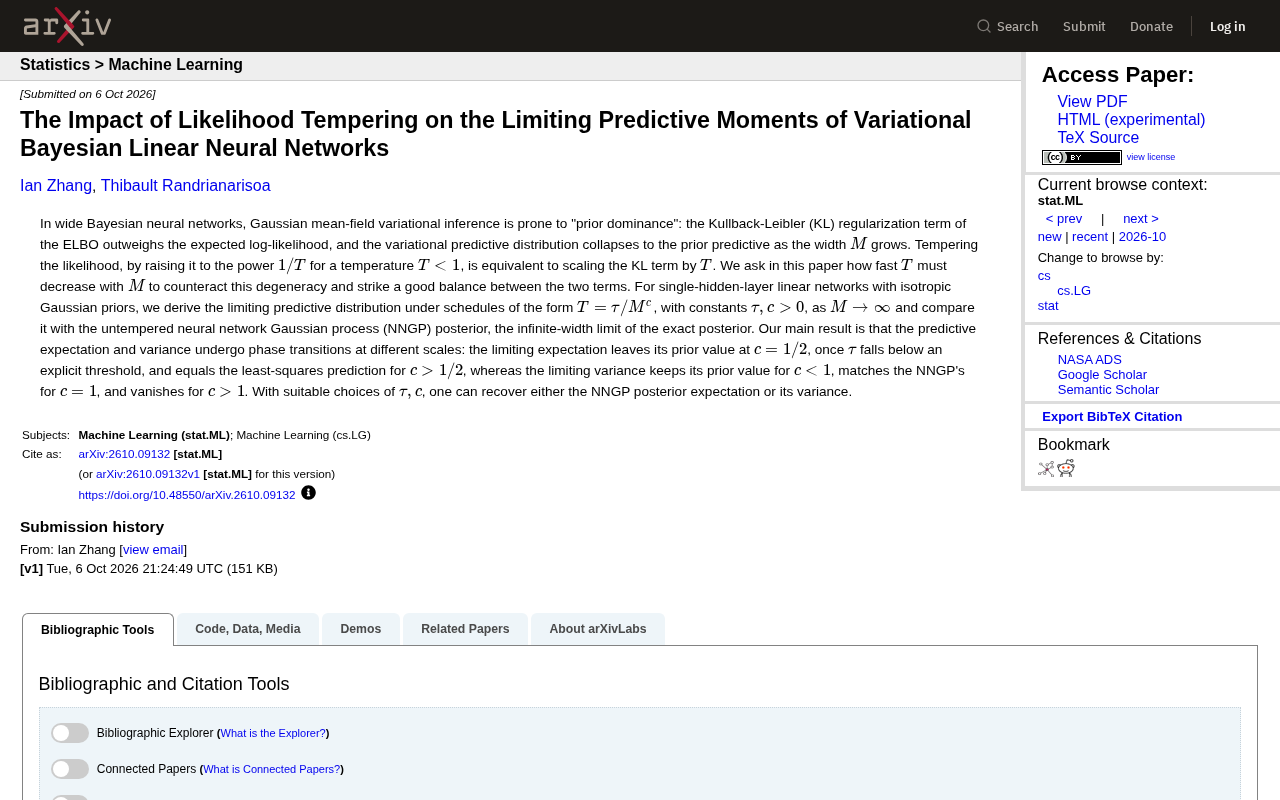
似然温度调节如何拯救贝叶斯神经网络的"先验坍缩"
arXiv 新论文研究贝叶斯神经网络的"先验坍缩"问题,揭示似然温度调节如何对抗宽度增长带来的退化。核心发现:预测期望与方差在不同尺度上发生相变,为变分贝叶斯深度学习的不确定性量化提供理论指引。
阅读全文 →

·7 分钟
长程记忆的代价:序列模型中的状态、上下文与稳定性复杂度
一篇arXiv理论研究深入剖析序列模型处理长程记忆的资源代价,证明了状态数的平方对数复杂度定律、分数记忆的1/L上下文规律及临界性必要条件,并通过状态空间、门控循环与注意力模型实验验证。
阅读全文 →

