#前沿研究
共 6841 篇相关文章
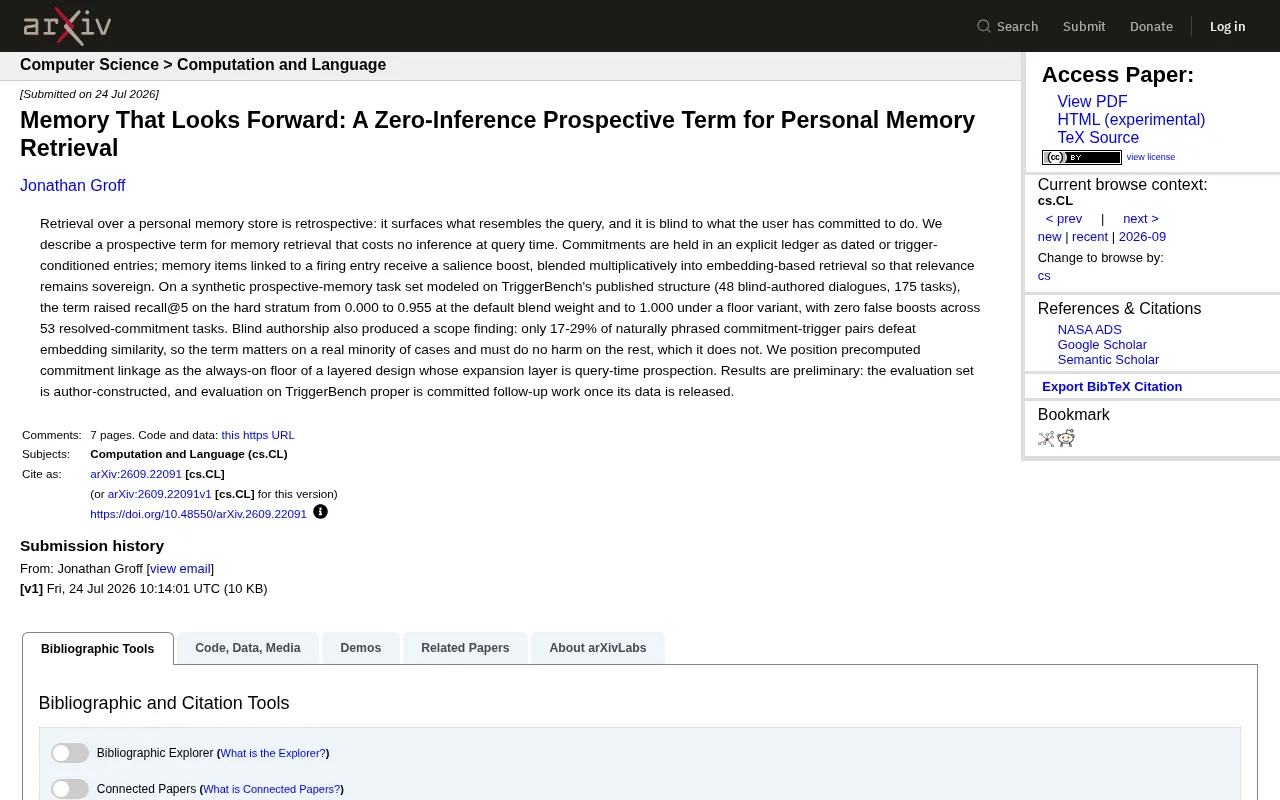
面向未来的记忆检索:零推理成本的前瞻性检索机制
arXiv新论文提出零推理成本的前瞻性记忆检索机制,通过承诺账本让个人记忆系统"看向未来",在困难任务上将recall@5从0提升至0.955,且零误报。
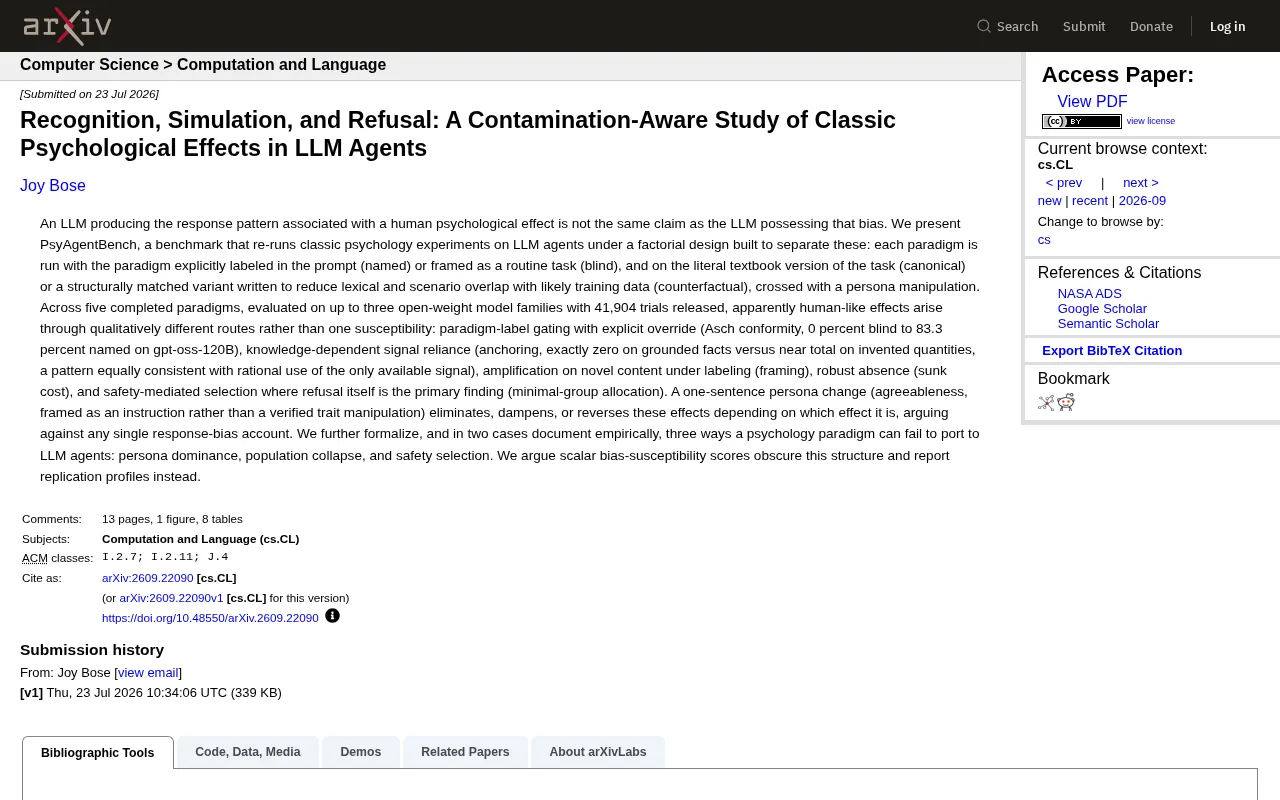
LLM真有认知偏差吗?PsyAgentBench揭示三种伪装路径
PsyAgentBench 通过 41,904 次实验重新检验 LLM 智能体的经典心理学效应,发现从众、锚定等类人偏差通过标签识别、知识依赖、安全拒绝等不同路径产生,而非单一易感性。研究警示标量偏差分数的误导性。
斯坦福的隐秘世界:一堂教你"统治世界"的课
18岁最年轻George Polk奖得主Theo Baker揭露斯坦福与硅谷"无边界关系"的黑幕:pre-idea融资、秘密课程"如何统治世界"、校长论文造假与被牺牲的学生,剖析下一代科技领袖如何被训练。
阿里云栖大会官宣通义千问Qwen 4,开源大模型再进化
阿里巴巴在云栖大会正式发布新一代开源大模型 Qwen 4(通义千问 4)。本文梳理 Qwen 系列演进脉络、开源生态意义及值得关注的后续信息。
科学的边界:当探索告诉我们无法知晓一切
科学是否在告诉我们无法知晓一切?本文从中世纪哲学家迈蒙尼德的不可知论出发,探讨科学、宗教与人类认知边界的交汇,反思探索的深层意义在于谦卑而非征服。
当AI智能体只想"聊天":Agent协作的通信瓶颈
AI智能体在多Agent协作中频繁"想要对话",带来上下文膨胀、延迟叠加和成本上升。本文分析智能体通信瓶颈的成因,并探讨从自由对话走向结构化协作协议的工程化路径。

NASA火星采样返回任务被取消:一场科学雄心的搁浅
NASA火星采样返回任务(MSR)被正式终结。这项旨在将毅力号采集的火星样本带回地球的宏大计划,因预算严重超支与技术复杂性而搁浅,引发科学界与技术社区广泛讨论。
Jev与System One模型:LLM的新形态"决策模型"
TypeSafe AI 推出 Jev,一种输出浮点数而非文本的新型 LLM——决策模型(System One)。本文解析其是非/选择/评分三类问题、极低价格、搜索重排等应用,以及黑盒偏见隐忧和开源复现浪潮。
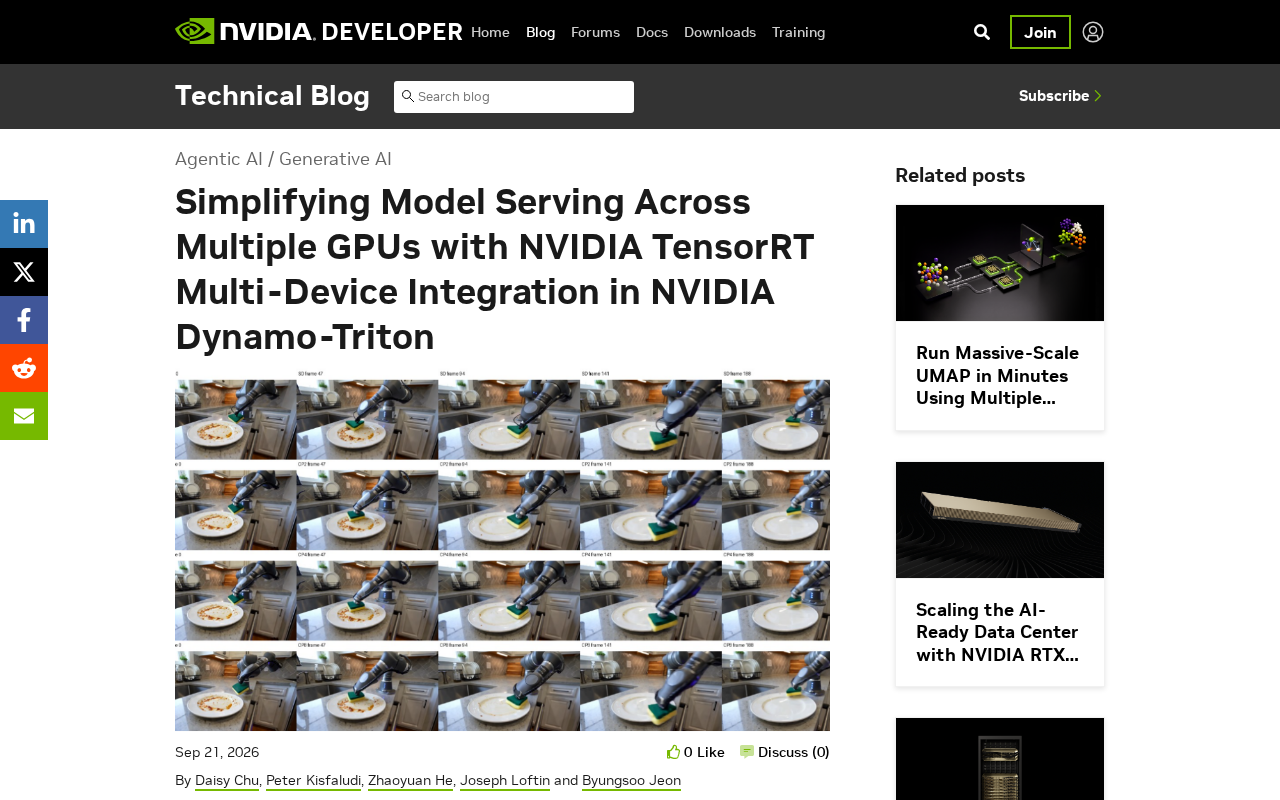
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。
数据本体论:AI智能体缺失的上下文层
数据本体论(Data Ontology)是AI智能体缺失的上下文层。本文解析它如何统一业务语义、消除数据歧义,让AI从猜测业务含义转向依据明确定义执行,是企业级AI落地的关键基础设施。
如何评估AI Agent:从工具调用到任务完成的全链路测评
AI Agent评估需要从工具调用到任务完成的全链路视角。本文解析Agent测评的两个核心层次,帮助团队判断Agent能否在真实环境中完成复杂连续任务。
OpenAI组建数学顾问团:AI已破解100多个未解难题
OpenAI组建数学顾问团,其AI系统已解决超过100个开放性数学难题。顾问团被明确定位为加速研究而非放缓,本文解析这一进展对AI推理能力与基础科学研究的深远意义。
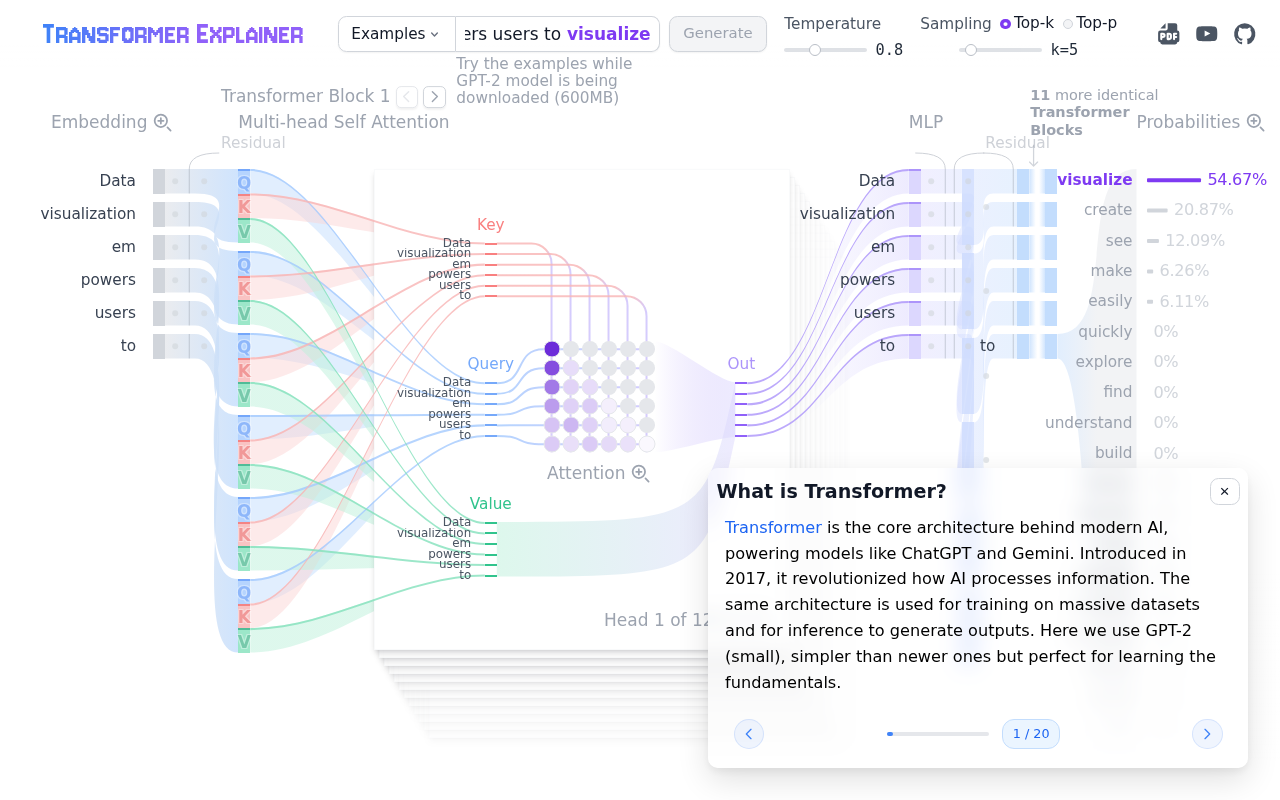
可视化理解Transformer:拆解大模型背后的核心架构
用可视化方式拆解Transformer架构,深入浅出讲解自注意力机制、多头注意力、位置编码与编码器-解码器结构,帮助AI学习者建立对大模型底层原理的直观理解。
TinyTorch:自己动手实现PyTorch,从张量到Transformer
TinyTorch 是一个免费开源的机器学习教学课程,引导你从零构建一个可运行的深度学习框架,覆盖从张量、自动微分到 Transformer 的完整链条。本文解析它的学习路径与价值,帮你从调库者变成真正理解框架原理的工程师。
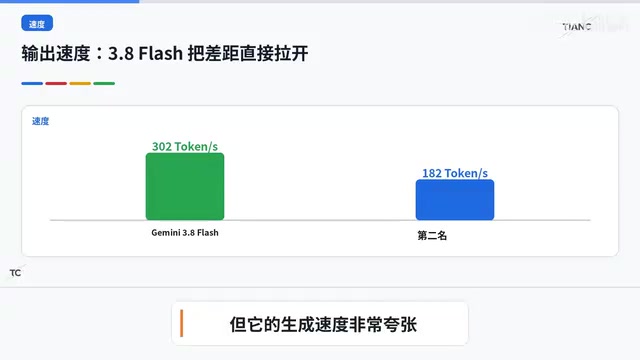
Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
Gemini 3.5 Pro延期难产,谷歌却疯狂迭代3.8 Flash。本文从智能、速度、单位任务成本与TPU算力能效角度,解析谷歌如何重新定义大模型战争,从军备竞赛转向工业竞赛。
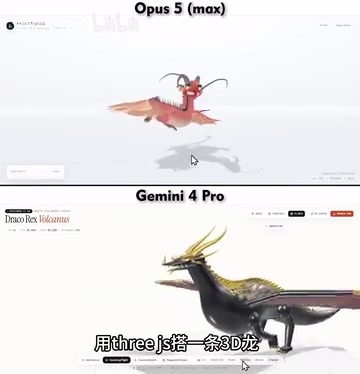
Gemini 4 Pro对决Opus 5 Max:Three.js建3D龙谁更强?
Gemini 4 Pro 与满血 Opus 5 Max 用同一条提示词、通过 Three.js 搭建 3D 龙的横向对比测试。结果显示未发布的 Gemini 4 Pro 竟能与满配 Opus 5 打成平手,本文解析这场 AI 编程能力对决的看点与意义。

AI能力在飙升,可靠性却停滞:被忽视的真正难题
AI能力持续飙升,但可靠性却停滞不前。基于普林斯顿HAL研究和Nature论文,本文探讨为何评测体系奖励自信错误、Agent从建议转向执行后的风险量级变化,以及生产环境中衡量AI可靠性的真正难题。
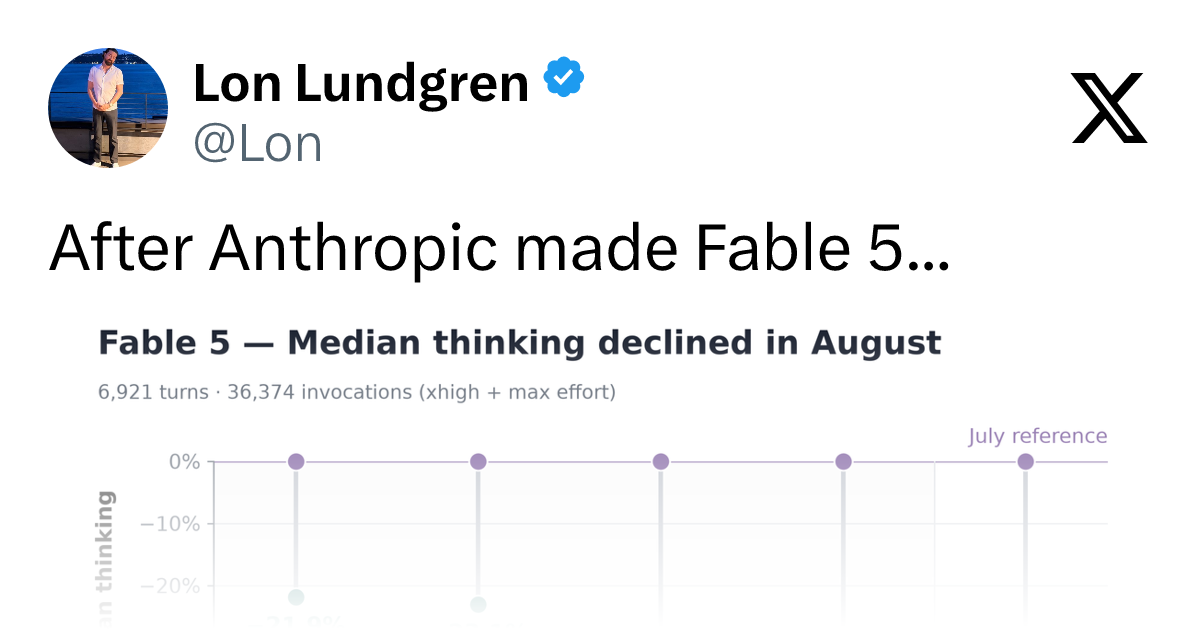
Fable 5引发热议:AI推理能力真的在下降吗?
Hacker News 热议话题「Fable 5」指出 AI 推理能力中位数在八月出现下滑,引发社区对大模型表现波动的讨论。本文分析模型退化的可能原因与第三方监测的价值。