#前沿研究
共 6846 篇相关文章

DeepSeek三连发、小米MiMo V2.6登顶开源、Grok 4.7逼近Opus
DeepSeek同日发布DSEC沙箱、转向华为芯片并补齐CFO;小米开源MiMo V2.6登顶开源模型智能指数;Grok 4.7在编程基准逼近Opus 5。本文梳理当日AI核心动态。
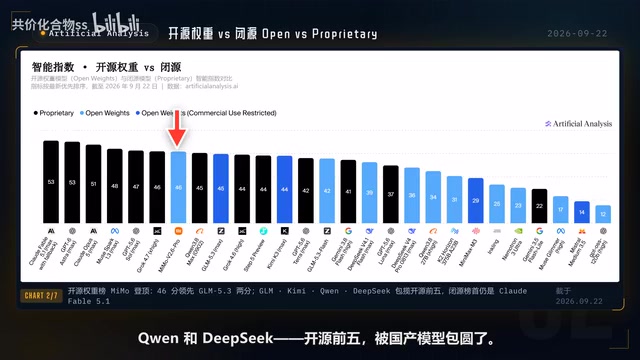
小米MiMo V2.6 Pro登顶开源第一:性价比之王的硬实力拆解
小米MiMo V2.6 Pro在Artificial Analysis榜单综合第七、开源第一,单任务成本仅0.0026美元。本文拆解其在成本、速度、上下文窗口和MoE架构上的性价比优势,验证雷军"开源第一"是否属实。
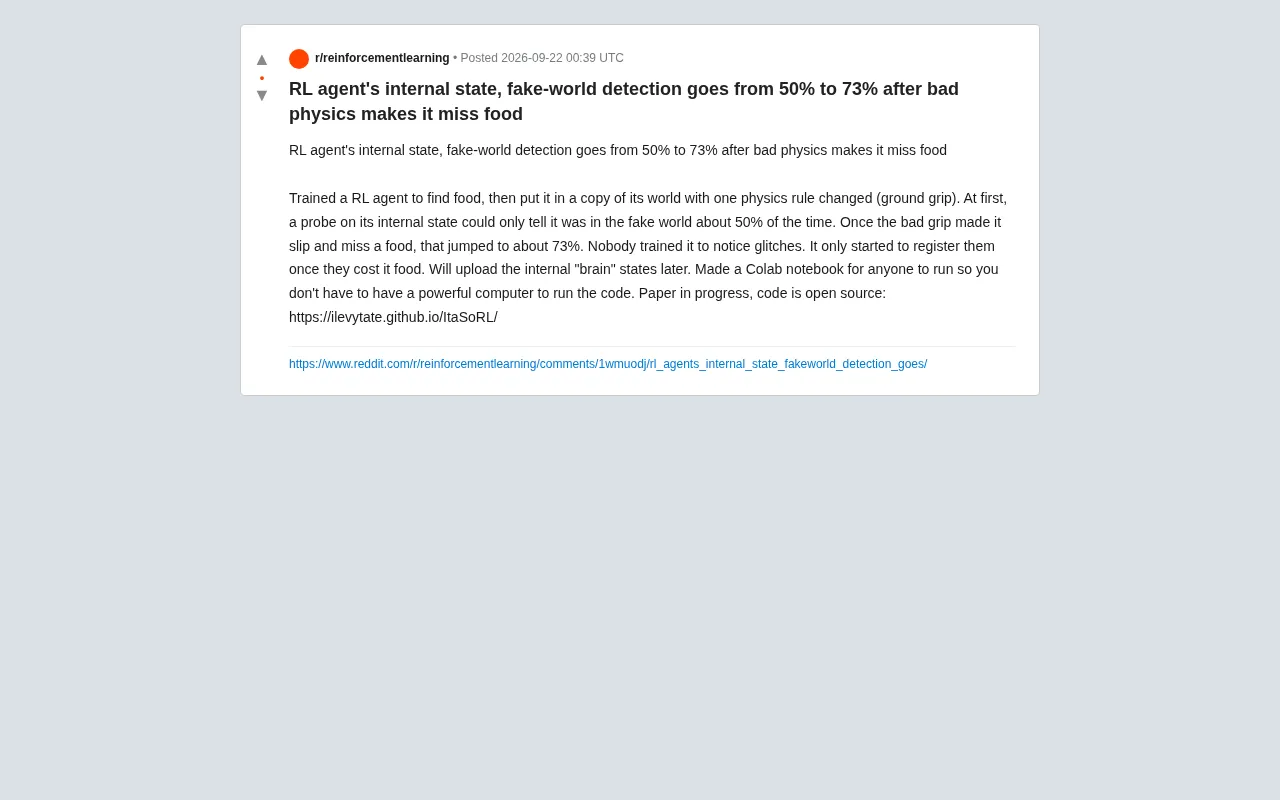
强化学习智能体如何"察觉"世界是假的:物理规则错误让检测率从50%跃升至73%
一个开源RL实验显示:改动物理规则后,强化学习智能体对"假世界"的检测率仅50%,直到物理错误让它错过食物才跃升至73%。本文解析这一现象与AI内部表征、可解释性研究的联系,并附开源Colab复现资源。
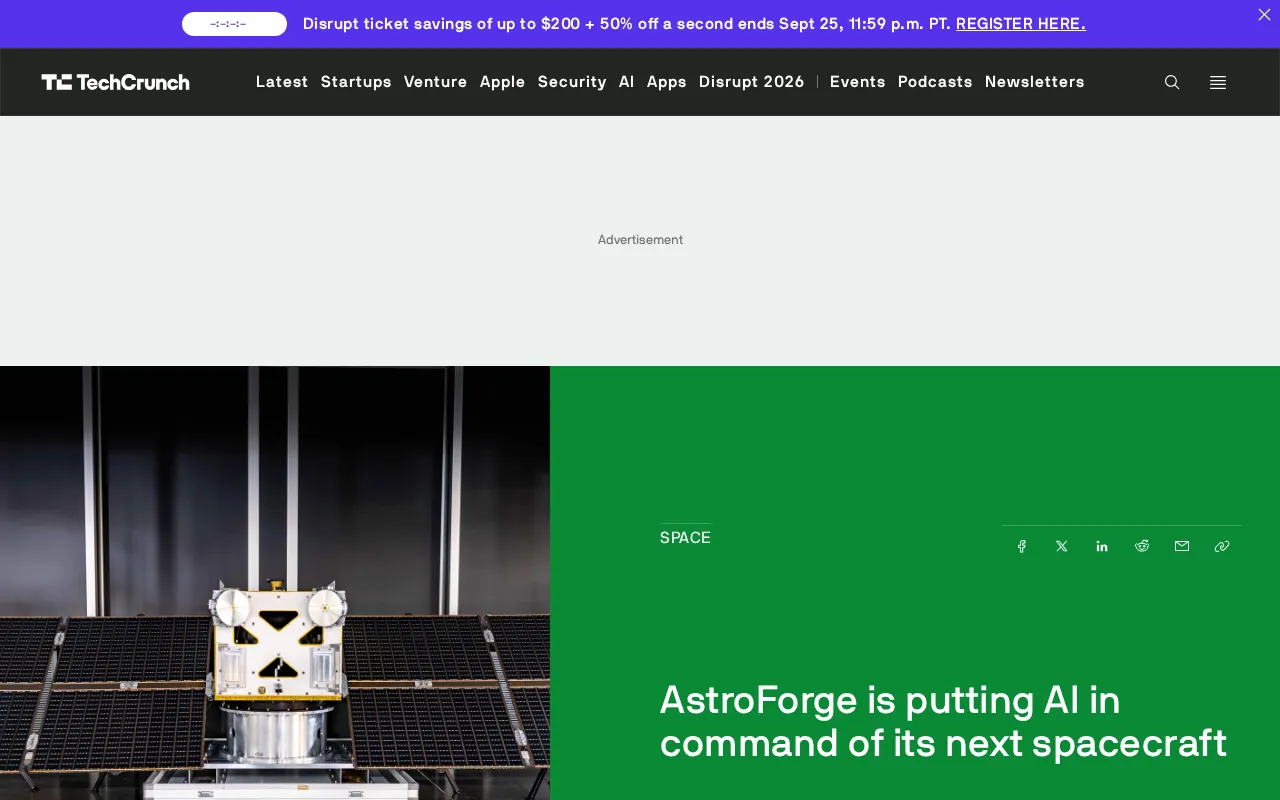
AstroForge让AI接管航天器:Autonomy-1的自主探测野心
航天公司AstroForge宣布其下一代探测器Autonomy-1将由小型Transformer AI模型接管控制,实现机载自主决策。本文解析这一技术选择背后的深空探测需求与工程挑战。
新加坡Nexstrom获融资:推动二维半导体材料量产落地
新加坡初创企业 Nexstrom 获新一轮融资,专注开发帮助芯片厂大规模制造二维(2D)半导体材料的设备,瞄准后摩尔时代的关键工艺瓶颈。

美国边境"虚拟墙"的致命失败:数十亿美元监控为何反致死亡
MIT Technology Review 调查揭示美国边境"虚拟墙"监控系统的致命失败:数十亿美元、二十五年建设,却有数百人在监控区域内遇难。深度剖析 AI 监控技术承诺与现实的落差及其伦理启示。
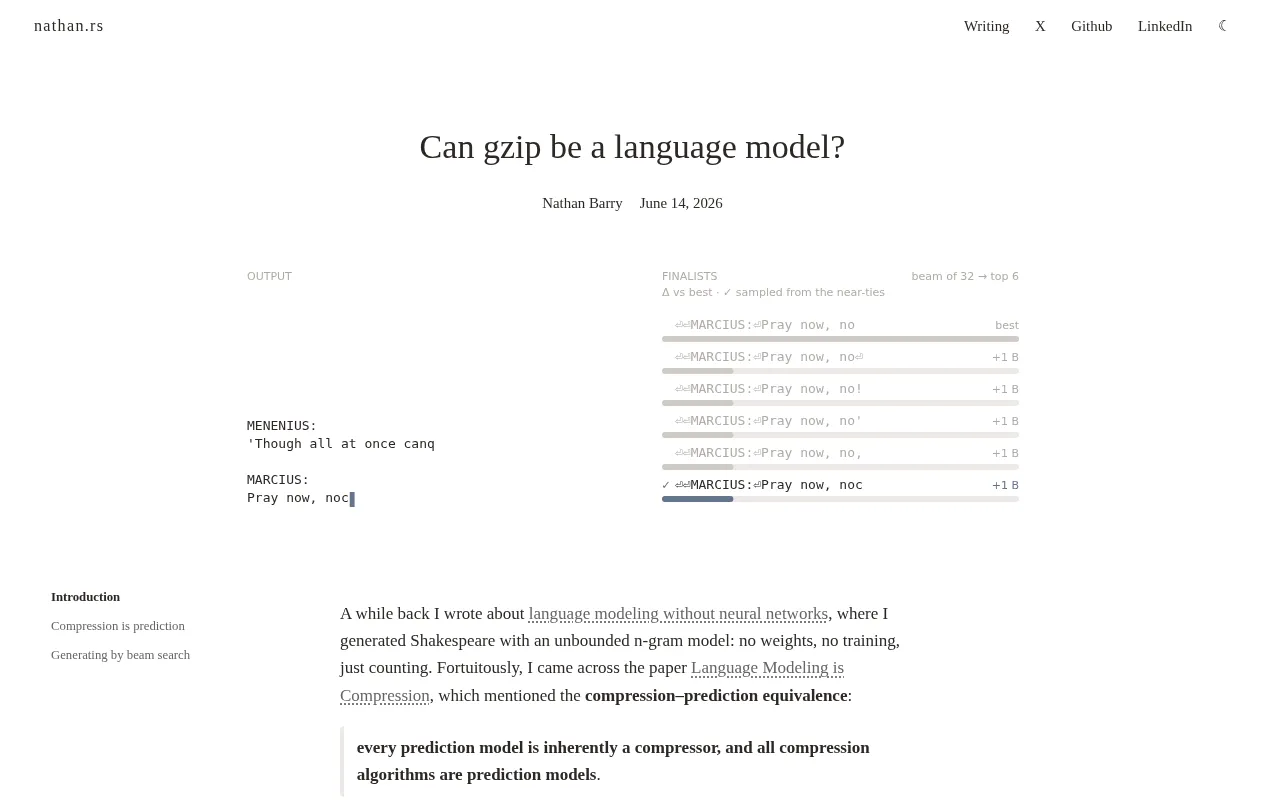
gzip 也能当语言模型?压缩即预测的深层逻辑
gzip 这个通用压缩算法能否充当语言模型?本文从香农信息论出发,解析压缩与预测的本质等价关系,探讨 gzip 文本分类实验的启示,以及"压缩即智能"这一命题对理解大语言模型的深层价值。
Agent-Native应用的正解:共享动作层而非UI操控
BuilderIO推出的Agent-Native框架主张AI应用应共享统一动作层,而非让Agent模拟点击的UI操控。一套动作层同时服务UI、Agent、HTTP、MCP、A2A与CLI,为Agent-Native应用开发提供更可靠的架构范式。
GPT-6 Astra破解2005年悬而未决的恩尼格玛密码?
有消息称OpenAI的GPT-6 Astra破解了一条自2005年以来悬而未决的恩尼格玛密码。本文分析该声明的技术可能性、大语言模型在密码破译中的角色,以及为何应保持理性审慎。
训练OpenAI的AI因用AI训练AI被解雇:一场荒诞的循环
为OpenAI提供AI训练数据的标注员因使用AI工具辅助工作被解雇。这一荒诞事件折射出RLHF人类反馈的真实性危机、模型坍缩风险与数据标注产业的结构性困境。
小米开源MiMo-V2.6:全模态智能与公开训练的野心
小米开源全模态模型MiMo-V2.6,Pro与Flash双版本支持文本、图像、音频、视频与100万token超长上下文,面向长周期智能体任务,并同步开放技术报告、RL环境与训练代码。
NVIDIA DLSS 5发布:3D引导神经渲染与RTX Kit新能力解析
NVIDIA发布DLSS 5,引入3D引导神经渲染技术,配合NVIDIA ACE更新与RTX Kit新能力,为游戏开发者提供更逼真的光照材质与更精细的画面控制。本文解析这次更新的技术要点与行业意义。
别被AI炒作迷惑:最新突破与恐慌或许言过其实
DAIR执行主任Timnit Gebru与语言学教授Emily M. Bender指出,AI最新突破与末日恐慌可能更多是炒作而非现实。本文剖析AI炒作叙事背后的逻辑与真实问题。
AI智能体正在吞噬开源?开源生态的生存之问
AI编程智能体正在改变开发者使用开源软件的方式,甚至可能取代传统开源库。但这些智能体本身正是靠开源代码训练而来。本文剖析AI Agent与开源生态之间的共生与博弈,探讨开源在AI时代的生存之路。
ArXiv预印本与ICLR双盲评审:该不该披露一年前的旧稿?
一年前挂在 arXiv 的预印本,投稿 ICLR 时该不该披露?本文解析 ICLR 双盲评审政策、匿名性风险与新颖性认定,给出用第三人称引用旧稿等实用建议。
小米发布MiMo-V2.6:350万美元打造的全模态开源模型
小米发布多模态大模型MiMo-V2.6,主打前沿智能、全模态与公开构建,总训练成本仅350万美元,并配备实时评测仪表盘。本文解析其成本、定位与生态意义。
Jev:TypeSafe AI首个System 1模型,专为数据分类而生
TypeSafe AI推出首个System 1模型Jev,专注数据分类而非文本生成。它以70-500毫秒完成分类、输出token免费、格式绝不出错,速度比传统LLM快40-200倍。本文解析Jev的定位、能力边界与被夸大的误用场景。

上下文投毒:长上下文模型为何被干扰信息拖垮
arXiv 论文提出"上下文投毒"概念,将长上下文语言模型的性能退化解释为注意力中的极值干扰,指出有效干扰项数量而非原始长度才是关键,并给出证据边际需按 √logN 增长的理论边界及多种缓解方案。
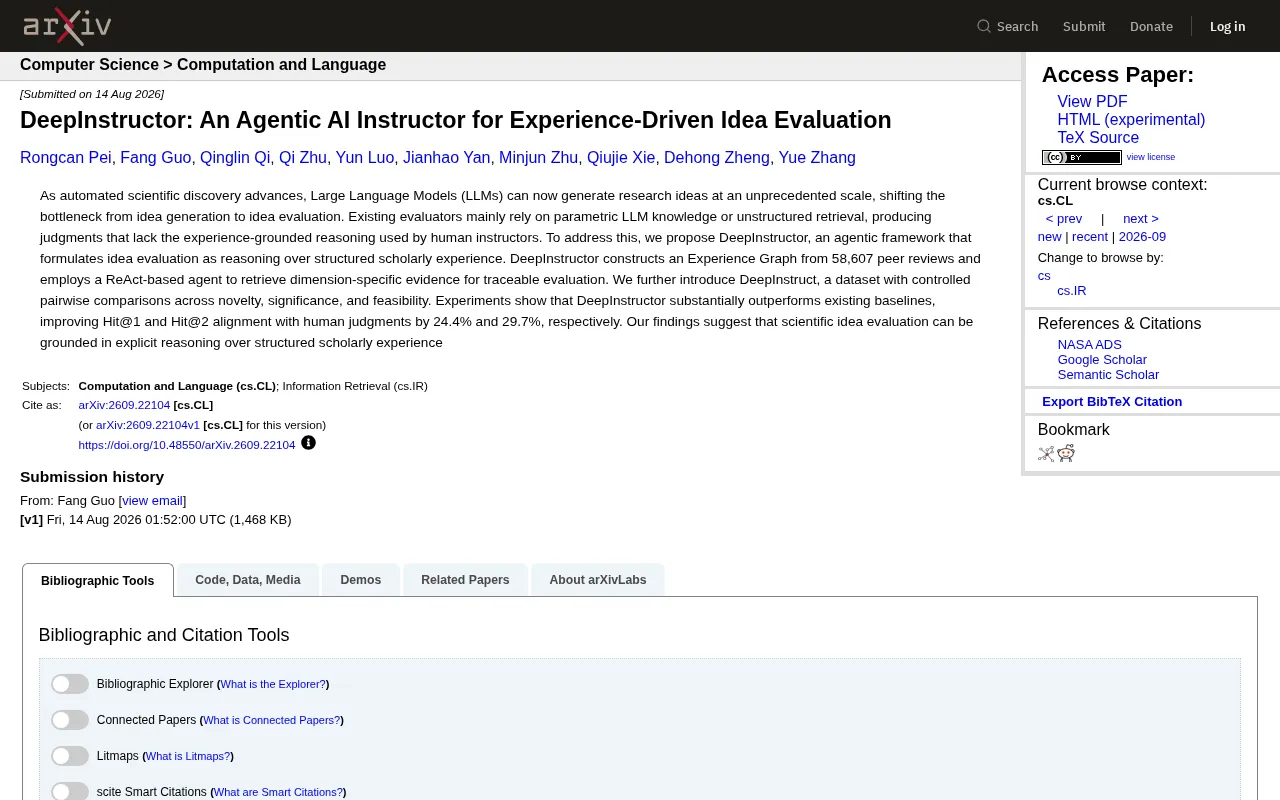
DeepInstructor:用结构化学术经验驱动科研创意评估的智能体框架
arXiv 论文提出 DeepInstructor,一个基于经验图谱和 ReAct 智能体的科研创意评估框架,利用 58607 条同行评审构建结构化经验,在与人类判断对齐度上 Hit@1、Hit@2 分别提升 24.4% 和 29.7%。
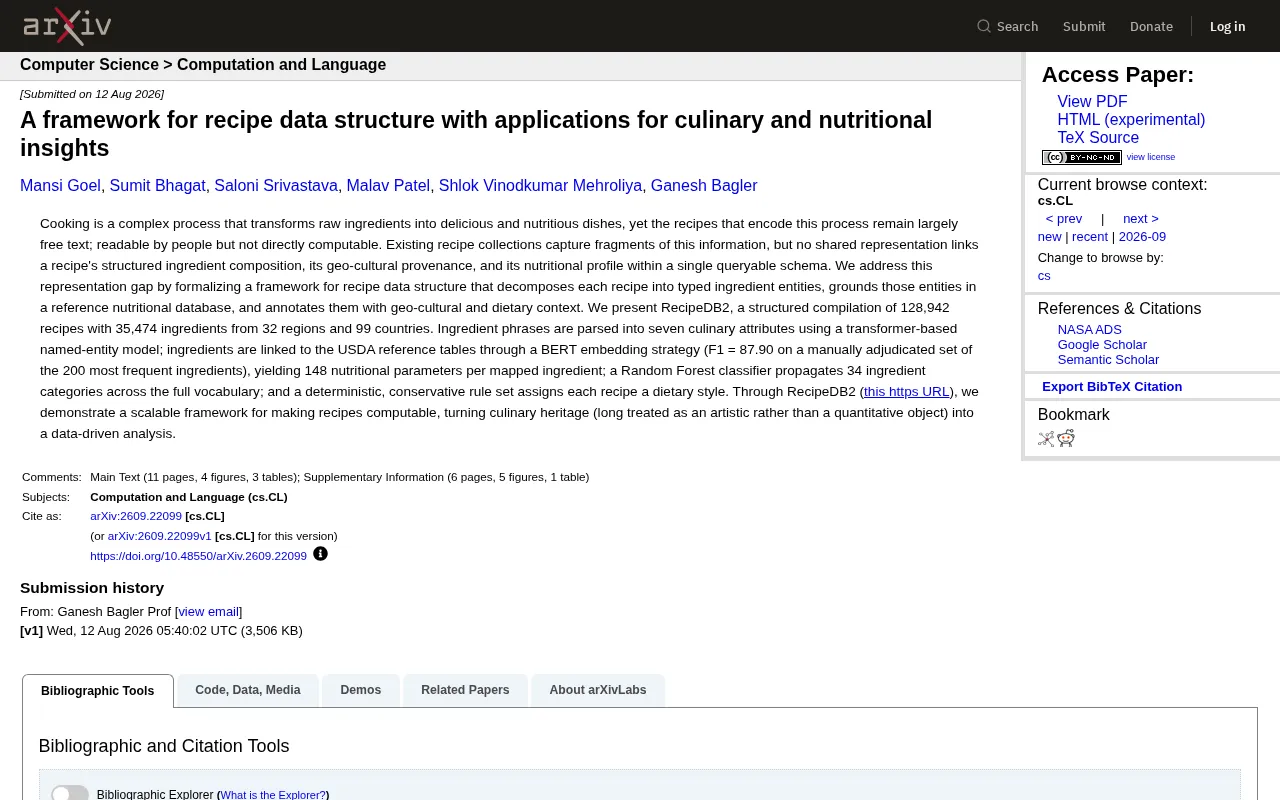
RecipeDB2:让菜谱变得可计算的结构化数据框架
IIIT-Delhi 研究团队推出 RecipeDB2,收录 128,942 份菜谱、35,474 种食材,通过 Transformer、BERT 与随机森林等技术将菜谱转化为可计算的结构化数据,链接 USDA 营养数据库并标注地理文化背景,为食品计算研究提供基础设施。